

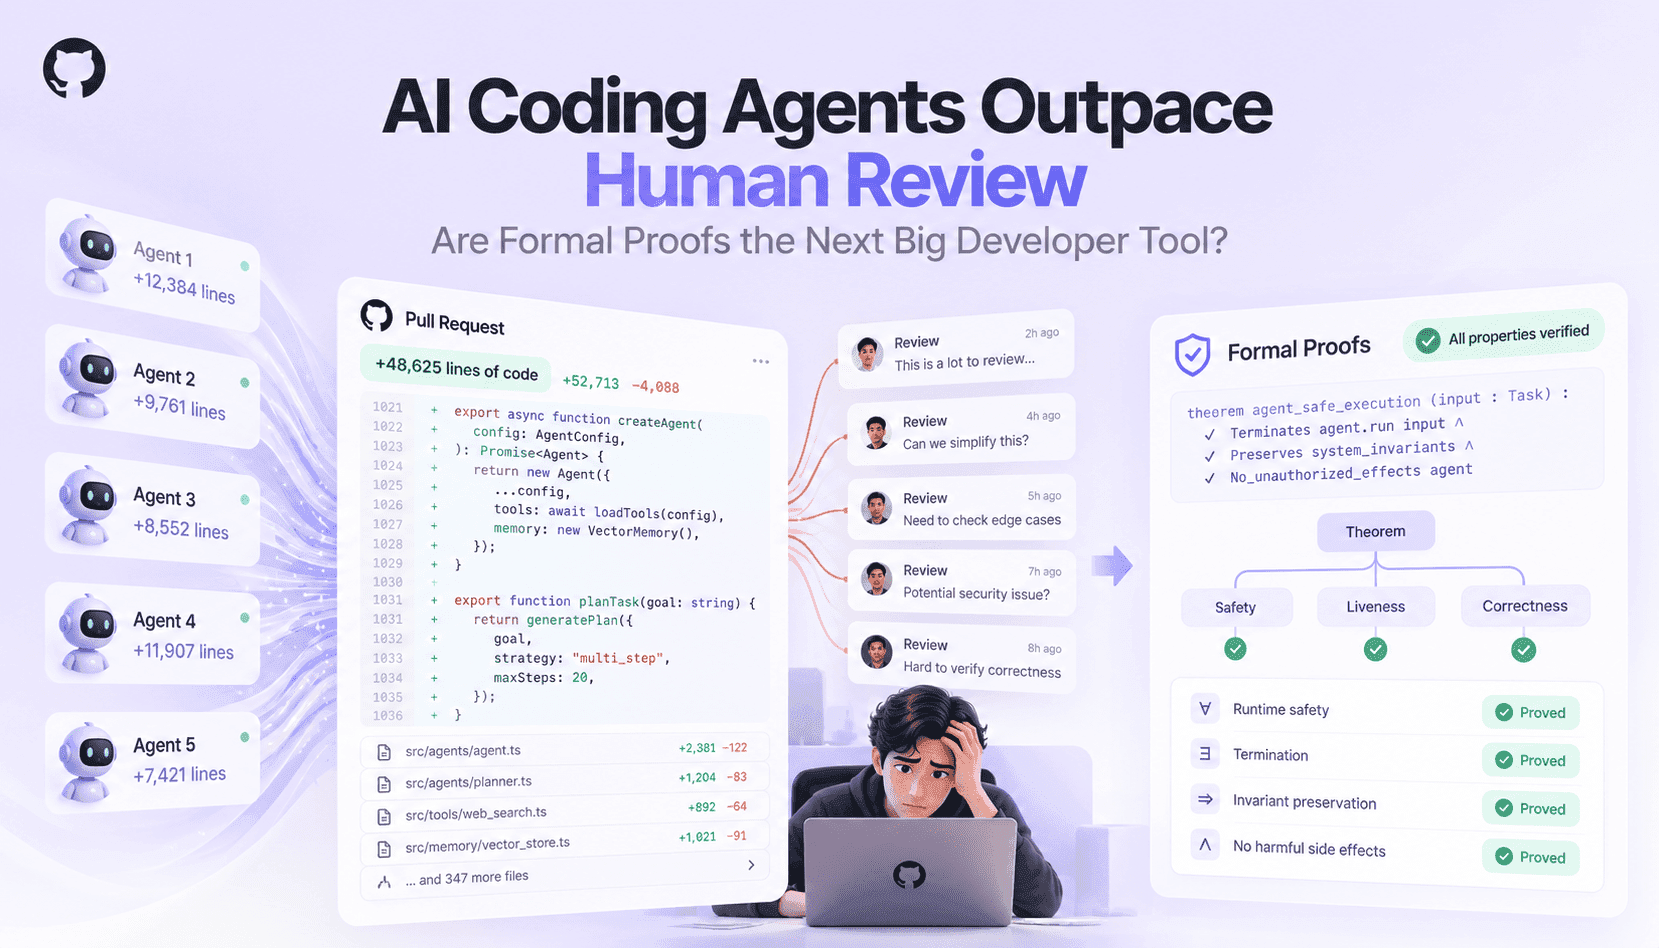
L’essor des agents capables d’écrire du code — des dérivés de Copilot aux flux de travail autonomes — a changé le rythme de l’ingénierie logicielle. Là où une équipe examinait autrefois quelques demandes de fusion rédigées par des humains chaque jour, beaucoup reçoivent désormais des flux de correctifs, de structures de base et de nouveaux modules générés automatiquement. Cette abondance accélère la livraison de fonctionnalités, mais entraîne aussi un arriéré de vérification : les personnes chargées des revues sont une ressource limitée, et les contrôles légers (mise en forme, linters, revue superficielle) ne peuvent pas suivre la cadence. Cet écart opérationnel contribue à la hausse des incidents, des régressions de configuration et des erreurs de paramétrage de sécurité dans les pipelines enrichis par des agents.
Les différentes techniques de vérification détectent des types de défaillances différents. Les tests unitaires et d’intégration valident le comportement pour des entrées spécifiées ; l’analyse statique repère les problèmes de types et de flux, ainsi que certains usages incorrects d’API ; la revue de code assistée par l’IA signale les problèmes de style et les bogues probables ; la vérification formelle prouve des propriétés pour toutes les entrées possibles, à condition de disposer d’une spécification précise. Aucune de ces méthodes n’est une solution miracle. Les tests passent à côté des cas limites qui ne figurent pas parmi les entrées choisies. L’analyse statique génère des faux positifs et peine avec les constructions dynamiques. Les modèles d’IA peuvent halluciner, ce qui fragilise la revue. Les preuves formelles demandent un investissement initial et supposent des spécifications claires, ainsi qu’une structure de code souvent contrainte.
Les recherches de Microsoft sur le développement piloté par les preuves montrent comment intégrer pragmatiquement les méthodes formelles aux flux de travail des développeurs : en ciblant les modules critiques et en dérivant des preuves à partir de spécifications exécutables, les équipes peuvent éliminer des catégories entières d’erreurs logiques et de concurrence que les tests ne détectent pas. GitHub AI Scan et les plateformes d’analyse similaires offrent une détection continue et évolutive des vulnérabilités connues et des dépendances à risque. Ensemble, ces approches plaident en faveur d’une stratégie hybride : utiliser les outils automatisés, probabilistes et déterministes là où ils sont les plus efficaces, et réserver les méthodes formelles, coûteuses mais décisives, au code présentant les risques les plus élevés.
Pour les équipes qui utilisent Claude Code, Codex, GitHub Copilot ou des flux de travail agentiques, la question pratique est de savoir comment combiner ces outils dans un pipeline opérationnel qui préserve la productivité des agents tout en maîtrisant les défauts et les vulnérabilités. La suite de cet article compare les méthodes de vérification, formule des recommandations ciblées sur les situations où recourir aux preuves formelles et propose un flux de travail par étapes associant génération automatisée, tests en environnement isolé, preuves progressives et jugement humain. L’objectif : faire évoluer la vérification au même rythme que la production de code, plutôt que d’augmenter les effectifs chargés des revues.