

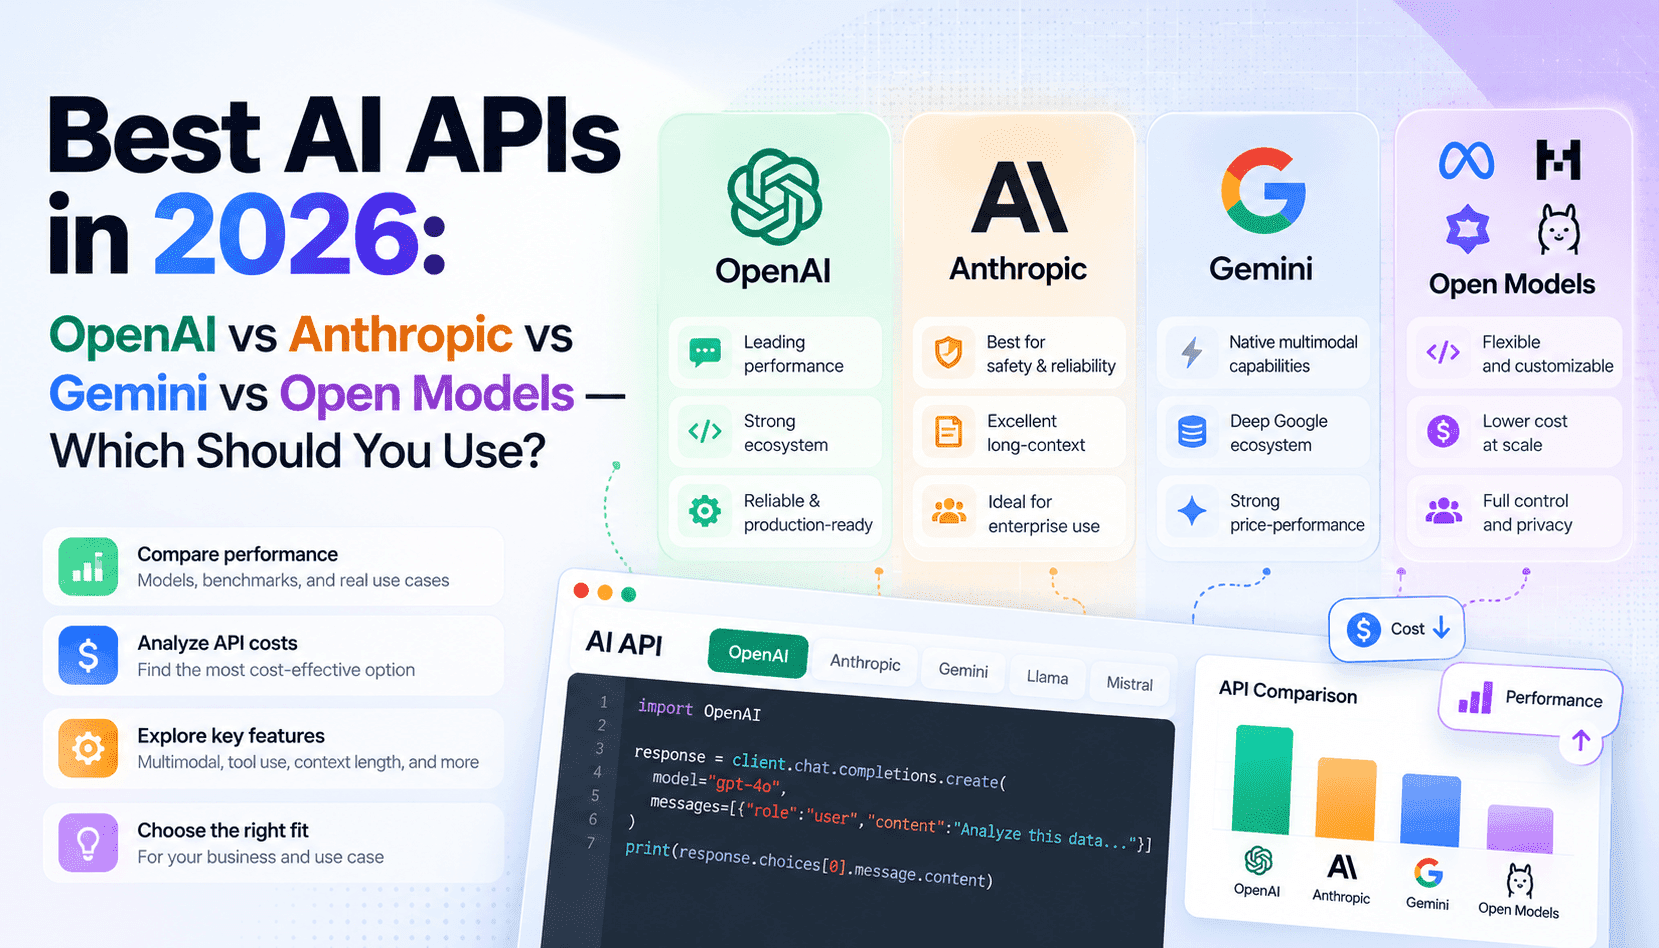
Choisir une API d’IA en 2026 revient moins à désigner un vainqueur qu’à faire correspondre les charges de travail aux coûts et aux capacités qui comptent pour votre produit. Le marché se répartit désormais en plusieurs catégories concrètes : les API propriétaires proposant des modèles performants mis à jour en continu (OpenAI, Anthropic, Gemini), les grands modèles à poids ouverts que vous pouvez héberger vous-même pour mieux maîtriser vos données et votre environnement, et les passerelles multi-modèles qui répartissent les requêtes entre fournisseurs afin d’optimiser les coûts et les capacités. Chaque option implique des efforts différents en matière d’ingénierie, de conformité et d’exploitation. Le bon choix dépend de vos objectifs de latence, de vos exigences concernant les données et de l’importance que vous accordez à la détermination des résultats ou à la qualité du raisonnement.
Pour un acheteur technique, l’évaluation doit s’appuyer sur des critères précis et des expérimentations ciblées. Lancez de petits tests représentatifs : des tâches de raisonnement avec quelques exemples pour la logique produit, de vrais cas de réécriture de code pour les outils de développement, des prompts multimodaux pour les flux de traitement de documents et d’images, ainsi que des tests de sortie structurée pour l’intégration aux bases de données. Mesurez non seulement la qualité, mais aussi le coût par jeton utile, la latence P95 pour les traitements synchrones, le débit en lot pour les tâches hors ligne et les modes de défaillance lorsque le réseau se dégrade. Combinez ces indicateurs pour établir un « seuil d’acceptation » par charge de travail, puis choisissez le fournisseur le moins coûteux qui respecte votre SLA.
Les considérations opérationnelles comptent autant que la précision du modèle. La dépendance à un fournisseur s’installe souvent discrètement : intégrations propriétaires, sémantique particulière des appels de fonctions ou fonctionnalités d’audit fermées peuvent accélérer les premières livraisons, mais compliquer les migrations futures. Les modèles à poids ouverts offrent un contrôle maximal sur la résidence des données et le coût d’inférence, mais confient à vos équipes d’infrastructure la mise à l’échelle, l’application des correctifs de sécurité et la fiabilité. Les passerelles multi-modèles et les routeurs de modèles ajoutent une couche d’abstraction et de la complexité, mais permettent d’associer des modèles de base économiques à un modèle de secours de grande qualité, pour équilibrer les coûts unitaires immédiats et les dépenses d’ingénierie à long terme.
Cet article présente une matrice de décision pragmatique, des scénarios de déploiement et un guide opérationnel — routage des modèles, stratégies de secours, indicateurs d’observabilité et suivi des coûts — afin d’aider les équipes à adopter une architecture modulaire. L’objectif n’est pas de recommander un fournisseur unique, mais de proposer une méthode reproductible : définir les besoins de chaque charge de travail, mener des évaluations ciblées, choisir l’architecture la plus simple qui y répond et concevoir votre infrastructure de façon à pouvoir changer de fournisseur par un simple réglage opérationnel, plutôt qu’au prix d’une refonte coûteuse.