

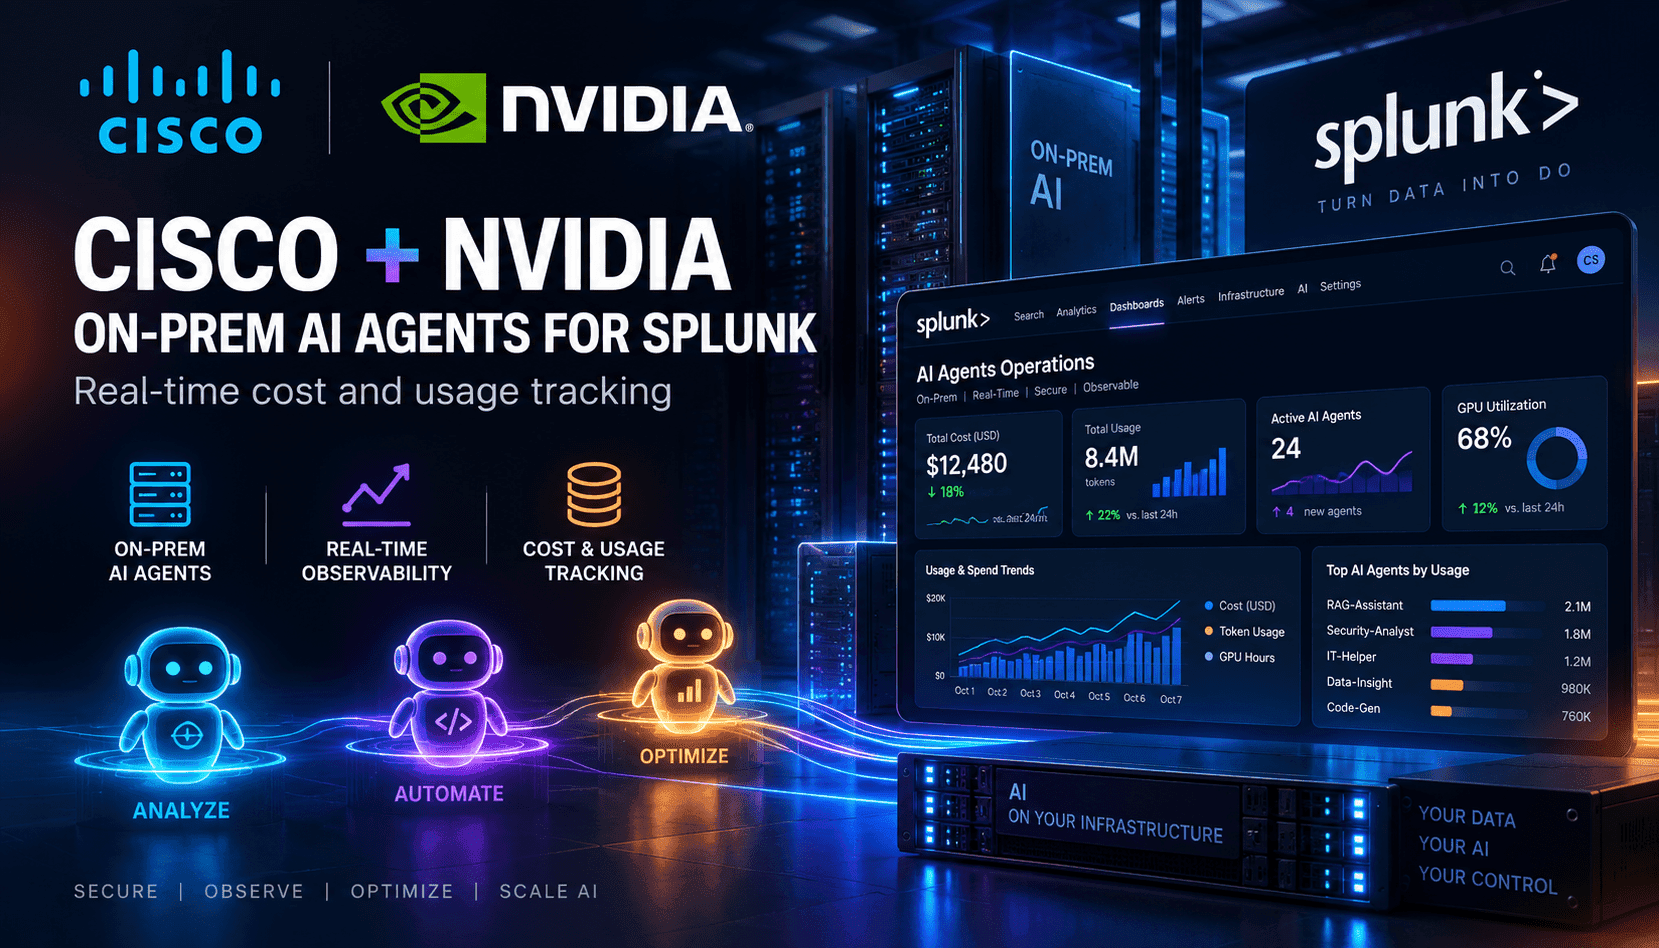
Les entreprises qui centralisent la télémétrie dans Splunk ont longtemps dû faire un compromis : conserver les données sur site pour la souveraineté et la sécurité, ou les déplacer vers le cloud pour accéder aux agents IA modernes. Le nouveau AI POD de Cisco pour Splunk, basé sur un calcul accéléré par NVIDIA et un runtime Kubernetes, comble cette lacune. Il permet aux équipes d’exécuter l’Assistant IA de Splunk et un Agent Launchpad émergent juste à côté de leurs journaux et métriques, tout en hébergeant elles-mêmes un mélange de modèles ouverts et propriétaires. La pile pré-validée réduit les risques d’intégration et le délai de mise en valeur, offrant aux équipes opérationnelles et de sécurité un substrat d’agent qu’elles peuvent renforcer avec les mêmes contrôles qu’elles utilisent déjà pour leur parc d’observabilité.
Le changement opérationnel majeur réside dans la visibilité des coûts et des comportements. La fonctionnalité Tokenomics de Splunk Agent Observability suit la dépense de jetons par agent, utilisateur et flux de travail — y compris les agents de codage comme Claude Code, Codex ou Cursor — permettant aux responsables de relier l’adoption à la valeur, et non aux anecdotes. Elle prévoit la consommation grâce à la modélisation en séries temporelles, alerte sur les boucles infinies et attribue les coûts aux unités commerciales. Comme la même plateforme inspecte les invites, réponses et appels d’outils, les équipes peuvent appliquer des garde-fous en temps réel pour bloquer les actions non sécurisées et limiter les hallucinations. En pratique, cela signifie que vous pouvez définir des budgets, prévenir la surconsommation en temps réel et prouver le ROI avec des économies unitaires plutôt qu’avec des surprises en fin de mois.
Stratégiquement, cette architecture accélère la transition des pilotes vers un tissu d’agents gouverné. En rapprochant l’exécution des modèles des données, les entreprises évitent les chemins ETL fragiles et réduisent l’exposition à l’exfiltration. Le choix des modèles reste flexible : les équipes peuvent exécuter des options open-weight comme la famille Nemotron de NVIDIA aux côtés de modèles spécifiques au domaine comme le Deep Time Series Model de Cisco pour les prévisions. Le compromis est la maturité opérationnelle — Kubernetes, la planification GPU, l’évaluation des modèles et la gestion des risques des invites doivent être traités comme des disciplines de premier ordre. Pour les acheteurs, la question évolue de « Pouvons-nous utiliser l’IA ici ? » à « Quels agents justifient leur coût, sur quel matériel et sous quels garde-fous ? » Les organisations qui répondront précisément à cette question évolueront plus rapidement avec moins de réécritures.