

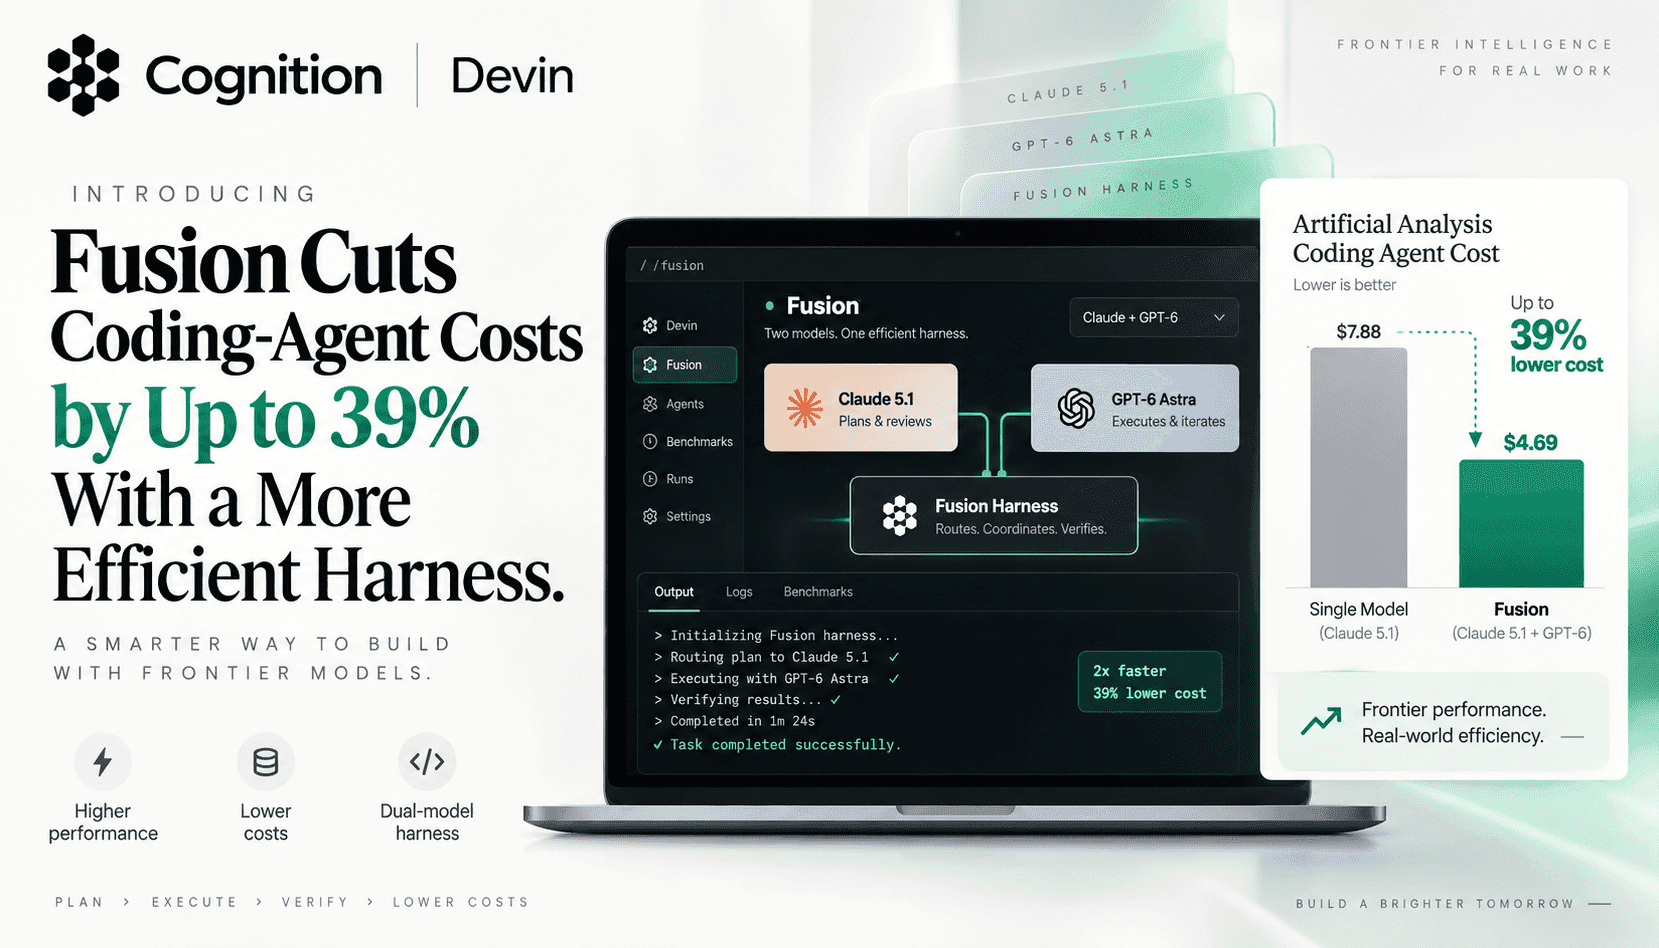
Fusion est un harnais à deux agents conçu pour le travail de codage : un modèle lead de pointe planifie et révise ; un sidekick moins coûteux exécute. Plutôt que de faire transiter des conversations entières entre modèles, le duo échange des briefs structurés et des résultats tout en construisant chacun son propre contexte persistant. Cette séparation est cruciale. Changer de modèle en plein fil de discussion détruit souvent les caches et entraîne des reprises. Avec Fusion, la délégation basée sur des briefs maintient le contexte stable, permet au sidekick d’avancer rapidement dans l’implémentation, et réserve le raisonnement coûteux aux points de contrôle du lead. Le résultat, selon les benchmarks rapportés, est une qualité de niveau frontier à un coût nettement inférieur — surtout sur des tâches où l’exécution constante domine le budget en tokens.
Le changement stratégique passe de la sélection de modèle à la qualité de l’orchestration. Le prix par token sous-estime la réalité : de meilleurs planificateurs rédigent des briefs plus précis, nécessitent moins de tentatives, et minimisent les allers-retours entre lead et sidekick. En pratique, un lead plus performant (parfois plus coûteux) peut rendre le système moins cher en déléguant plus tôt et en révisant moins. De même, un sidekick plus capable peut coûter plus par token mais réduire le nombre total de tours en réalisant correctement les implémentations du premier coup. C’est pourquoi les affirmations de Fusion résonnent : elles concrétisent une approche prix par tâche, harmonisant planification, exécution et révision dans un flux de travail qui protège les caches et limite le turnover.
Pour les acheteurs, cela redéfinit les listes de contrôle d’évaluation. Les benchmarks restent importants, mais les questions clés portent désormais sur la politique du harnais : comment les plans sont formés, ce qui est délégué, la fréquence des révisions par le lead, et la gestion des erreurs. Les équipes testant des leads de type Astra ou Claude doivent mesurer coût, temps et qualité au niveau des tâches, et instrumenter où les tokens et tours se répartissent réellement dans les phases — planification, préparation, implémentation, débogage, validation, clôture. Si la majorité des coûts se concentre sur l’implémentation et le débogage, un harnais à deux agents avec contexte persistant et mise en cache des prompts surpassera probablement un routage naïf ou des boucles à modèle unique.
L’adoption n’est pas sans effort. Les briefs de délégation doivent être adaptés à la paire choisie ; l’autonomie du sidekick doit évoluer avec ses capacités ; et l’exploration qui façonne le plan doit généralement rester avec le lead, sauf si le sidekick est suffisamment compétent pour éviter les mauvaises interprétations. Les organisations auront aussi besoin de gouvernance : points de contrôle de révision traçables, exécutions reproductibles à travers les caches, et garde-fous pour empêcher le sidekick de dépasser ses outils ou permissions. Mais les bénéfices sont convaincants : un canal de planification stable qui concentre l’intelligence de pointe là où elle est rentable, et un canal d’exécution qui transforme rapidement les modifications de code sans réveiller sans cesse un cerveau coûteux.