

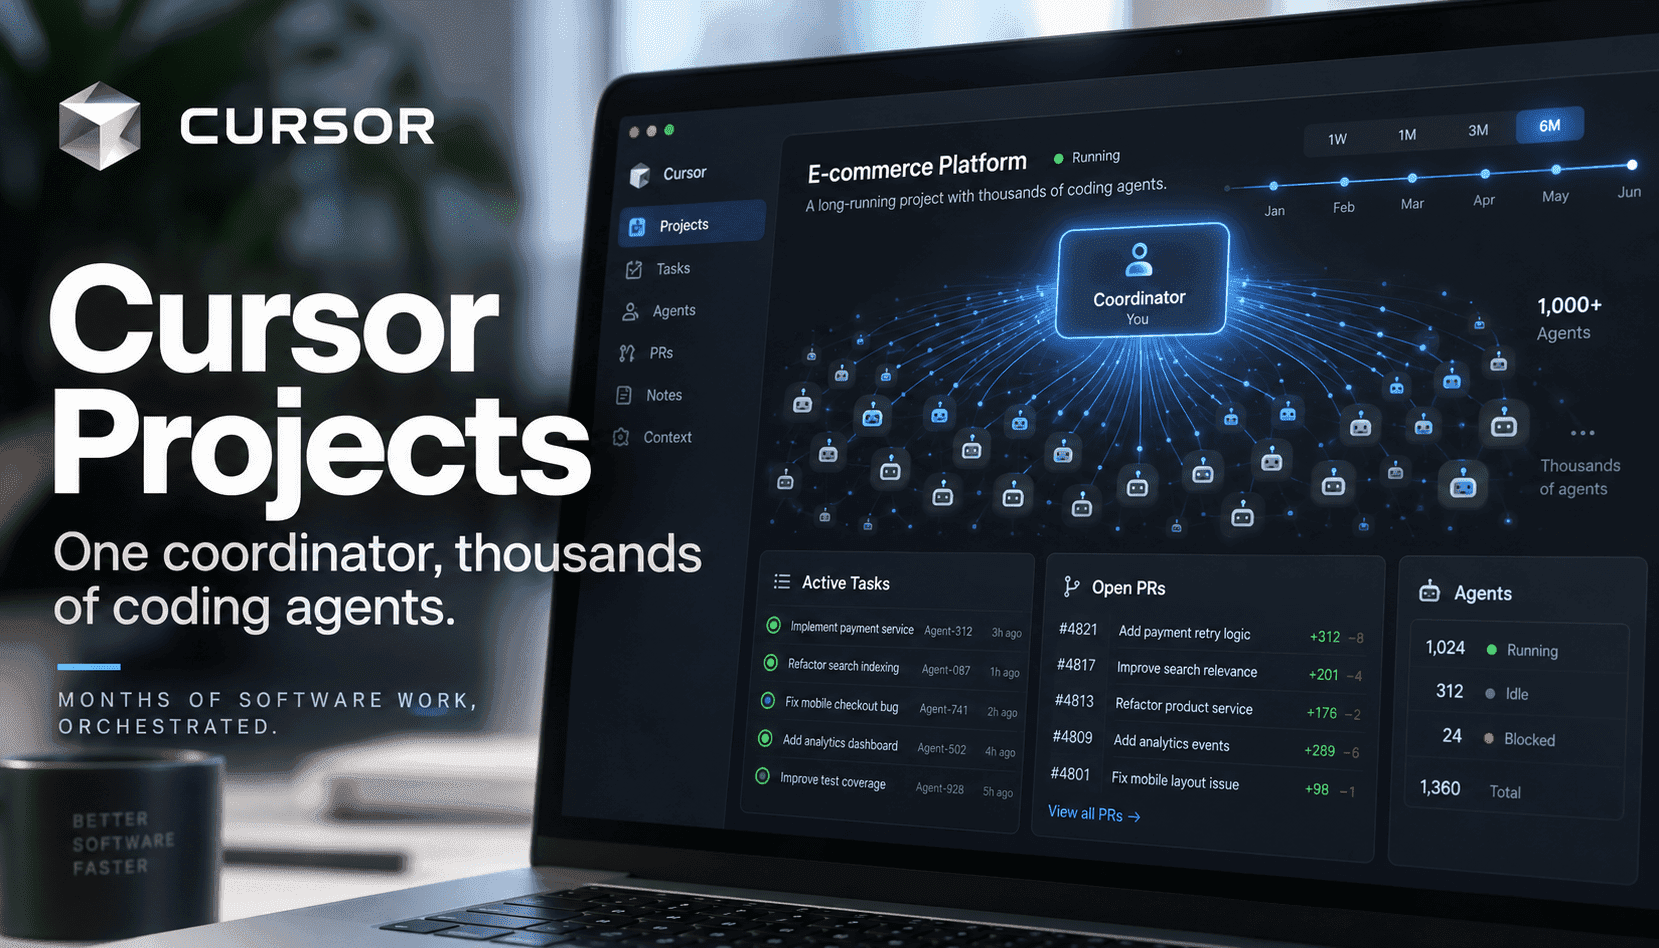
Projects de Cursor apporte une amélioration structurelle au développement agentique : un coordinateur orchestre des milliers d'agents de codage sur plusieurs semaines ou mois, conservant l'état et le contexte à mesure que le travail évolue. Il fonctionne par défaut dans le cloud pour le parallélisme et lance des agents locaux lorsque la parité matérielle ou environnementale est importante. Une couche de contexte partagé accumule artefacts, notes d'architecture et préférences d'équipe afin que les nouveaux arrivants — humains ou agents — commencent avec un savoir institutionnel plutôt qu'une page blanche. Les abonnements permettent au coordinateur d'agir sur des signaux tels que l'ouverture de PR, les échecs CI ou les rapports Slack, transformant les sollicitations intermittentes en opérations continues. C'est, en pratique, un plan de contrôle de production pour le travail de code.
Pourquoi c'est important : le débit et les taux d'achèvement. Le travail sur les fonctionnalités peut avancer en parallèle sur plusieurs composants tandis que le coordinateur gère les dépendances. Les migrations qui stagnent habituellement à 70 % peuvent être menées à terme via des PR incrémentales avec des seuils de revue progressivement assouplis. Les tâches de « jardinage » — hygiène du système de design, déploiement des règles de lint, tri des tests instables — deviennent des travaux autonomes en arrière-plan. Cursor rapporte des gains significatifs en PR fusionnées pour les équipes utilisant Projects ; quelle que soit la valeur exacte dans votre organisation, le schéma est clair : coordination persistante plus contexte partagé se cumulent. Le risque est un volume non maîtrisé — sans politique, vous échangerez vitesse contre fatigue de revue et qualité probabiliste.
La question de l'acheteur passe de « un agent peut-il coder ? » à « pouvons-nous gérer une flotte d'agents sûre et mesurable ? » Cela signifie être prêt sur la fiabilité CI, la couverture des tests, les protections de branches et l'hygiène des secrets. Cela signifie aussi industrialiser le backlog : définir des modèles de migration, des seuils de revue et des plans de rollback ; mesurer le parallélisme pour protéger les réviseurs ; et suivre le ROI avec le temps de cycle PR, la récupération des échecs et les taux d'échappement de défauts. Attendez-vous à une courbe en S : humain en boucle au début, autonomie encadrée en phase intermédiaire, puis automatisation stable avec supervision ciblée. Achetez-le comme une infrastructure, gérez-le comme du DevOps et équipez-le comme une fonction de fiabilité — pas comme une expérience de chat.