

NexusAi logo

NexusAi

  • Produits
  • Catégorie
  • Prompts
  • Recherche
  • Aperçus
  • Tarifs
  • Promouvoir
  • Contact
Se connecter
NexusAi LogoNexusAi

NexusAI vous aide à découvrir, comparer et apprendre à utiliser les outils d'IA en toute simplicité. Des conseils d'experts aux ressources de formation, nous permettons aux individus et aux entreprises d'exploiter la technologie de l'IA pour des décisions plus intelligentes, l'innovation et la croissance.

Liens utiles

  • À propos de nous
  • Produits d'IA
  • Catégories d'IA
  • Prompts d'IA
  • Recherche IA
  • NexusAI Insights

Services et Mentions légales

  • Vitrine et Promotion
  • Offres d'abonnement
  • Conditions générales
  • Politique de remboursement
  • Politique de confidentialité
  • Avis de non-responsabilité

Contactez-nous

88 Tribune Street
South Brisbane, QLD, Australie, 4101
Site web: www.nexusai-tech.com
E-mail: info@nexusai-tech.com

© Copyright 2026 NexusAi Tous droits réservés

Développé par DStudio Technology
Accueil/Aperçu IA/Actualités des Produits IA/L’IA SRE nightshift d’Elastic : un agent autonome qui enquête sur les incidents pendant que les équipes dorment
Actualités des Produits IAInfrastructure d’agents

L’IA SRE nightshift d’Elastic : un agent autonome qui enquête sur les incidents pendant que les équipes dorment

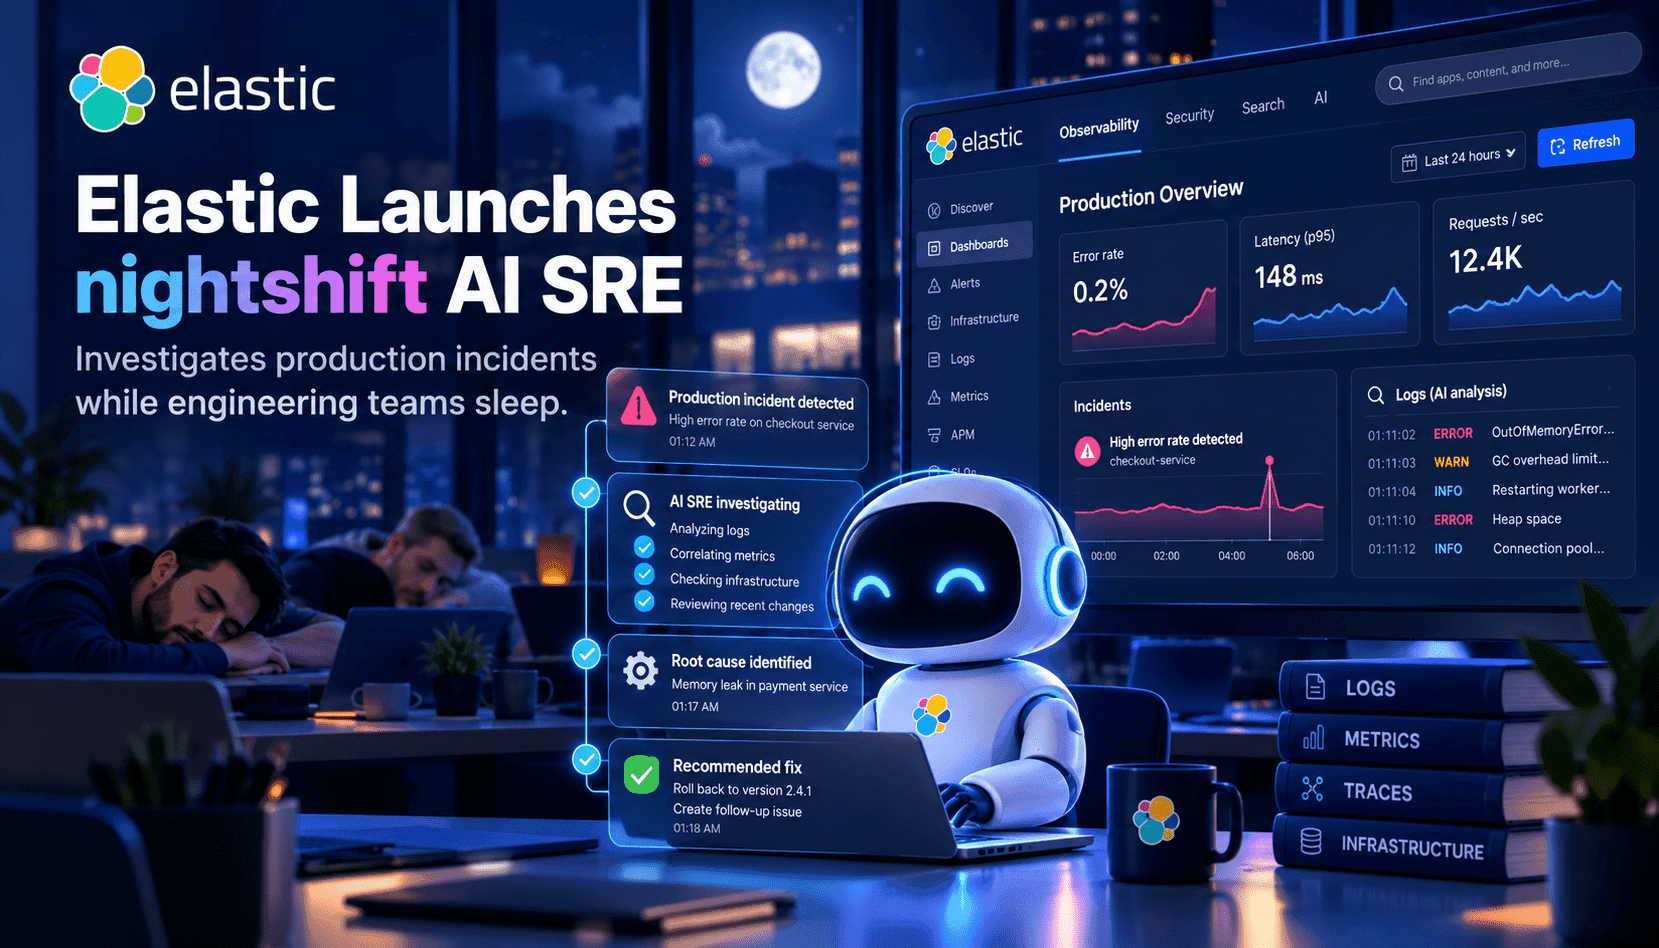
L’IA SRE nightshift d’Elastic mène en continu des investigations autonomes sur les journaux, les métriques, les traces et le contexte opérationnel. Les ingénieurs d’astreinte découvrent ainsi des éléments de preuve organisés, des hypothèses sur les causes profondes et des suggestions de résolution. Cet article explique comment les agents persistants font évoluer le MTTR et les pratiques d’observabilité, et quels tests les équipes devraient lancer en premier.

NexusAI Editorial Desk9 oct. 20261.7K vues7 min de lecture
L’IA SRE nightshift d’Elastic : un agent autonome qui enquête sur les incidents pendant que les équipes dorment
Brief IA

L’IA SRE nightshift d’Elastic fait passer l’observabilité de tableaux de bord consultés ponctuellement à des investigations persistantes menées par des agents de façon autonome en dehors des heures de bureau. En ingérant les journaux, les métriques, les traces et le contexte opérationnel, l’agent rassemble des éléments de preuve, formule des hypothèses hiérarchisées et exécute des procédures de résolution sûres. Pour les équipes d’exploitation et les concepteurs, cette approche réduit les réveils intempestifs et le délai moyen de résolution, tout en soulevant des questions sur la couverture des tests, les garanties de confiance et les modes d’intégration de l’automatisation agentique.

La nouvelle IA SRE nightshift d’Elastic place un agent autonome en première ligne de la fiabilité. Au lieu d’attendre qu’une personne consulte les tableaux de bord, l’agent surveille en continu les journaux, les métriques, les traces et les données contextuelles afin de repérer les anomalies, de trier les incidents et de rassembler des éléments de preuve. L’avantage concret est immédiat : lorsqu’un ingénieur reçoit une alerte, il dispose déjà d’une enquête structurée, avec des événements corrélés, des causes profondes probables et des pistes de résolution. Ce travail préparatoire permet de mieux cerner le problème et de réduire la partie la plus coûteuse de la gestion des incidents : s’y retrouver dans une télémétrie distribuée et bruyante.

Sur le plan technique, nightshift s’appuie sur trois capacités complémentaires : l’ingestion et l’interrogation haute fidélité des journaux, des métriques et des traces ; un magasin de contexte qui relie la télémétrie aux procédures d’exploitation et à la topologie ; et un raisonnement agentique qui enchaîne les étapes de lecture, de synthèse et d’action. La pile Elastic offre déjà de solides capacités d’ingestion et de recherche. L’innovation consiste à réunir ces outils au sein d’agents persistants qui conservent leur état pendant plusieurs heures et ne sollicitent les humains que lorsque leur jugement est nécessaire. Cela transforme la manière dont les données d’observabilité sont organisées, hiérarchisées et présentées : les agents deviennent des utilisateurs actifs de la télémétrie, qu’ils sélectionnent et mettent en valeur, plutôt que de simples observateurs de tableaux de bord.

Sur le plan opérationnel, les investigations menées en continu par des agents réduisent le délai moyen de détection et de résolution en prenant en charge, sans interruption, les phases de découverte et de corrélation. Nightshift peut recueillir les journaux, établir une chronologie des faits, vérifier des hypothèses à partir des références historiques et exécuter des mesures de résolution encadrées (par exemple, des coupe-circuits, des changements de niveau de journalisation ou des bascules de secours sûres). Toutefois, la valeur de cette approche dépend de la confiance qu’elle inspire : les procédures doivent pouvoir être testées, les actions de l’agent doivent être clairement traçables et les limites d’escalade doivent être explicites. Les équipes gardent ainsi la responsabilité tout en profitant du travail automatisé effectué en dehors des heures de bureau.

Pour les responsables techniques et les SRE qui évaluent les agents de type nightshift, les premières questions sont très concrètes : comment intégrer les procédures d’exploitation, quel niveau de qualité de télémétrie faut-il, comment encadrer les retours arrière et limiter le périmètre d’impact, et comment mesurer le retour sur investissement ? Les projets pilotes devraient cibler des catégories d’incidents bien délimitées — fuites de mémoire, nouvelles tentatives trop nombreuses ou défaillances de dépendances externes — pour lesquelles les règles de corrélation sont claires et les mesures de résolution sûres. Les indicateurs de réussite devraient inclure la baisse des réveils intempestifs, le délai d’identification et le délai de réparation, ainsi que le niveau de confiance exprimé par les équipes d’astreinte.

Points clés à retenir

Les agents rendent l’observabilité proactive

Les agents IA SRE persistants transforment la télémétrie en investigations organisées et horodatées. Les ingénieurs reçoivent des éléments de preuve hiérarchisés plutôt que des signaux bruts. Les priorités d’instrumentation évoluent ainsi vers un contexte plus riche et une meilleure cartographie de la topologie.

Commencez par des périmètres restreints et vérifiables

Testez nightshift sur des catégories de défaillances bien définies et validez son fonctionnement en mode observation seule avant d’activer les mesures de résolution automatisées. Utilisez des déploiements progressifs et des journaux d’audit pour instaurer la confiance.

La gouvernance est indispensable à l’exploitation

La gestion des autorisations, la traçabilité, les contrôles de retour arrière et les seuils d’intervention humaine sont essentiels pour éviter les actions dangereuses et rendre les résultats des agents exploitables et auditables.

Ce que nightshift change dans l’observabilité

Nightshift fait évoluer l’observabilité d’un modèle « à la demande », où les humains parcourent les tableaux de bord, vers un modèle « proactif » dans lequel un agent examine la télémétrie en continu et transmet des constats structurés. Les pipelines de données doivent donc être non seulement capables de traiter de grands volumes, mais aussi fournir des données de qualité : schémas cohérents, contexte enrichi (cartographie des services, responsabilités, procédures d’exploitation) et requêtes à faible latence. Le rôle de l’agent est de transformer des flux bruyants en analyses exploitables et en éléments de preuve hiérarchisés. Les équipes doivent donc repenser l’instrumentation de leurs systèmes et leurs investissements dans le balisage, la cartographie de la topologie et la clarté des procédures de gestion des incidents.

Fonctionnement du pipeline d’investigation agentique

Un pipeline nightshift efficace comporte trois étapes : détecter, enrichir et formuler des hypothèses. La détection s’appuie sur des règles, l’apprentissage automatique et des références comportementales pour signaler les anomalies. L’enrichissement ajoute du contexte : responsables des services, déploiements récents, changements de topologie et traces corrélées. La génération d’hypothèses s’appuie sur le raisonnement pour hiérarchiser les causes profondes possibles et proposer des vérifications. Le pipeline peut aussi exécuter des mesures de résolution ou d’atténuation encadrées, si le niveau de confiance et les règles de sécurité le permettent. Les équipes chargées de la mise en œuvre doivent prévoir des journaux de traçabilité et des bancs de test afin que chaque action de l’agent puisse être auditée et annulée.

Bénéfices opérationnels et résultats mesurables

Lorsqu’il est correctement configuré, un agent IA SRE réduit les alertes intempestives, accélère le triage et augmente la proportion d’incidents résolus avec peu d’intervention humaine. Parmi les indicateurs clés à suivre figurent le délai moyen de détection (MTTD), le délai moyen de prise en compte (MTTA) et le délai moyen de résolution (MTTR), ainsi que les indicateurs de fatigue liés aux astreintes. Les gains qualitatifs comptent tout autant : des procédures de gestion des incidents plus complètes, moins de faux positifs et une confiance accrue des équipes dans le travail préparatoire fiable réalisé par le système en dehors des heures de bureau.

Risques, limites et mesures de confiance

L’automatisation agentique comporte des risques : mesures de résolution inadaptées, confiance excessive dans les hypothèses ou lacunes dans les données d’observabilité. Pour les limiter, les équipes doivent restreindre les autorisations d’action à des périmètres précis, exiger une validation humaine pour les mesures à fort impact, conserver des pistes d’audit immuables et mettre en place des tests synthétiques qui vérifient le comportement de l’agent face à des pannes simulées. Des exercices réguliers de red team et des déploiements progressifs des actions de l’agent permettent de détecter les modes de défaillance inattendus avant qu’ils n’affectent la production à grande échelle.

Guide pratique de mise en œuvre

Commencez par un périmètre restreint : choisissez un service ou une catégorie de défaillance, ingérez la télémétrie nécessaire et rédigez des consignes concises que l’agent pourra suivre. Définissez des seuils de confiance clairs et des garde-fous pour les mesures de résolution, puis faites fonctionner l’agent en mode observation seule afin de valider ses résultats. Procédez par étapes : ajoutez des champs de traçabilité, élargissez le périmètre et automatisez les mesures à faible risque, comme la réduction de charge ou la limitation du trafic en fonction des métriques. Accompagnez ces étapes techniques de règles claires : qui est responsable des décisions de l’agent, à quel moment faut-il escalader et comment intégrer de nouveaux services à son magasin de contexte.

Questions fréquentes

Nightshift va-t-il remplacer les ingénieurs d’astreinte ?

Non. Nightshift réduit les tâches répétitives de triage et met en avant les éléments de preuve les plus importants, mais les décisions complexes et les mesures de résolution à haut risque nécessitent toujours un jugement humain. L’agent sert à mieux cerner les problèmes et à réduire la charge cognitive, pas à remplacer la responsabilité des équipes.

Quelle qualité de télémétrie faut-il pour que les investigations de l’agent soient utiles ?

Les agents ont besoin de journaux structurés et cohérents, de métriques à forte cardinalité et de traces enrichies du contexte des services et des spans. Les métadonnées opérationnelles sont tout aussi importantes : responsabilités, déploiements récents et procédures d’exploitation. Elles permettent à l’agent de donner du sens aux anomalies et de proposer des vérifications concrètes.

Comment les équipes peuvent-elles valider le comportement de l’agent avant d’activer la résolution automatisée ?

Faites fonctionner l’agent en mode observation, simulez des défaillances ou rejouez des incidents passés, puis comparez ses hypothèses aux analyses rétrospectives réalisées par les équipes. Déployez les autorisations par étapes : seules les actions à faible impact sont exécutées automatiquement, tandis que les changements à fort impact restent soumis à des contrôles plus stricts.

#SRE Agentique#Automatisation des incidents#Gestion autonome des flux de travail#Agents IA pour entreprises#orchestration d’agents pour entreprises#Travail à Long Terme#Analytique Agentique#Infrastructure de Recherche Agentique#Agents SRE basés sur l’IA#Observabilité Agentique#Automatisation de nuit#Enquête persistante

Newsletter Aperçu IA

Recevez les dernières mises à jour de l'IA, des actualités sur les outils et des analyses directement dans votre boîte de réception.

Pas de spam. Désabonnez-vous à tout moment.
Sur cette page
1.Ce que nightshift change dans l’observabilité2.Fonctionnement du pipeline d’investigation agentique3.Bénéfices opérationnels et résultats mesurables4.Risques, limites et mesures de confiance5.Guide pratique de mise en œuvre
Partager cet article

Articles connexes

Les Agents Multi-Modèles de MorningAI Intègrent GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 et Grok 4.7—avec Publication Sanity CMS Intégrée
Actualités des Produits IA

Les Agents Multi-Modèles de MorningAI Intègrent GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 et Grok 4.7—avec Publication Sanity CMS Intégrée

28 sept. 2026

AgentCore d’Alibaba unifie les agents multi-modèles avec les outils MCP et la gouvernance d’entreprise
Actualités des Produits IA

AgentCore d’Alibaba unifie les agents multi-modèles avec les outils MCP et la gouvernance d’entreprise

27 sept. 2026

Eno de Genesis AI choisit les roues plutôt que les jambes pour un agent physique polyvalent
Actualités des Produits IA

Eno de Genesis AI choisit les roues plutôt que les jambes pour un agent physique polyvalent

25 sept. 2026

Les Rollouts et les Bots de Revue de Sécurité de Cursor Intègrent les Agents de Codage en Production
Actualités des Produits IA

Les Rollouts et les Bots de Revue de Sécurité de Cursor Intègrent les Agents de Codage en Production

24 sept. 2026

Le moteur agentique ThinkingAI intègre des opérations de croissance autonomes dans votre stack
Actualités des Produits IA

Le moteur agentique ThinkingAI intègre des opérations de croissance autonomes dans votre stack

22 sept. 2026

Outils IA associés

Voir tout
Elastic : la base de données de recherche pour l’IA, l’observabilité et la sécurité

Elastic : la base de données de recherche pour l’IA, l’observabilité et la sécurité

IA Données & Analyses