

NexusAi logo

NexusAi

  • Produits
  • Catégorie
  • Prompts
  • Recherche
  • Aperçus
  • Tarifs
  • Promouvoir
  • Contact
Se connecter
NexusAi LogoNexusAi

NexusAI vous aide à découvrir, comparer et apprendre à utiliser les outils d'IA en toute simplicité. Des conseils d'experts aux ressources de formation, nous permettons aux individus et aux entreprises d'exploiter la technologie de l'IA pour des décisions plus intelligentes, l'innovation et la croissance.

Liens utiles

  • À propos de nous
  • Produits d'IA
  • Catégories d'IA
  • Prompts d'IA
  • Recherche IA
  • NexusAI Insights

Services et Mentions légales

  • Vitrine et Promotion
  • Offres d'abonnement
  • Conditions générales
  • Politique de remboursement
  • Politique de confidentialité
  • Avis de non-responsabilité

Contactez-nous

88 Tribune Street
South Brisbane, QLD, Australie, 4101
Site web: www.nexusai-tech.com
E-mail: info@nexusai-tech.com

© Copyright 2026 NexusAi Tous droits réservés

Développé par DStudio Technology
Accueil/Aperçu IA/Actualités des Produits IA/Harness² : le framework open source de Google pour des agents IA qui s’améliorent eux-mêmes
Actualités des Produits IAInfrastructure des agentsChoix de la rédaction

Harness² : le framework open source de Google pour des agents IA qui s’améliorent eux-mêmes

Google a publié Harness², un framework sous licence Apache 2.0 qui permet aux agents de réécrire leurs prompts, leurs garde-fous, leur mémoire et leurs consignes d’utilisation des outils autour d’un modèle fixe. Cet article explique comment Harness² applique la récursion à deux niveaux pour améliorer le comportement des agents sans réglage fin, ce que les développeurs peuvent concrètement adopter et quels gains ont été mesurés lors des évaluations.

NexusAI Editorial Desk20 oct. 20261.5K vues8 min de lecture
Harness² : le framework open source de Google pour des agents IA qui s’améliorent eux-mêmes
Brief IA

Harness² est un framework open source concret qui s’appuie sur la récursion pour améliorer le harness des agents : il optimise les composants qui entourent un modèle de base fixe — prompts, garde-fous, schémas de mémoire, outils, sous-agents, compétences et plug-ins — en proposant des modifications, en sondant le comportement sur une même tâche et en composant des améliorations étayées par des preuves. Google fait état de gains significatifs sur WorkBuddy‑Bench, JobBench et LAB avec Gemini 3.5 Flash et GLM‑5 ; le projet est compatible avec les exécuteurs OpenCode et Codex. Pour les développeurs et les équipes d’entreprise, Harness² permet d’améliorer les agents de programmation et les assistants au niveau du harness, sans réentraînement coûteux du modèle. La clé : des sondes instrumentées, une composition robuste et la conservation durable des enseignements tirés.

Harness² aborde l’amélioration des agents comme un problème de système plutôt que comme un problème de mise à jour du modèle. Au lieu de modifier les poids du modèle, le framework révise de façon itérative le harness de l’agent — l’ensemble des prompts système, garde-fous, schémas de mémoire, consignes liées aux outils, sous-agents et scripts qui façonnent son comportement — et s’appuie sur des exécutions comparatives pour ne retenir que les modifications qui améliorent manifestement les résultats sur une même tâche. Cette approche répond aux contraintes des entreprises qui doivent conserver des modèles fixes pour des raisons de conformité, de coût ou de certification, tout en permettant d’améliorer progressivement le comportement grâce à des modifications du harness reproductibles et vérifiables.

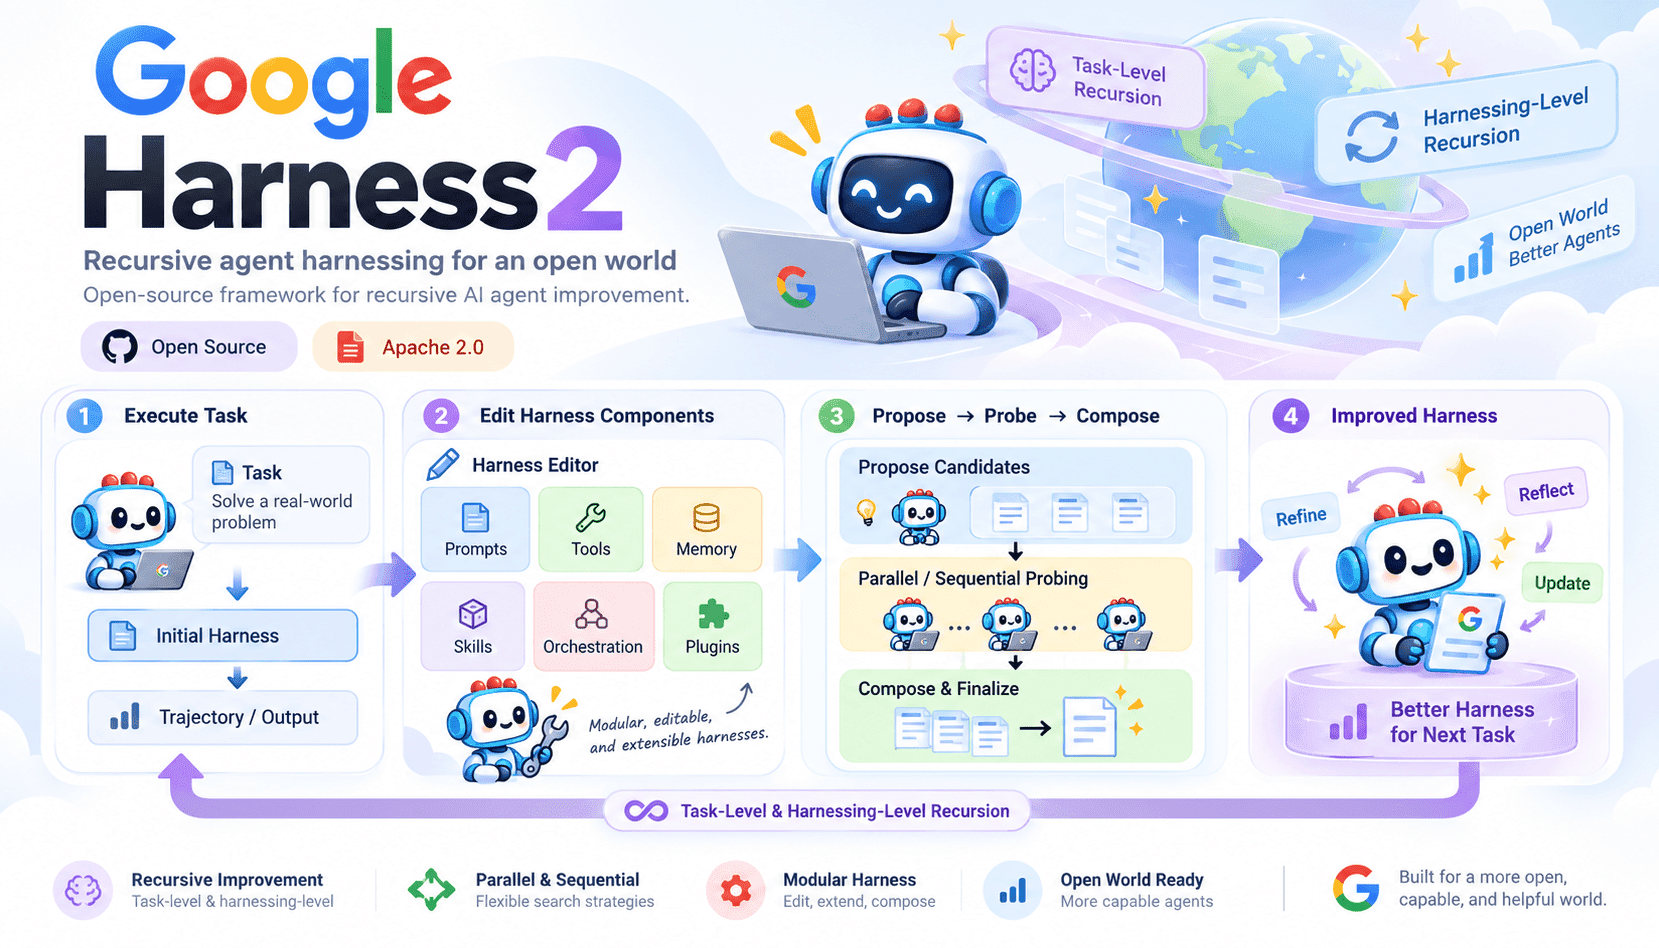
Concrètement, Harness² suit une boucle Proposer–Sonder–Composer : des éditeurs proposent des modifications au harness, celui-ci exécute plusieurs fois la même tâche pour repérer les différences de comportement, puis un module de composition crée un nouveau harness en ne conservant que les changements étayés par les résultats observés. Le système met en œuvre deux niveaux de récursion. La récursion au niveau de la tâche se concentre sur le travail à accomplir (propositions en parallèle ou étapes de raffinement successives, encadrées par un budget --k). La récursion au niveau du harness consigne durablement les versions adoptées et les enseignements tirés, afin que les tâches futures partent d’une meilleure base et puissent bénéficier de ces acquis sans annotations supervisées explicites.

Les résultats publiés par le projet font état d’améliorations notables avec des modèles fixes : une seule étape de Harness² a amélioré les résultats de GLM‑5 et de Gemini 3.5 Flash sur WorkBuddy‑Bench, JobBench et LAB, avec des gains allant jusqu’à environ 11,5 points sur WorkBuddy, 4,5 sur JobBench et près de 12 points de pourcentage sur la métrique de réussite partielle de LAB. Le framework est compatible avec les exécuteurs de type OpenCode et Codex, propose des modes de récursion parallèles et séquentiels, ainsi que des outils pratiques pour les essais à blanc en local et l’évaluation de benchmarks avec jugement. Ces résultats montrent que l’optimisation du harness peut constituer un levier d’ingénierie majeur lorsque la modification des modèles n’est pas envisageable.

Pour les développeurs qui créent des agents de programmation, des assistants d’entreprise ou des workflows autonomes, Harness² propose une méthode opérationnelle concrète : définir les composants modifiables du harness, concevoir des éditeurs déterministes pour générer des changements candidats, mettre en place des sondes robustes (exécutions répétables des tâches et évaluateurs), et maintenir un harness d’amélioration persistant qui conserve les enseignements étayés par des preuves. Le dépôt comprend des démonstrations qui fonctionnent sans identifiants de modèle, ainsi que des instructions pour Vertex AI, les exécuteurs Codex et les configurations de benchmarks sous Docker. La licence Apache 2.0 facilite l’intégration et la redistribution pour les équipes qui ont besoin d’une licence permissive.

Points clés à retenir

Améliorer les agents sans modifier les poids du modèle

Harness² montre que l’optimisation des prompts, des garde-fous, de la mémoire et des consignes d’utilisation des outils peut améliorer de façon mesurable les résultats sur des benchmarks professionnels sans réentraîner les modèles de base — un atout lorsque ceux-ci doivent rester fixes pour des raisons de coût, de conformité ou de gouvernance.

Rendre les modifications vérifiables et durables

Utilisez la boucle Proposer–Sonder–Composer avec des sondes déterministes et un harness d’amélioration persistant : seules les modifications étayées par des preuves sont retenues, et les tâches futures profitent des enseignements précédents.

Gérer les changements du harness comme du code

Gérez les modifications du harness au moyen de la CI, de revues et de déploiements progressifs. Instrumentez les évaluateurs et isolez les exécuteurs pour éviter la suradaptation aux artefacts d’évaluation, les fuites de données et les failles de sécurité.

Ce que Harness² modifie concrètement

Harness² regroupe huit composants modifiables qui façonnent ensemble le comportement de l’agent : le prompt système, les garde-fous, la mémoire, les consignes d’utilisation des outils, les sous-agents, les compétences, les scripts et les plug-ins. Chaque composant influe sur la construction du contexte ou sur le fonctionnement des outils et de la délégation au sein de la boucle de l’agent. Les équipes peuvent ainsi cibler des problèmes précis — utilisation incohérente des outils, rappel insuffisant des informations en mémoire ou consignes de prompt fragiles — en proposant des modifications ciblées du composant concerné, puis en les validant à l’aide de sondes contrôlées, plutôt qu’en apportant au modèle des changements plus larges et plus risqués.

Deux niveaux de récursion : la tâche et le harness

La principale nouveauté du framework réside dans ses deux boucles de récursion imbriquées. La récursion au niveau de la tâche (encadrée par le budget --k) exécute la boucle Proposer–Sonder–Composer pour le travail en cours : en parallèle, pour explorer des harness candidats variés, ou de façon séquentielle, pour affiner progressivement une seule chaîne d’améliorations. La récursion au niveau du harness conserve les versions adoptées et les éléments qui les justifient ; ces enseignements servent de points de départ aux améliorations des tâches suivantes. Pour les équipes, cette séparation permet d’optimiser immédiatement chaque tâche tout en apprenant progressivement d’une tâche à l’autre, et d’équilibrer exploration et capitalisation sans modifier les paramètres du modèle.

Benchmarks, modèles et gains concrets

Google rapporte des gains reproductibles sur trois benchmarks professionnels — WorkBuddy‑Bench (bureautique, Web et code), JobBench (travail professionnel) et LAB (tâches juridiques) — lorsque Harness² améliore les harness de Gemini 3.5 Flash et de GLM‑5. Ces résultats ont été mesurés sans mise à jour des poids, un point important pour les équipes qui ne peuvent pas ou ne souhaitent pas réentraîner leurs modèles. La version publiée comprend des outils pour lancer des expériences évaluées sur des benchmarks, juger les résultats et reprendre des exécutions. Les progrès mesurés sur des benchmarks reconnus offrent aux équipes un moyen défendable d’améliorer les performances sans changer de fournisseur de modèle ni engager de coûteux réglages fins.

Expérience développeur et intégrations

Harness² propose des démonstrations et des guides de configuration pour les exécutions locales et les benchmarks hébergés dans le cloud. Il prend en charge les exécuteurs OpenCode et Codex et fournit des instructions pour l’intégration à Vertex AI, l’utilisation de Docker avec WorkBuddy et l’installation de dépendances comme Pandoc pour LAB. L’API et les outils en ligne de commande permettent aux équipes de lancer des essais à blanc, de sonder de manière déterministe les modifications candidates et de regrouper les harness adoptés dans un répertoire persistant. Pour les équipes produit, cela permet d’intégrer l’optimisation du harness à la CI, d’instrumenter les sondes pour détecter les régressions et de gérer les changements du harness au moyen des processus habituels de revue de code et de déploiement.

Risques, limites et garde-fous opérationnels

L’apprentissage au niveau du harness est puissant, mais il n’est pas sans risque. Comme la composition repose sur le comportement observé plutôt que sur des annotations de référence, les évaluateurs des sondes et les environnements isolés doivent être conçus avec soin. Il faut éviter de suradapter le système aux particularités de l’évaluation, de divulguer des données sensibles lors de sondes parallèles ou d’amplifier des comportements indésirables à force de modifications répétées. Le dépôt déconseille de laisser les exécuteurs accéder sans restriction au réseau et recommande de configurer les évaluateurs et les règles d’accès réseau. Sur le plan opérationnel, les équipes devraient traiter les harness adoptés comme des changements de configuration : imposer une revue de code, un déploiement progressif et une surveillance afin de s’assurer que le comportement renforce bien les résultats recherchés.

Questions fréquentes

Comment Harness² évite-t-il de modifier le modèle sous-jacent ?

Harness² agit uniquement au niveau du harness : il propose des modifications aux prompts, aux garde-fous, aux formats de mémoire, aux interfaces des outils et aux scripts, sans toucher aux poids du modèle. Les propositions sont validées en exécutant plusieurs fois la même tâche et en ne conservant que les compositions associées à une amélioration du comportement. Les paramètres du modèle restent donc inchangés, tandis que le comportement évolue grâce à l’orchestration et à l’ingénierie du contexte.

Puis-je utiliser Harness² avec des modèles propriétaires ou hébergés ?

Oui. Le framework prend en charge les exécuteurs OpenCode et Codex et propose des instructions pour intégrer des modèles hébergés, par exemple via Vertex AI. La boucle principale ne nécessite pas de réentraînement, mais vous devez vous assurer que l’accès aux API, la gestion des coûts, l’isolation et les règles de conformité sont en place avant de lancer des sondes parallèles ou des évaluations de benchmarks.

Quel budget de récursion --k convient à une utilisation en production ?

Commencez modestement : utilisez --k=1 pour valider le processus Proposer–Sonder–Composer et vérifier la fiabilité des évaluateurs et des sondes. Pour obtenir des améliorations plus poussées, lancez le mode parallèle avec une valeur K modérée (3–5) afin d’explorer plusieurs candidats, ou le mode séquentiel avec une valeur K croissante pour affiner un seul harness. Surveillez les gains marginaux par rapport au coût des API et ne retenez que les changements qui produisent des améliorations constantes, confirmées par l’évaluation.

#Agents auto-améliorants#Amélioration Récursive de Soi (RSI)#Mémoire et Outils de l'Agent#Flux de travail des agents développeurs#Modèles de base pour séries temporelles#Persistance de la mémoire pour les agents#agents et sous-agents#Références des Agents de Codage#agents de codage autonomes#Assistants de codage pour entreprises#Flux de travail des agents en entreprise#orchestration d’agents pour entreprises#Agents indépendants des modèles#Sécurité et Évaluation des Agents#Boucle d'amélioration du Codex#Harness2#Orchestration récursive d’agents#Exécuteur OpenCode#Auto-optimisation de l’agent#Exploiter les guides pratiques

Newsletter Aperçu IA

Recevez les dernières mises à jour de l'IA, des actualités sur les outils et des analyses directement dans votre boîte de réception.

Pas de spam. Désabonnez-vous à tout moment.
Sur cette page
1.Ce que Harness² modifie concrètement2.Deux niveaux de récursion : la tâche et le harness3.Benchmarks, modèles et gains concrets4.Expérience développeur et intégrations5.Risques, limites et garde-fous opérationnels
Partager cet article

Articles connexes

AI Passport de ServiceNow : une couche d’autorité à l’exécution pour les agents d’entreprise
Actualités des Produits IA

AI Passport de ServiceNow : une couche d’autorité à l’exécution pour les agents d’entreprise

17 oct. 2026

Lovable ajoute la création de publicités et leur lancement en un clic sur Google, YouTube, Facebook et Instagram
Actualités des Produits IA

Lovable ajoute la création de publicités et leur lancement en un clic sur Google, YouTube, Facebook et Instagram

15 oct. 2026

L’IA SRE nightshift d’Elastic : un agent autonome qui enquête sur les incidents pendant que les équipes dorment
Actualités des Produits IA

L’IA SRE nightshift d’Elastic : un agent autonome qui enquête sur les incidents pendant que les équipes dorment

9 oct. 2026

Les Agents Multi-Modèles de MorningAI Intègrent GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 et Grok 4.7—avec Publication Sanity CMS Intégrée
Actualités des Produits IA

Les Agents Multi-Modèles de MorningAI Intègrent GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 et Grok 4.7—avec Publication Sanity CMS Intégrée

28 sept. 2026

AgentCore d’Alibaba unifie les agents multi-modèles avec les outils MCP et la gouvernance d’entreprise
Actualités des Produits IA

AgentCore d’Alibaba unifie les agents multi-modèles avec les outils MCP et la gouvernance d’entreprise

27 sept. 2026

Outils IA associés

Voir tout
Harness2 : l’optimisation récursive des agents en environnement ouvert

Harness2 : l’optimisation récursive des agents en environnement ouvert

Assistants & Agents IA

Google Research : la science et l’IA au service d’un impact concret

Google Research : la science et l’IA au service d’un impact concret

Modèles d’IA & LLM