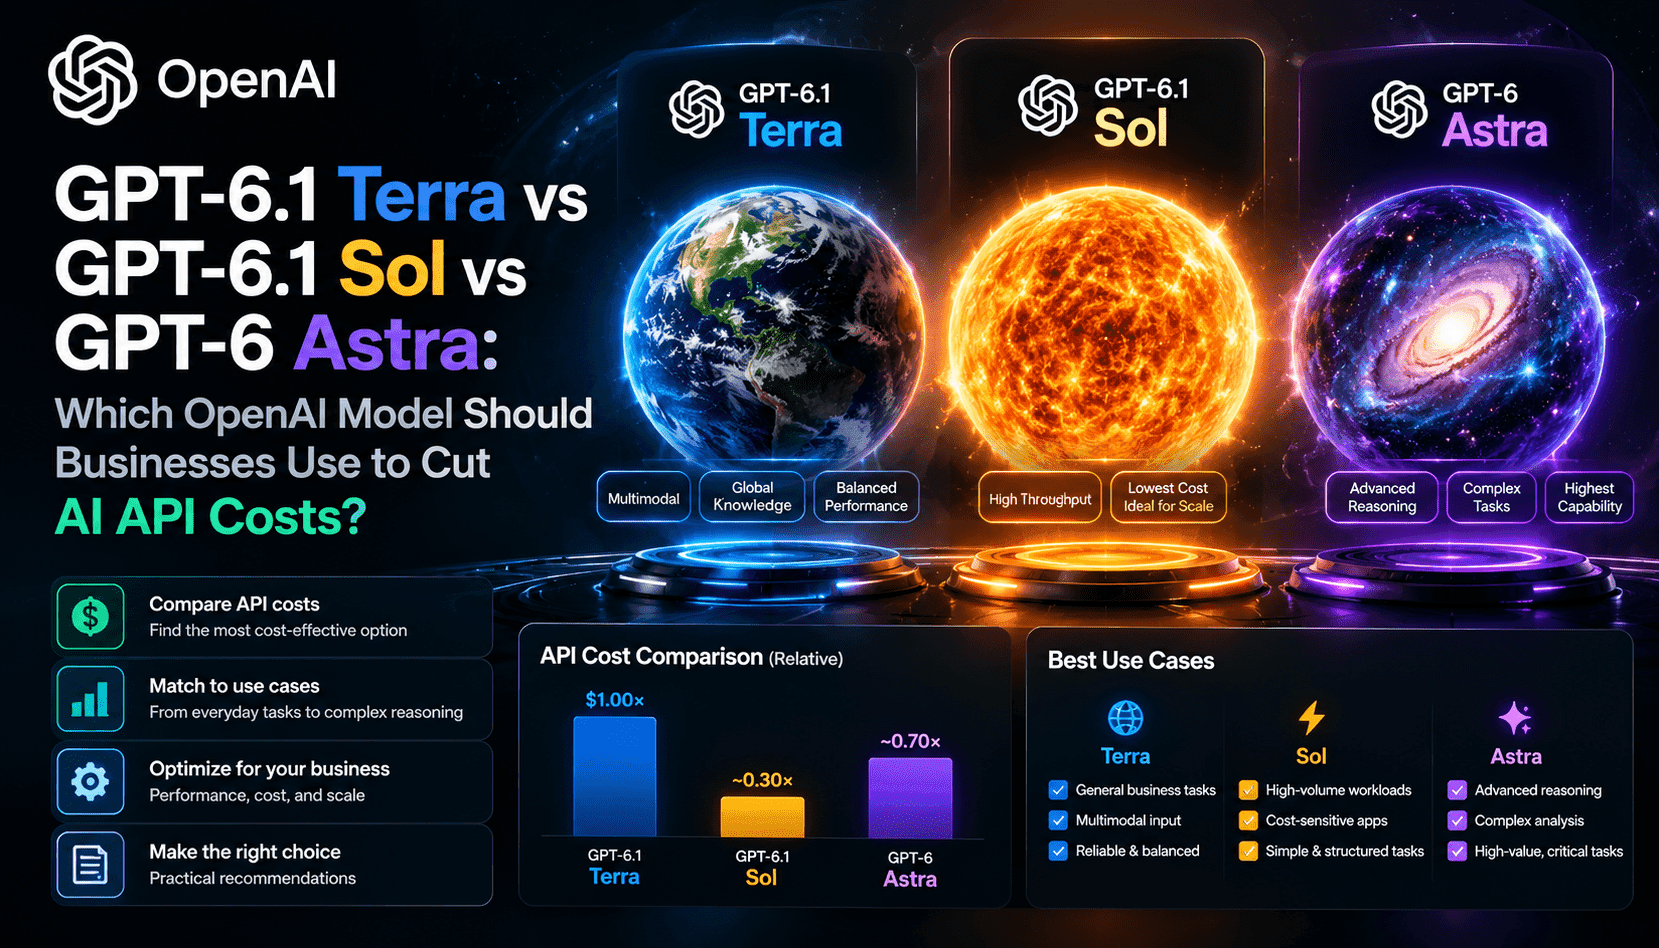
Comparatif stratégique de GPT-6.1 Terra, GPT-6.1 Sol et GPT-6 Astra, qui montre comment les entreprises peuvent réduire leurs dépenses d’API d’IA sans sacrifier la fiabilité. Découvrez les compromis entre prix et performances, les stratégies de routage et des architectures concrètes pour la création de contenu, la traduction, le traitement de documents, les agents de navigation web et les pipelines de programmation.
Les équipes d’IA des grandes entreprises ont désormais accès à plusieurs modèles performants d’OpenAI, qui présentent des compromis distincts entre coût et capacités. GPT-6.1 Terra est optimisé pour les charges de travail à fort volume et sensibles à la latence, où une inférence prévisible et peu coûteuse est essentielle. GPT-6.1 Sol offre de meilleures capacités générales de raisonnement et de programmation, moyennant un coût de calcul plus élevé, tandis que GPT-6 Astra cible le raisonnement visuel et les agents multimodaux. Cet article présente des règles et des architectures concrètes permettant aux équipes de confier les tâches courantes à Terra et de réserver Sol ou Astra aux cas qui nécessitent réellement leurs atouts.
La bonne stratégie de routage des modèles réduit les dépenses d’API en combinant classification globale et exécution précise. Commencez par classer les requêtes entrantes selon leur complexité, la latence tolérée et leur modalité. La génération de texte à grande échelle à partir de modèles, les traductions simples, l’extraction de métadonnées et le formatage déterministe conviennent parfaitement à Terra. Utilisez Sol pour les raisonnements complexes, la synthèse de plusieurs documents, la génération de code exigeante et la réécriture créative. Réservez Astra aux tâches qui nécessitent de comprendre des images, d’analyser leur mise en page ou de piloter visuellement un navigateur. La suite de ce guide quantifie ces compromis et propose des exemples de pipelines.
Un routage soucieux des coûts n’est pas qu’une astuce d’ingénierie : il nécessite des mesures, des garde-fous et un déploiement progressif. Les équipes doivent créer un middleware de routage adaptatif, recueillir des indicateurs pour chaque modèle (latence, coût par inférence réussie, taux d’erreur, taux de transfert à un humain) et définir des règles de repli et d’échantillonnage afin que le remplacement d’un modèle ne dégrade pas l’expérience utilisateur. Nous proposons des indicateurs clés de suivi concrets et une liste de vérification pour éviter les pièges courants : boucles de rétroaction qui renvoient les tâches complexes vers des modèles coûteux, dérive des données qui réduit l’efficacité de Terra et télémétrie insuffisante pour les audits réglementaires.
Les sections qui suivent détaillent les tarifs et les exemples de débit, les architectures de routage pour les cas d’usage courants en entreprise, la liste de vérification pour la mise en œuvre, les bonnes pratiques de suivi opérationnel et une FAQ concise destinée aux équipes prêtes à tester un déploiement combinant plusieurs modèles. Chaque section est conçue pour être directement exploitable : vous pouvez reprendre les architectures, le schéma de télémétrie et les règles de décision dans vos plans d’approvisionnement et d’ingénierie.
Tarifs, latence et capacités : comparaison directe
Dans l’ensemble, Terra offre le coût par jeton le plus bas et le débit le plus élevé pour les tâches textuelles, grâce à une quantification et à un traitement par lots optimisés. Sol applique un tarif supérieur pour le raisonnement avec un contexte plus large et la génération de code ; sa latence par appel est modérément plus élevée à objectifs de niveau de service comparables. Astra est tarifé pour les tâches multimodales : prévoyez un coût par appel plus important lorsque des images ou des actions dans un navigateur sont impliquées. Pour vos achats, établissez un modèle de coût pour 100 000 requêtes, en tenant compte du nombre moyen de jetons par requête, des nouvelles tentatives prévues et des surcoûts de démarrage à froid des agents.
Conséquence pratique : si 70 % de vos appels quotidiens portent sur du contenu court ou l’extraction de métadonnées, les transférer vers Terra peut réduire vos dépenses mensuelles d’API de 30 à 60 %, selon le volume. Toutefois, un routage fondé uniquement sur le coût comporte des risques ; ajoutez des contrôles qualité et un échantillonnage qui envoient une partie des réponses de Terra à Sol pour une validation continue et la détection des dérives de fidélité sémantique.
Suivi de la qualité, indicateurs clés et garde-fous
Le suivi est indispensable pour préserver les économies réalisées. Suivez les indicateurs clés de chaque modèle : latence P50/P95, coût par tâche achevée, taux d’échec aux seuils de tolérance propres au domaine, transferts à un humain et précision sémantique mesurée par des contrôles automatisés ou des échantillons. Configurez des alertes en cas de hausse du taux d’erreur de Terra ou de baisse de confiance. Utilisez des déploiements A/B ou canari pour valider les changements de routage avant leur généralisation. Enfin, conservez une piste d’audit retraçant les décisions de sélection des modèles, à des fins de conformité et de débogage.
Garde-fous : fixez un plafond budgétaire strict pour chaque modèle et limitez le nombre de jetons au niveau de la passerelle ; exigez l’approbation d’un humain pour tout routage automatique qui transmet des données personnelles ou réglementées à des modèles de plus grande capacité. Enfin, réentraînez ou reconfigurez régulièrement votre classificateur de routage pour tenir compte de l’évolution des requêtes et des performances des modèles.