

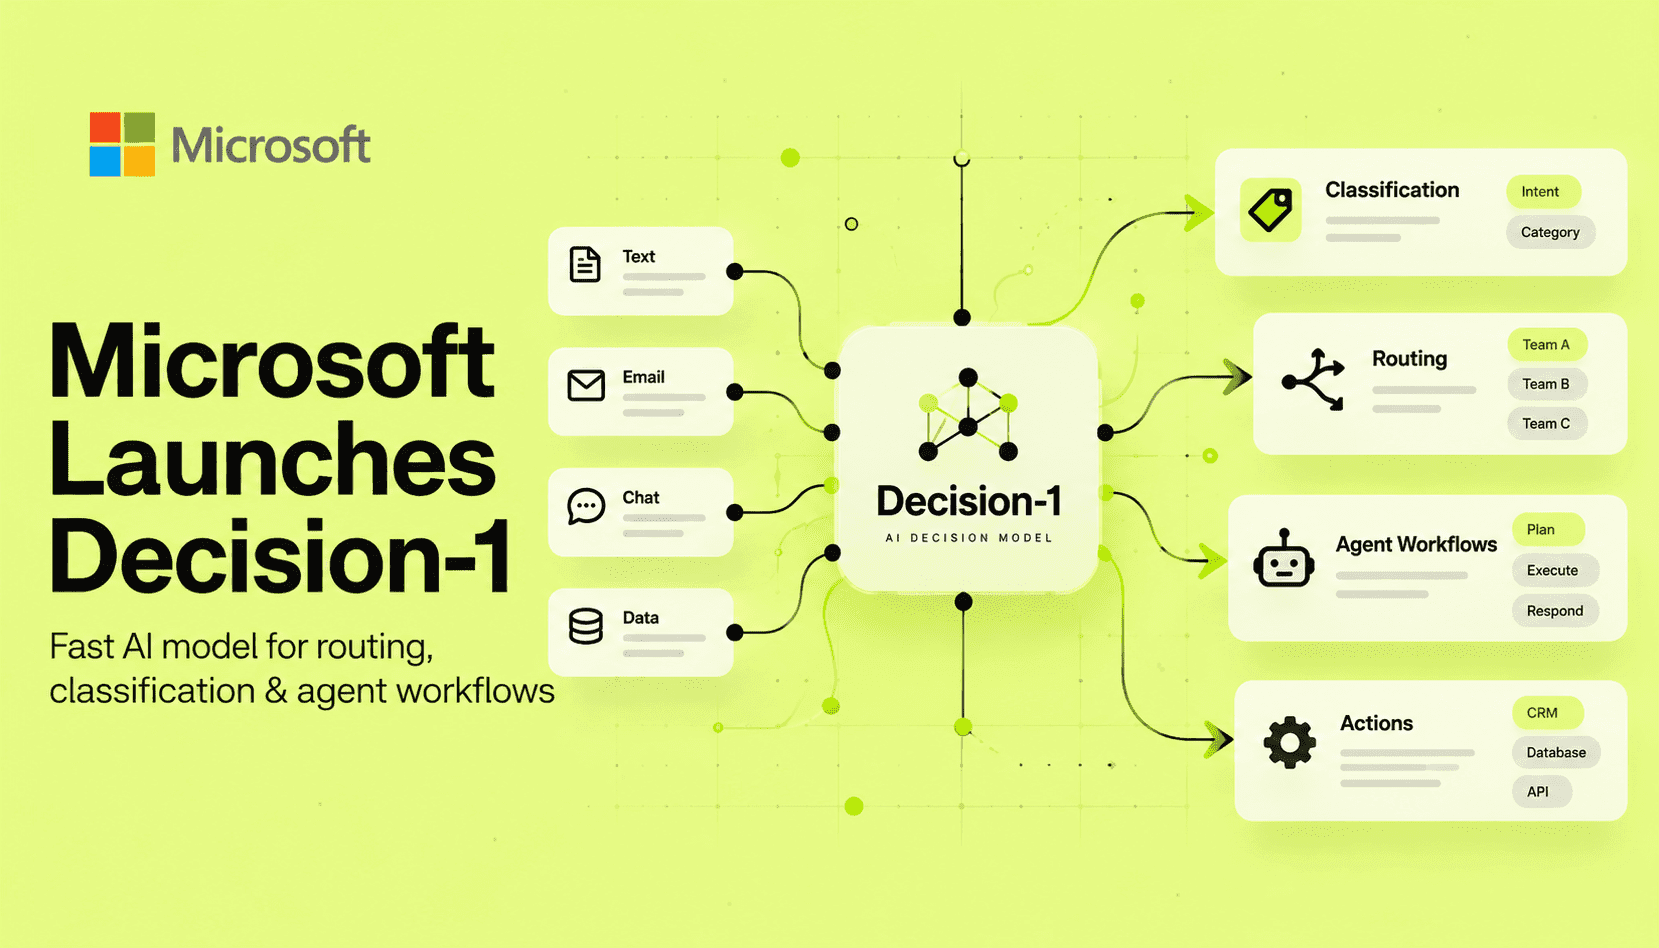
Microsoft-Decision-1 est un modèle de scoring spécialisé, conçu pour les logiciels qui doivent prendre des décisions — choisir, classer, catégoriser, vérifier ou attribuer un score — plutôt que générer du contenu. Contrairement aux LLM généralistes optimisés pour produire un texte fluide, ce modèle fournit des résultats structurés et des probabilités calibrées en un seul passage avant. Pour les équipes produit, cette différence est importante : elle transforme les tâches exigeant de nombreuses décisions, auparavant confiées à des appels coûteux et lents à un LLM, en étapes de scoring compactes et déterministes, adaptées aux agents en temps réel, aux webhooks et aux pipelines de modération à haut débit.
Sur le plan technique, Microsoft présente ce modèle comme reposant sur Qwen3.5‑9B et optimisé pour le calibrage et l’inférence à faible latence. Il attribue des probabilités à des choix prédéfinis, que les logiciels peuvent exploiter directement pour le routage ou des décisions fondées sur des seuils. Cela évite les allers-retours avec un LLM génératif et supprime le besoin d’analyse supplémentaire ou d’extraction heuristique. Les scores calibrés obtenus en un seul passage simplifient aussi la télémétrie en aval : il devient possible de mesurer la confiance, d’ajuster les seuils et de déployer des garde-fous sans recourir à une ingénierie de prompt coûteuse ni à des chaînes de vérification en plusieurs étapes.
Les résultats annoncés par Microsoft sont remarquables : Decision‑1 arrive en tête d’une comparaison portant sur 36 benchmarks en matière de précision et — point essentiel — surpasse largement les modèles génératifs de référence en vitesse, avec un avantage annoncé de 35× par rapport à un modèle GPT-6 Sol lors de leurs tests. Un tel gain compte lorsque la latence, le coût par inférence et le débit imposent des contraintes au produit. Le contexte des benchmarks, le matériel, le traitement par lots et l’adéquation des jeux de données restent toutefois déterminants. Avant de modifier leur architecture, les équipes devraient reproduire les principaux microbenchmarks sur leur propre environnement de production.
En pratique, Decision‑1 se situe entre les classificateurs légers et les LLM de grande taille : il est plus spécialisé qu’un petit classificateur, car il est entraîné et calibré pour de nombreuses tâches de décision, tout en étant bien moins coûteux et plus rapide qu’un LLM génératif complet chargé d’analyser une requête et de décider. Pour les équipes d’ingénierie, cela donne une ligne de conduite claire : remplacer les appels à un LLM complet lorsque l’objectif est de sélectionner, router, noter ou vérifier, et réserver les LLM génératifs aux tâches créatives, aux résumés et à la synthèse de contenus longs.
Pour déployer un modèle de décision en production, il faut prêter attention au calibrage, aux changements de distribution des données et à son intégration aux chaînes d’outils existantes des agents. Les équipes devraient instrumenter des seuils de confiance, prévoir un recours à des LLM génératifs en cas de problème de calibrage ou de dérive des données, et organiser des cycles d’entraînement et d’évaluation adaptés aux catégories propres à l’activité et aux objectifs de coût. Correctement mis en œuvre, Decision‑1 peut réduire la latence et le coût d’inférence, tout en rendant plus déterministes les processus faisant appel à de nombreuses décisions.