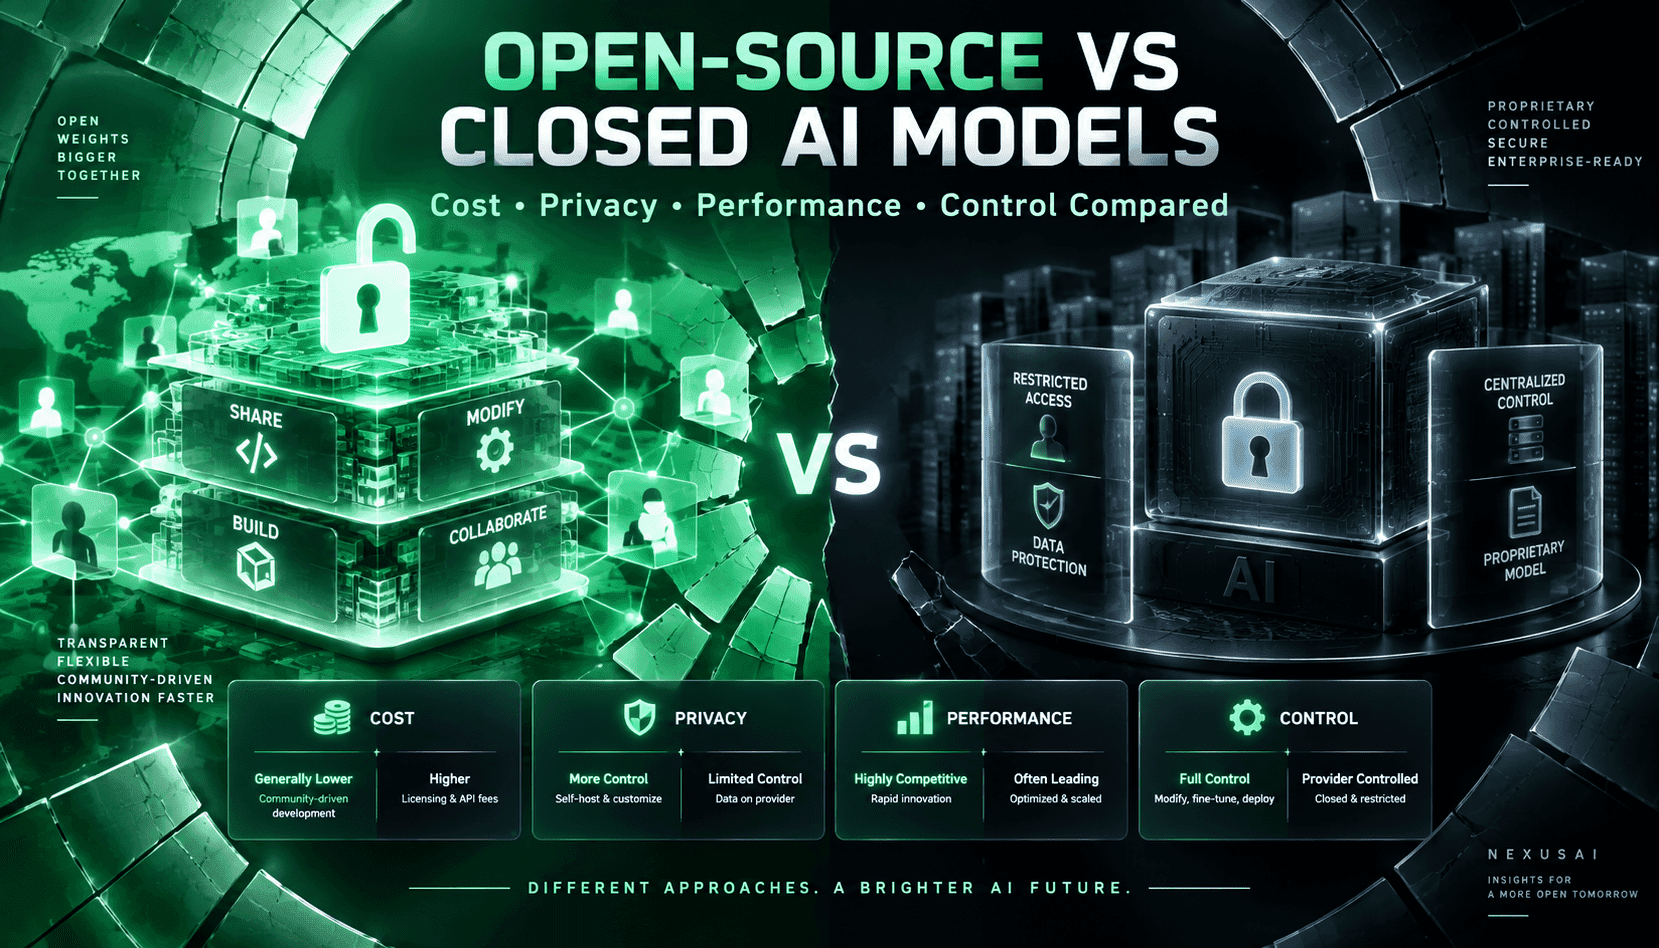
Choisir entre une IA open-source et une IA fermée ne se résume pas aux seuls scores bruts des benchmarks. Ce guide compare le coût total de possession, la posture de confidentialité, la performance et la fiabilité, les options de personnalisation, les risques de sécurité et de conformité, la charge de maintenance et la dépendance au fournisseur — puis montre quand combiner les modèles et orienter les charges de travail pour réaliser des économies substantielles sans sacrifier les résultats.
La plupart des équipes considèrent encore la sélection d’un modèle comme une course au meilleur score, alors que la décision opérationnelle est plus large : quel est le coût du résultat, et qui contrôle le chemin des données ? Les modèles open-weight se rapprochent désormais des systèmes premium sur de nombreuses charges pratiques, notamment en codage et en sortie structurée. Les options fermées restent en tête pour la profondeur du raisonnement général et la fiabilité agentique. Le guide moderne de l’acheteur combine les deux : orientez selon le type de tâche, pas la marque, pour réaliser des économies significatives sans compromettre la qualité là où elle compte le plus.
Les prix affichés par token ne sont qu’un point de départ. Le coût effectif dépend de la verbosité, de la longueur du contexte consommé, des modes d’utilisation des outils, des tentatives répétées et de la charge de surveillance. Avec un routage intelligent, les organisations constatent régulièrement des écarts de coût de sortie de 5 à 8 fois entre les modèles fermés premium et les poids ouverts performants pour des tâches similaires. Mais cet avantage se réduit lorsque la verbosité augmente ou que les exigences de fiabilité imposent plusieurs tentatives. En d’autres termes : le modèle le moins cher par million de tokens n’est pas toujours le moins cher par tâche résolue. Instrumentez vos charges et évaluez le coût de toute la chaîne, pas seulement l’inférence.
La posture de confidentialité est la deuxième décision, pas une réflexion secondaire. Les poids open self-hosted peuvent offrir un contrôle fort des données, une sortie déterministe et la possibilité de conserver les logs entièrement sur votre infrastructure — utile pour les équipes régulées et les plateformes ML avec du code sensible ou des données personnelles. Les services fermés gérés fournissent souvent des artefacts de conformité clés en main, des protections matures contre les abus et des rapports SOC 2/ISO stables. Les deux approches peuvent être sécurisées ; elles concentrent simplement le risque différemment : l’open-source transfère la responsabilité à votre équipe ; le fermé concentre la confiance dans les contrôles et la feuille de route du fournisseur.
La performance reste nuancée. Les modèles fermés conservent généralement un avantage sur le raisonnement multi-étapes complexe et les workflows multi-agents de longue durée. Les poids ouverts sont de plus en plus compétitifs sur le codage, les tâches augmentées par récupération et les workflows bien structurés. Les benchmarks aident mais ne tranchent pas l’achat : exploitez les différences, la verbosité de sortie et les structures de prompt pour faire évoluer les scores de manière significative. Validez sur votre stack avec des dépôts représentatifs, des schémas d’outils et des budgets de latence, puis verrouillez les règles de routage et les SLA dans vos runbooks.
Coût Total de Possession : Évaluez Toute la Chaîne
Le coût total de possession dépasse largement les taux d’entrée/sortie. Mesurez la verbosité de sortie, les tokens de contexte, les tentatives, les appels d’outils et les boucles d’évaluation ; puis intégrez l’observabilité, la stratégie de cache et la réponse aux incidents. Les modèles open-weight peuvent être nettement moins chers pour les tâches à forte implémentation, mais la verbosité ou un contexte plus large peuvent annuler ces économies. À l’inverse, les modèles fermés avec une meilleure fidélité d’instruction peuvent résoudre les tâches en moins d’étapes et réduire le coût par unité résolue malgré des taux de tokens plus élevés. La bonne réponse repose sur des preuves, pas sur la fidélité à une marque.
Étapes pratiques : 1) instrumenter les tokens entrants/sortants et la latence par tâche ; 2) capturer les taux d’échec/rollback ; 3) réaliser un routage A/B sur des charges représentatives pendant au moins une semaine ; 4) modéliser le coût par PR acceptée, page de doc ou ticket résolu ; 5) convertir les SLA cibles (précision, temps de fusion) en seuils budgétaires. Verrouillez des politiques comme « fermé pour les refactorings globaux, ouvert pour le scaffolding des tests unitaires » et révisez trimestriellement.
Confidentialité, Résidence et Surfaces de Contrôle
Décidez votre posture de contrôle dès le départ. Les déploiements open-source peuvent fonctionner sur votre VPC ou sur site avec KMS, sous-réseaux privés et sans logs persistants — maximisant le contrôle et garantissant la résidence des données. Vous bénéficiez aussi d’options comme la rédaction à la passerelle, le hachage de contenu pour la déduplication et des politiques par locataire pour les outils agents. Le compromis : vous êtes responsable des patchs, mises à jour de modèles et risques liés à la chaîne d’approvisionnement des poids, conteneurs et dépendances.
Les services fermés centralisent le risque dans une pile fournisseur validée avec des termes DPA matures, des attestations SOC/ISO, un hébergement régional et une journalisation fine. Demandez les paramètres par défaut de rétention, les blocages d’entraînement, les contrôles de confidentialité spécifiques au modèle, la méthodologie red-team et le support BYOK. Cartographiez ces éléments aux niveaux de sensibilité des charges pour que les flux à haut risque n’utilisent jamais des paramètres permissifs par défaut.
Performance, Fiabilité et Limites des Benchmarks
Les classements simplifient la complexité. Les différences dans les environnements, les structures de prompt ou la disponibilité des outils peuvent modifier significativement les résultats, surtout sur le codage et les tâches à long contexte. De plus, la verbosité de sortie change l’économie : un modèle moins cher qui génère 3 à 4 fois plus de tokens par tâche peut finalement coûter plus cher. Enfin, les benchmarks sous-estiment souvent la fiabilité opérationnelle — continuité de session, récupération d’erreur et appels concurrents d’outils — tous critiques dans les pipelines agentiques.
Faites votre propre test comparatif : évaluez les workflows exacts (ex. refactorings multi-fichiers, génération de tests, RAG avec tables), capturez les réussites/échecs au niveau des artefacts, mesurez les tentatives et modifications humaines, et comparez le coût par artefact accepté. Mettez en place des garde-fous pour les étapes sujettes aux hallucinations (sortie validée par schéma, décodage contraint, filtres de récupération) et orientez les tâches à enjeux élevés vers le modèle le plus fiable même si les tokens coûtent plus cher.
Personnalisation et Gouvernance : Adaptez le Modèle au Travail
Les poids ouverts offrent une extensibilité maximale : fine-tuning efficace en paramètres, adaptateurs de domaine et couches de garde que vous pouvez versionner et déployer. Ils s’associent bien aux corpus RAG internes, conventions de code et schémas d’outils. Vous contrôlez le rythme des sorties et pouvez renforcer les comportements avec des portes d’évaluation avant promotion. Le coût est opérationnel : maturité MLOps, optimisation de l’inférence et temps humain pour maintenir la stack.
Les modèles fermés offrent généralement une meilleure adhérence à la sortie structurée, une utilisation robuste des outils et une coordination multi-agent stable sans surcharge de personnalisation. Autant que possible, apportez votre gouvernance à la périphérie — contrats d’outils typés, validation JSON schema, basculements automatisés — et traitez les API fermées comme des composants dans votre enveloppe politique. Dans les environnements mixtes, utilisez un routeur conscient des politiques pour que les règles de gouvernance accompagnent la requête, pas le modèle.
Maintenance, Sécurité et Dépendance au Fournisseur
L’auto-hébergement signifie que vous gérez la vitesse des patchs, l’hygiène des dépendances et la gestion des vulnérabilités. Exigez des SBOM pour les images de base, signez les artefacts et planifiez les mises à jour derrière des portes d’évaluation. Prévoyez une réponse aux incidents sur la passerelle modèle, la couche de cache et les magasins vectoriels. Construisez des runbooks pour le rollback de modèle, la réduction de trafic et les basculements d’urgence en cas de régressions de qualité.
Les fournisseurs fermés réduisent la charge opérationnelle mais introduisent un risque de concentration : changements de tarification, limites de taux, dépréciations de modèles ou disponibilité régionale peuvent impacter les SLA. Atténuez avec un plan de double sourcing, des SDK abstraits et des prompts/tests dorés permettant un basculement rapide. Contractualisez des SLA de disponibilité, des clauses de confidentialité et un préavis sur les changements de modèles. Traitez la gestion fournisseur comme une partie intégrante de votre stratégie de fiabilité.