

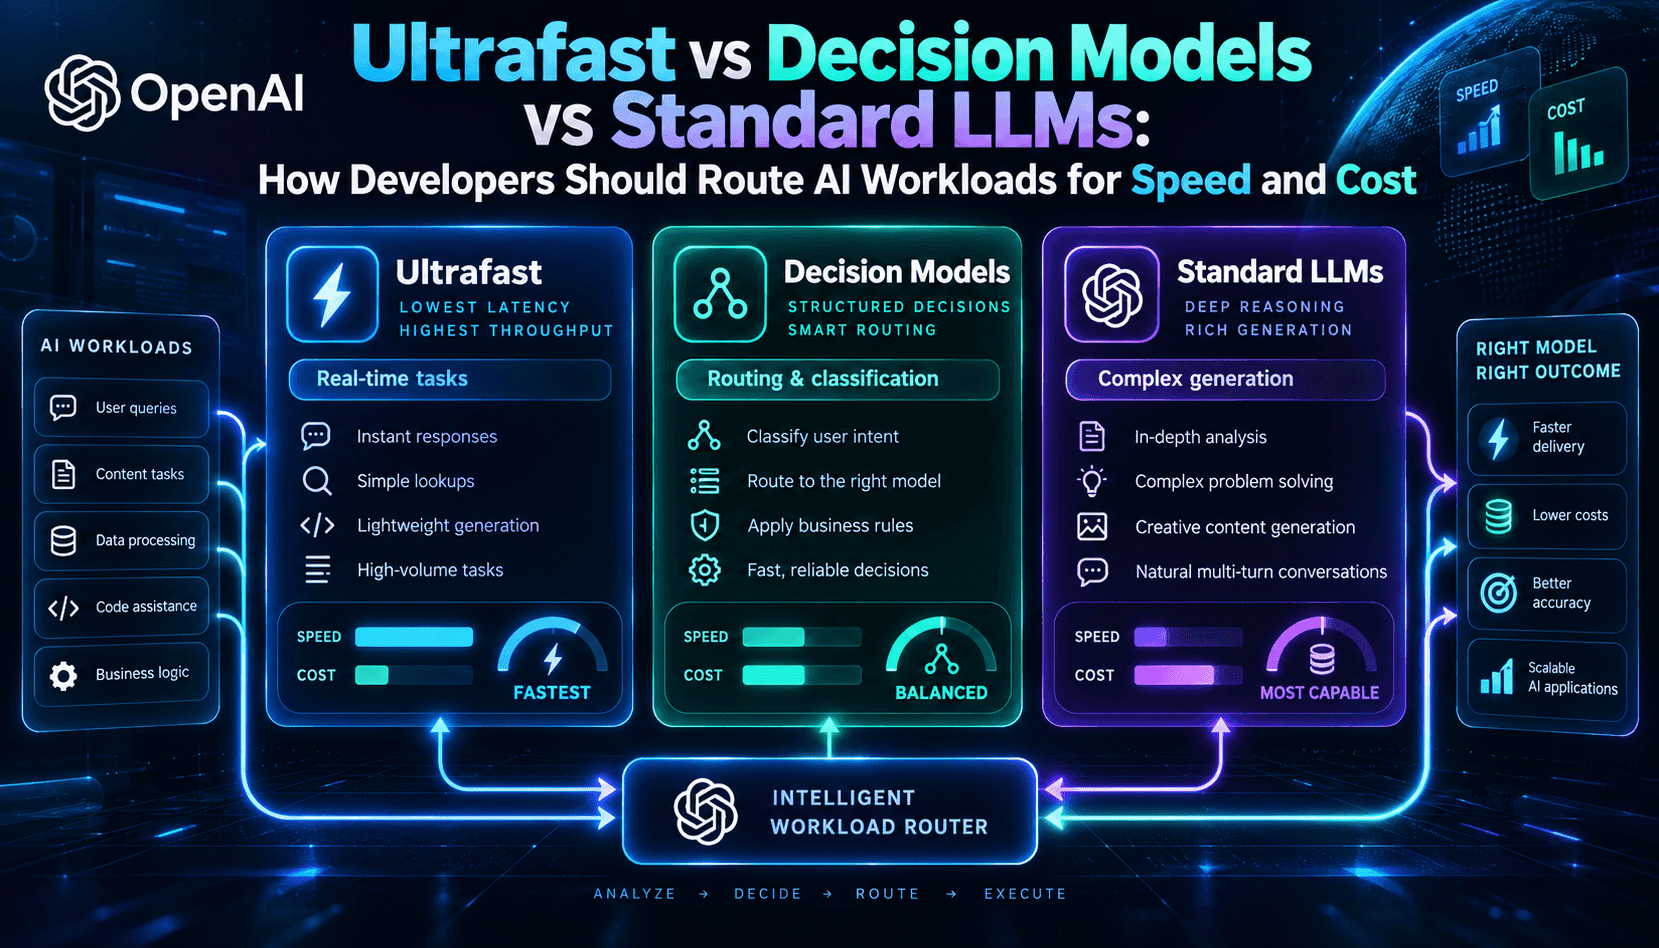
Les développeurs sont souvent confrontés à un choix d’architecture : envoyer toutes les requêtes au modèle le plus performant ou les orienter vers des points de terminaison spécialisés, plus rapides et moins coûteux. Les récentes nouveautés d’OpenAI — GPT-6.1 Sol Ultrafast et GPT-6 Luna Decisions — permettent de faire ce choix de façon plus éclairée. Sol Ultrafast réduit la latence de génération des jetons dans les flux génératifs, tandis que Luna Decisions fournit des réponses et des décisions typées avec un débit environ dix fois supérieur à celui des points de terminaison Responses complets. Cet article traduit ces avancées de la plateforme en stratégies de routage concrètes que vous pouvez mettre en œuvre dès aujourd’hui.
Avant de router vos requêtes, classez les charges de travail selon quatre critères : la profondeur de raisonnement nécessaire (classification simple ou chaîne de raisonnement approfondie), la latence acceptable (interface utilisateur à moins de 100 ms ou traitement par lots de plusieurs secondes), la structure de sortie (décision typée ou texte libre) et la sensibilité au coût. Par exemple, les tâches courtes et déterministes de classification et de routage ne nécessitent souvent que l’API Decisions. La génération conversationnelle riche et créative tire parti de Sol ou Astra avec raisonnement complet ; pour la diffusion de jetons à haut débit dans une interface, l’offre Ultrafast est généralement la plus adaptée. Cette grille aide à associer chaque charge de travail au bon modèle et à éviter de recourir inutilement aux modèles les plus coûteux.
En pratique, mettez en place trois voies de routage complémentaires : une voie Decisions (Luna) pour les décisions structurées à haut débit et la classification ; une voie générative Ultrafast (GPT-6.1 Sol avec service_tier:"ultrafast") pour la diffusion de jetons à faible latence et les interfaces interactives ; et une voie de raisonnement (GPT-6 Sol/Astra) pour le raisonnement complexe, la synthèse de code ou l’utilisation d’outils en plusieurs étapes. Ajoutez un routeur léger qui sélectionne la voie en fonction des métadonnées : taille de la requête, effort de raisonnement attendu, budget de latence et besoin éventuel d’une sortie structurée et typée.
Exemples concrets : utilisez Decisions pour détecter le spam, orienter les intentions, prendre des décisions liées aux indicateurs de fonctionnalité, effectuer des classifications simples et produire des sorties typées. Optez pour Ultrafast pour les conversations diffusées en continu, la saisie semi-automatique, les suggestions en temps réel et les interfaces où les utilisateurs préfèrent une réponse immédiate à une réflexion un peu plus approfondie. Réservez les modèles à raisonnement complet à la génération de code, à l’analyse en plusieurs étapes ou aux cas où l’appel d’outils et le raisonnement approfondi changent réellement le résultat. Ces pratiques réduisent les coûts globaux tout en préservant la précision là où elle compte le plus.