

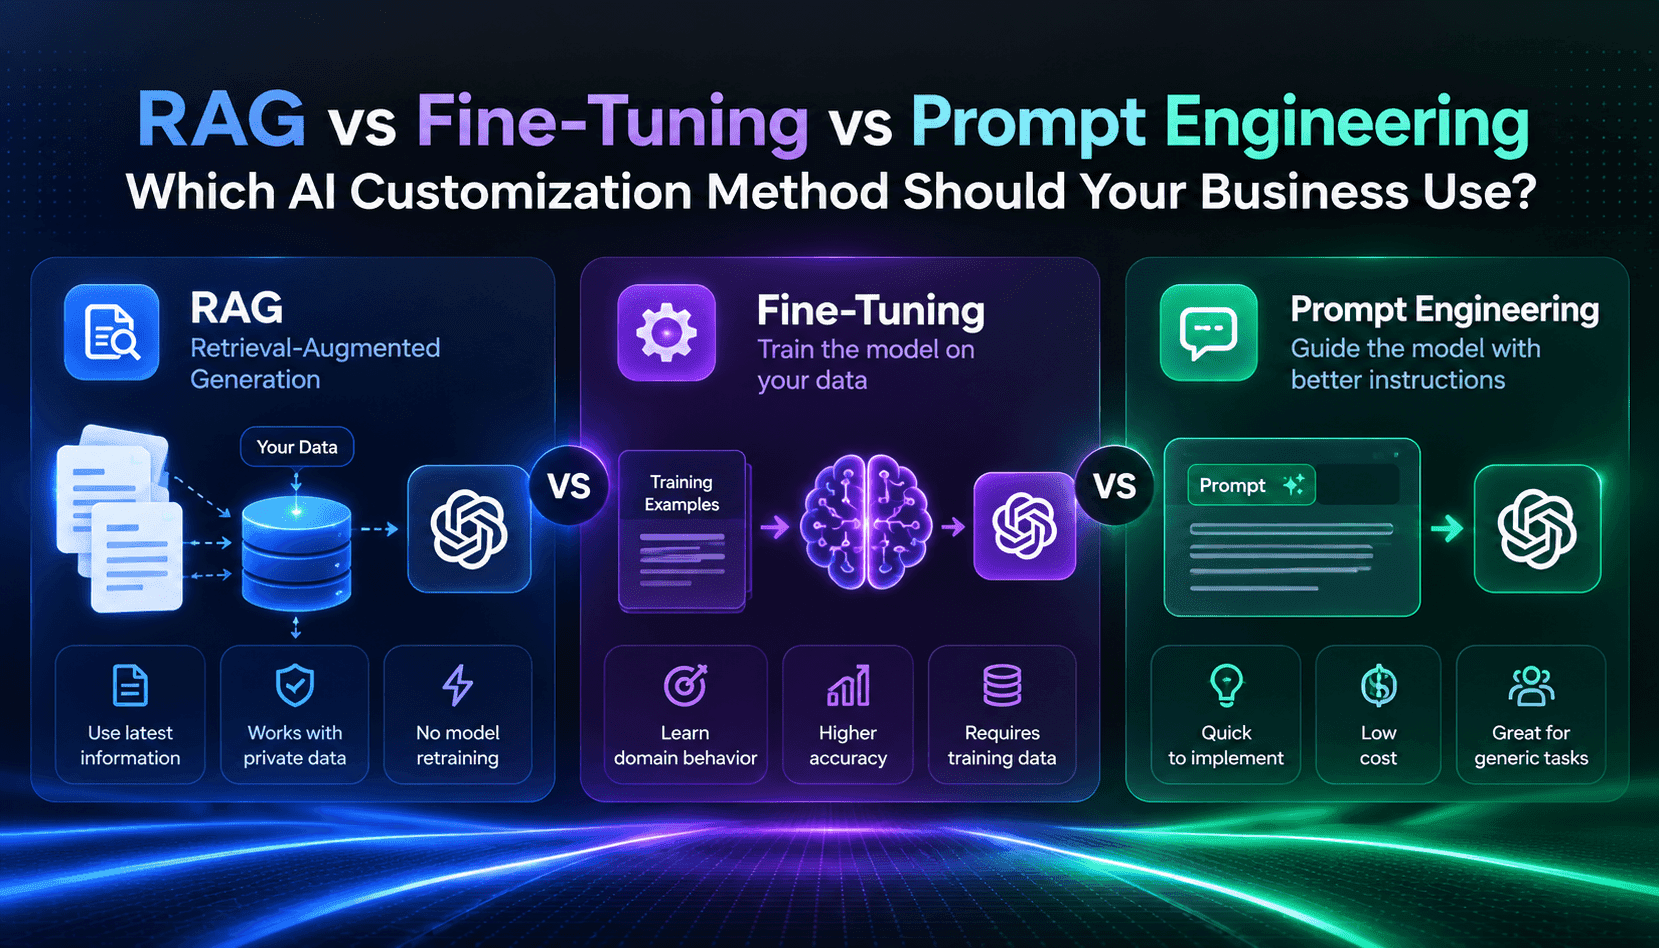
Choisir entre l’ingénierie de prompts, la génération augmentée par récupération (RAG) et le fine-tuning ne consiste pas tant à classer les outils qu’à trouver les leviers adaptés au problème à résoudre. L’ingénierie de prompts ajuste les instructions pour améliorer les réponses sans modifier le modèle. La RAG fournit au modèle, au moment de l’exécution, un contexte à jour, propriétaire ou spécifique à un domaine, afin qu’il puisse raisonner à partir d’informations récentes. Le fine-tuning modifie le comportement du modèle en l’entraînant sur des exemples soigneusement sélectionnés, pour accroître la cohérence et produire des résultats déterministes. Chaque approche influe différemment sur la précision, la latence, les coûts opérationnels, l’exposition des données et la charge de maintenance. Le bon choix dépend donc des contraintes propres à l’entreprise et du coût d’échec de la tâche.
Commencez chaque démarche d’optimisation par un diagnostic : définissez les erreurs qui influent sur les décisions, évaluez le coût des échecs et établissez une référence en travaillant d’abord sur les prompts. Pour de nombreuses tâches — traduction, résumé, classification à petite échelle et rédaction à partir de modèles — des prompts bien conçus et quelques exemples suffisent à atteindre rapidement un niveau de qualité prêt pour la production. Si les réponses sont incorrectes parce que le modèle ne dispose pas d’informations récentes ou de documents internes, la RAG améliore la précision avec relativement peu de travail de développement. Si les erreurs sont liées au comportement — formatage, ton, classification déterministe — ou si vous avez besoin de résultats répétables et auditables à grande échelle, le fine-tuning peut se justifier malgré des coûts de données et d’exploitation plus élevés.
Les coûts de mise en œuvre comptent aussi. L’ingénierie de prompts est rapide et peu coûteuse : faites évoluer les prompts, ajoutez des exemples et instrumentez les résultats. La RAG nécessite de créer un pipeline de récupération, d’indexer les documents et d’optimiser la pertinence ; elle ajoute de la latence et des enjeux de gouvernance des données, mais laisse le modèle inchangé et permet de maintenir les connaissances à jour. Le fine-tuning exige des exemples annotés et sélectionnés avec soin (souvent 50 à 500 ou plus), l’entraînement et le déploiement du modèle, le versionnage, le réentraînement lorsque les spécifications évoluent et des contrôles de sécurité. De nombreux systèmes de production robustes associent la RAG à un modèle affiné pour son comportement, puis utilisent un post-traitement déterministe et des validateurs pour réduire les hallucinations.
Ce guide présente une matrice de décision simple et des étapes pratiques pour différents scénarios — support client, assistants internes de recherche documentaire, analyse de documents, génération de sorties structurées, rédaction spécialisée et classification spécifique — afin d’aider les responsables produit et ingénierie à choisir le levier minimal adapté, à savoir quand passer à l’étape suivante et à concevoir des solutions respectueuses de la confidentialité, de la latence et de la maintenabilité en production.