

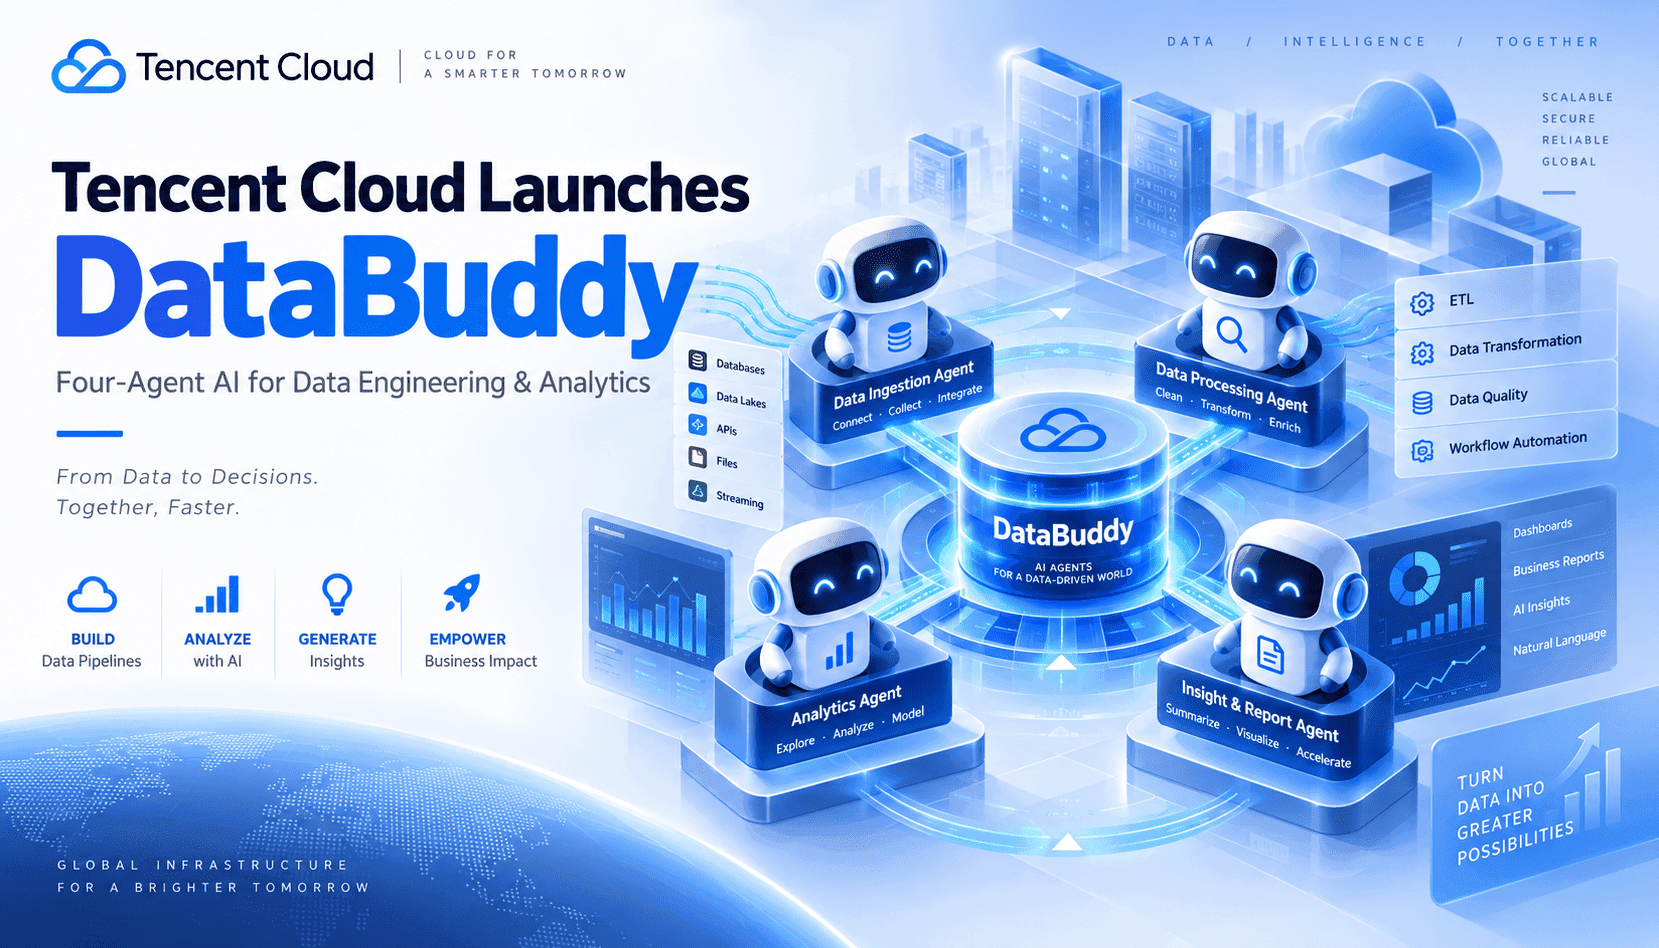
DataBuddy de Tencent Cloud intègre un modèle à quatre agents dans un service qui répond à la douleur la plus chronique des données en entreprise : les changements ETL et BI lents, pilotés par tickets. Plutôt que de passer les demandes par des ingénieurs surchargés, DataBuddy orchestre des agents pour assembler les pipelines, écrire du SQL et expliquer les résultats sous des règles de gouvernance. L’approche est à la fois tranchée et pragmatique : codifier le travail de données routinier en rôles d’agents, les mesurer comme des services, et garder les humains en revue pour l’accès, la confidentialité et les coûts. Ce changement reflète la maturation des DevOps — outils, automatisation et politiques remplaçant les exploits et tableurs.
Sous le capot, un agent planifie les tâches, un autre agit comme ingénieur data en générant connecteurs, transformations et SQL, un troisième fonctionne comme analyste produisant insights et récits, et un quatrième contrôle la qualité et la conformité aux politiques. Ce dernier rôle est crucial : il vérifie les hypothèses de schéma, les jointures, les risques de fuite et l’exposition des données personnelles avant que les résultats ne soient envoyés aux tableaux de bord ou notebooks. Bien instrumentés, les logs capturent les prompts, décisions, codes générés et traçabilité pour que les équipes reproduisent les résultats, annulent les changements et comparent la performance des agents selon les jeux de données — essentiel pour la confiance et l’audit.
Où cela s’intègre-t-il ? Pensez à DataBuddy comme un plan de contrôle entre votre lakehouse et vos consommateurs. Il doit compléter les jobs Spark/SQL existants, la gouvernance des coûts et les outils de catalogage plutôt que les remplacer. Les cas d’usage idéaux sont les changements BI avec arriérés importants, l’exploration ad hoc qui doit respecter les politiques, et les tâches répétitives d’ingestion ou de qualité des données. Les questions ouvertes sont de niveau entreprise : comment il se lie à l’identité, aux catalogues et au réseau VPC ; comment il applique le moindre privilège au niveau table/colonne ; et comment il alloue le calcul pour maîtriser les dépenses sans brider le débit.
Cadre décisionnel : pilotez avec un domaine limité (ex. opérations commerciales ou attribution marketing), une table de faits connue et deux dimensions fiables. Définissez des critères de réussite/échec : temps jusqu’au premier insight, précision des requêtes par rapport au SQL de référence, violations de qualité détectées, et coût par tâche réussie. Dirigez les sorties vers les tableaux de bord existants, pas un nouveau silo. Gardez un réviseur humain pour les exceptions de politique. Si le pilote dépasse les seuils, étendez en ajoutant des produits data, pas des tables aléatoires — traitez chaque produit comme un contrat avec SLA, traçabilité, tests et alertes, avec les agents DataBuddy comme couche d’exécution.