

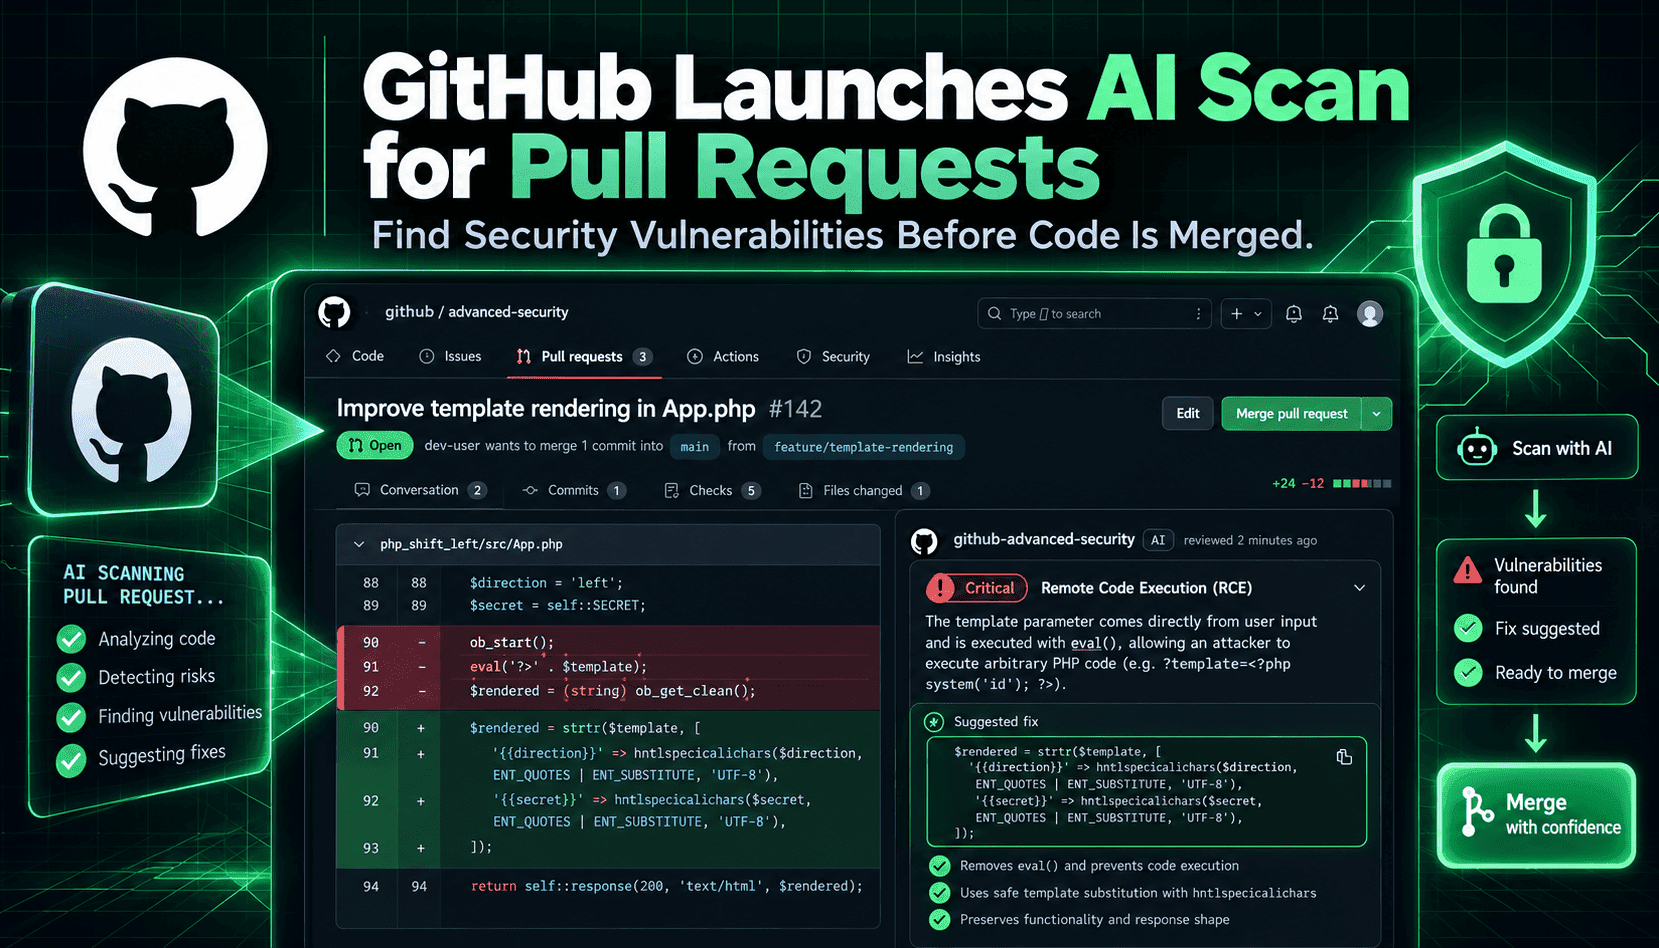
GitHubがプルリクエスト向けAI Scanの一般提供を発表したことは、日々の開発フローにコードセキュリティを組み込む方法が大きく変わる兆しです。AI Scanは、CodeQLの決定論的なパターンマッチングに取って代わるのではなく、変更された行や周辺コード、リポジトリの構造といったプルリクエスト固有のコンテキストに特化したモデルを適用します。この文脈を踏まえた分析により、PHP、Shell、Terraform HCL、Dockerfile、JSP、Blazorなど、CodeQLがまだカバーしていない言語やファイルでも問題を指摘し、自動修正案を提示できます。開発スピードを重視するチームにとって、この組み合わせは、静的解析ルールだけでは見逃しがちな検証漏れ、安全でないデフォルト設定、デプロイ時の設定ミスを早期に検出する可能性をもたらします。
運用面では、コードスキャンとリポジトリのAI Scan設定を有効にするとAI Scanが実行され、ConversationタブとFiles changedタブにCodeQLの結果と並んで表示されます。結果には「AI」の表示が付くため、AIによる指摘だと明確に識別できます。重要なのは、検出結果があくまで助言である点です。コードスキャンのチェックを失敗させたり、ルールセットによってマージをブロックしたりすることはありません。この設計からは、強制的なゲートを設けずにフィードバックを迅速化し、最終判断は開発者に委ねるというGitHubの意図がうかがえます。組織にとっては、助言型のAI検出結果をトリアージにどう組み込むか、人による承認をいつ必須にするか、AI生成の自動修正を既存のCI/CDやセキュリティポリシーとどう整合させるかが課題になります。
技術的に見ると、AIを活用したスキャンは従来の静的解析と実務上、主に3つの点で異なります。第一に、モデルは複数ファイルにまたがるコンテキストを捉え、構文ルールだけに頼らず、コードパターンやコメントから意図を推測できます。第二に、コードの文脈を踏まえながらも確率的に生成される、実用的な修正案(自動修正)を提示できます。第三に、成熟したクエリライブラリが整備されていない言語や設定ファイルも対象にできます。一方で、こうした強みには、実際には存在しない修正案、見落とされたエッジケース、過度に広い断定といった固有の失敗も伴います。そのため、AIの検出結果を確かな判断材料として扱う前に、検証と再現可能な人間参加型のワークフローを整えることが不可欠です。
実務では、AI Scanを多層的なセキュリティ戦略に加える新たなシグナルとして扱いましょう。問題の早期発見や、PR上の説明の充実に活用し、リスクが低くノイズの多い指摘は自動却下ルールでトリアージを効率化します。認証、認可、暗号処理、インジェクションにつながる経路など、リスクの高い指摘については、人による確認を必須にし、CodeQLやSASTツール、プルリクエストのテストと照合してください。運用状況の可視化も重要です。AIクレジットの使用量を記録し、自動修正の監査証跡を保管して、誤検知を追跡することで、モデルの挙動を調整したり、リポジトリ単位の設定で対象範囲を制限したりできます。