

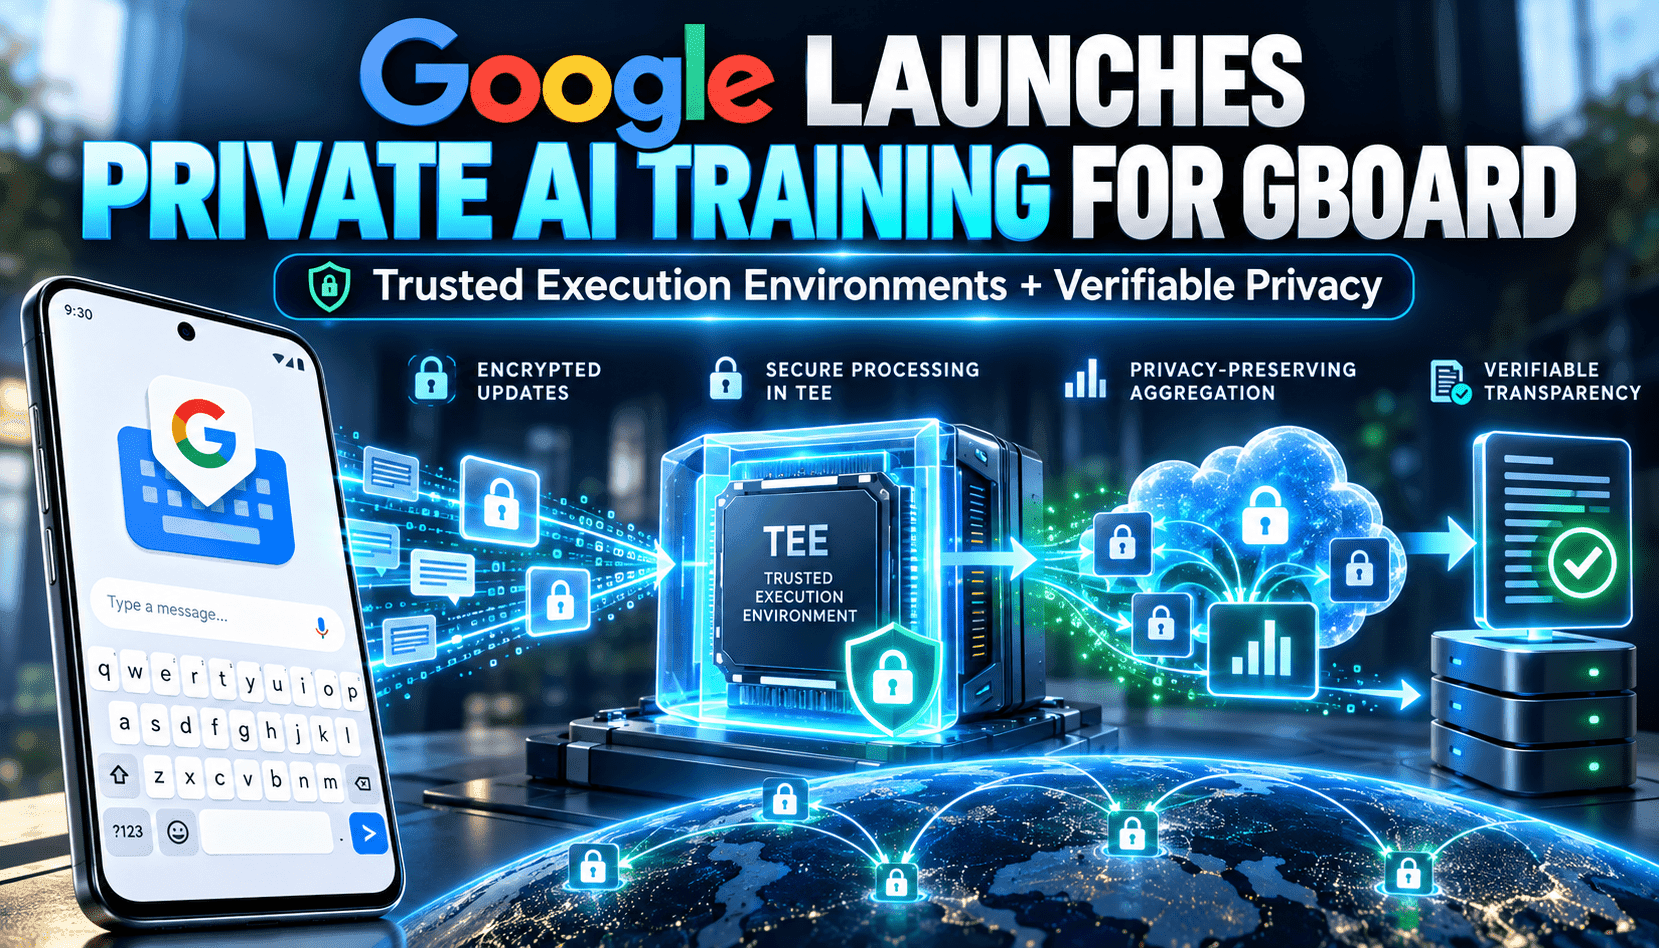
Googleの発表は、連合学習の実践における大きな転換点です。従来のように主としてクライアント側の計算処理やサーバー運用者への信頼に頼るのではなく、新システムでは端末の学習データを暗号化してアップロードし、サーバー側の処理をアテステーション済みのTrusted Execution Environment(TEE)内に限定します。端末は、事前に許可したアクセス・ポリシーを公開透明性ログに記録します。そのうえでKey Management System(KMS)は、アテステーションされたワークロードがポリシーに合致する場合に限り、TEEへ復号鍵を払い出します。暗号化アップロード、検証可能な実行、ポリシーとの紐付けを組み合わせることで、システムが約束どおりに動作したかを外部の検証者が確認できる、監査可能な経路が生まれます。
運用面では、学習の高速化、より大規模なコホート、Gboardの精度向上という製品上の目標は変わりません。その一方で、プライバシーを裏付ける証拠はより強化されます。計算負荷の高い処理をサーバー側のTEEに移すことで、端末の稼働状況やCPU性能のばらつきへの依存が減り、学習スケジュールの調整、差分プライバシー(DP)パラメーターの精密な調整、複数のワーカーTEEでの並列実行が可能になります。実際、Gboardの次単語予測モデルでは学習時間が大幅に短縮されました。また、コホート選択の最適化と、監査可能な一元的オーケストレーションにより、ノイズ乗数を小さくできるようになっています。
監査担当者やプライバシーチームにとって重要なのは、このアーキテクチャが、信頼に関する課題の異なる側面に対応する技術的な仕組みを連携させている点です。再現可能なビルドとオープンソースコードにより、第三者がバイナリを再構築できます。Rekorのような透明性ログで、許可されたワークロードの一覧が公開されます。アテステーションとKMSのポリシーチェックによって、鍵が特定のアテステーション済みコードに紐付けられます。そして差分プライバシーにより、公開される集約モデルの重みから個人データが漏れるのを防ぎます。導入環境が実際に運用者への信頼を不要にするかを評価するには、各要素を個別に見るのではなく、それらがどう連携するかを理解する必要があります。