

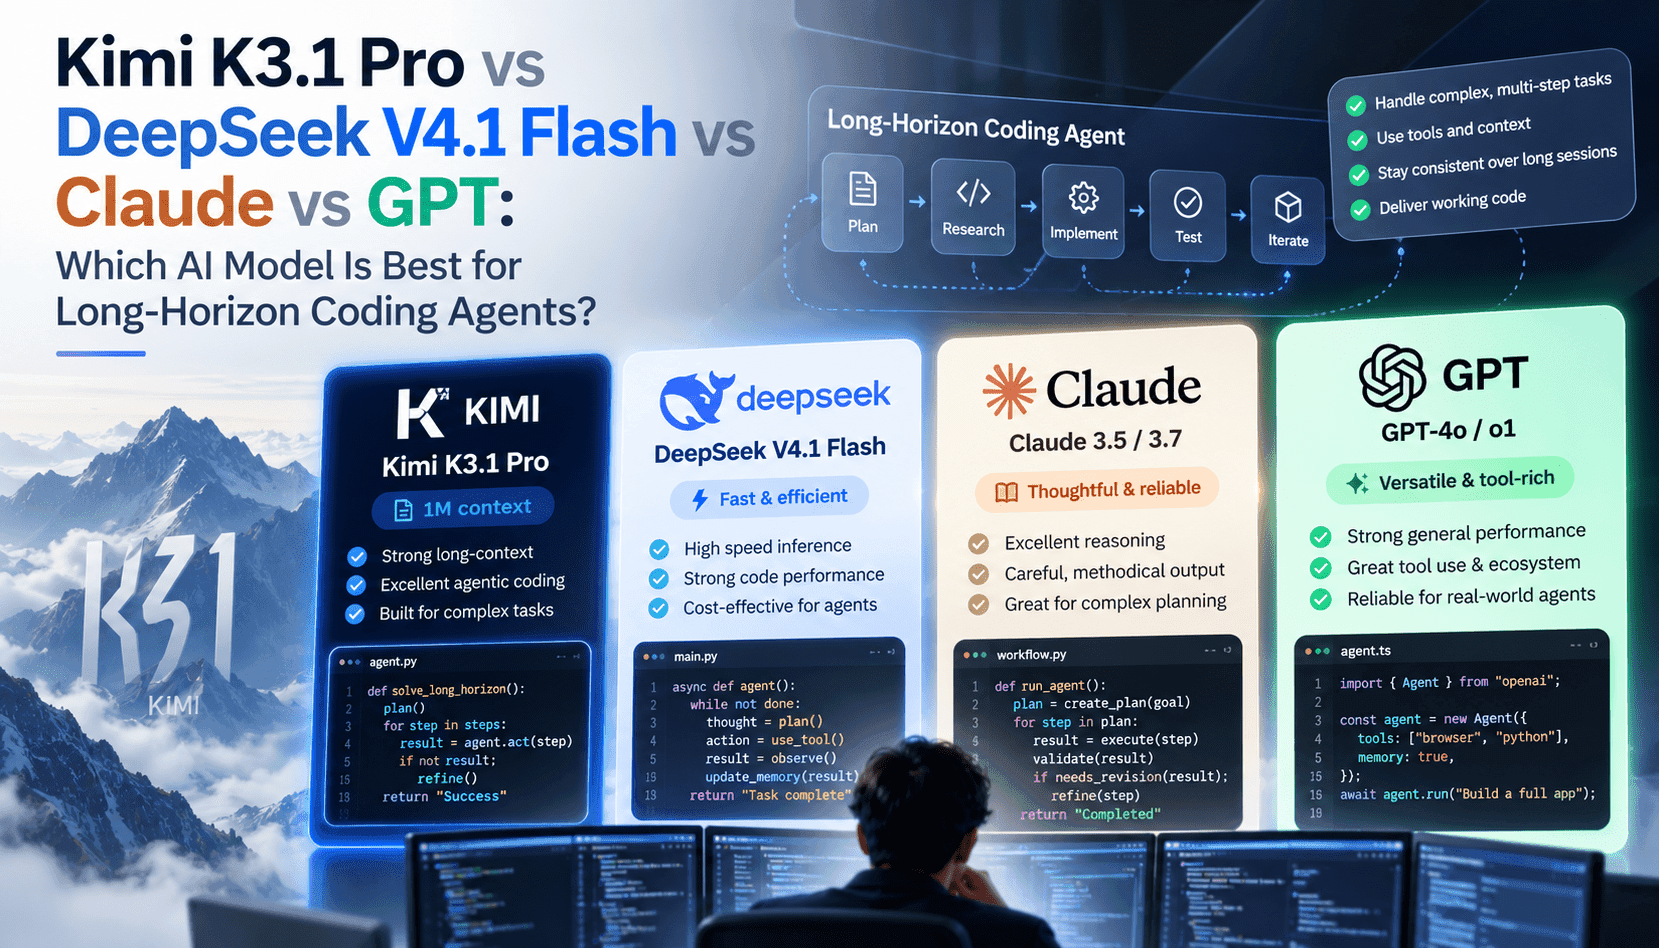
長期稼働型のコーディングエージェントは、単発のコード補完とは異なる観点で評価する必要があります。多数のツール呼び出しをまたいだ一貫した推論、セッション間での堅牢な状態キャッシュ、効率的な差分更新、そして開発タスクごとの予測可能なコストが求められます。Kimi K3.1 Proの100万トークンのコンテキストウィンドウと、思考モードの機能は、こうしたワークフローを明確に意識したものです。一方、DeepSeekのFlash版は低レイテンシと高いストリーミング処理能力を重視し、Claudeは安全性と制御しやすい推論を重視します。GPT系モデルには幅広いエコシステムがあり、会話型ツールチェーンも最高水準であることが少なくありません。エンジニアリングチームにとって重要なのは、どのモデルが絶対的に「最良」かではなく、自社のリポジトリ規模、CI/CDの実行頻度、予算、許容できるリスクにどれが合うかです。
モデルの機能をエージェントのワークフローに当てはめると、実践的なトレードオフが見えてきます。複数のモジュールにまたがる履歴、長大な設計文書、蓄積されたツール出力を踏まえた推論が必要な場合、100万トークンのコンテキストが役立ちます。たとえば、複数PRにまたがるリファクタリングや、複数リポジトリの移行などです。ただし、無関係なトークンの送信を避けるには、選択的なコンテキスト圧縮、検索拡張プロンプト、セッションキャッシュの戦略が欠かせません。K3.1 Pro HighspeedやDeepSeek Flashのような高速推論モデルは、処理時間と開発者の待ち時間を短縮します。しかし、本番環境の運用コストが実際に下がるかどうかは、トークン単価、バッチサイズ、入出力のオーバーヘッドによって決まります。
オープンウェイトモデルを選ぶと、デプロイの前提が変わります。自社のプライベートなハードウェア上でエージェントを稼働させ、テレメトリーを管理し、ベンダーロックインを避けられる一方、サービング時のレイテンシ、長いコンテキストのシャーディング、安全フィルターの更新といった運用負荷も引き受けることになります。プロプライエタリな最先端モデルを選べば、すぐに得られる利点もあります。初期状態での高い推論能力、統合されたツールエコシステム、そして運用管理されたガードレールにより、エンジニアリングの負担を軽減できます。データプライバシーやオンプレミスでの低レイテンシを優先するのか、それとも統合の手間を抑え、安全性の更新やモデル改善を提供事業者のSLAに委ねるのかによって、適切な選択は異なります。
モデルの性能だけでなく、マルチツールエージェント内での振る舞いも評価しましょう。決定性のあるツール呼び出し仕様、構造化された思考モード、ツール出力のストリーミング、権限に基づく承認に対応しているでしょうか。Kimiの思考モードとセッション制御は、長い処理の中でのハルシネーションを抑えることを目指しています。DeepSeek Flashの処理性能は、厳しいCIループでのタイムアウトを減らします。Claudeは安全性を優先したヒューリスティクスにより、厳格なコンプライアンス要件を持つ企業に適しています。GPT系モデルは、豊富なエコシステム連携やサードパーティ製のオーケストレーションフレームワークを活用できます。統合のしやすさ、監査可能性、計画の途中でツールが失敗した際の復旧動作も含めて比較してください。