

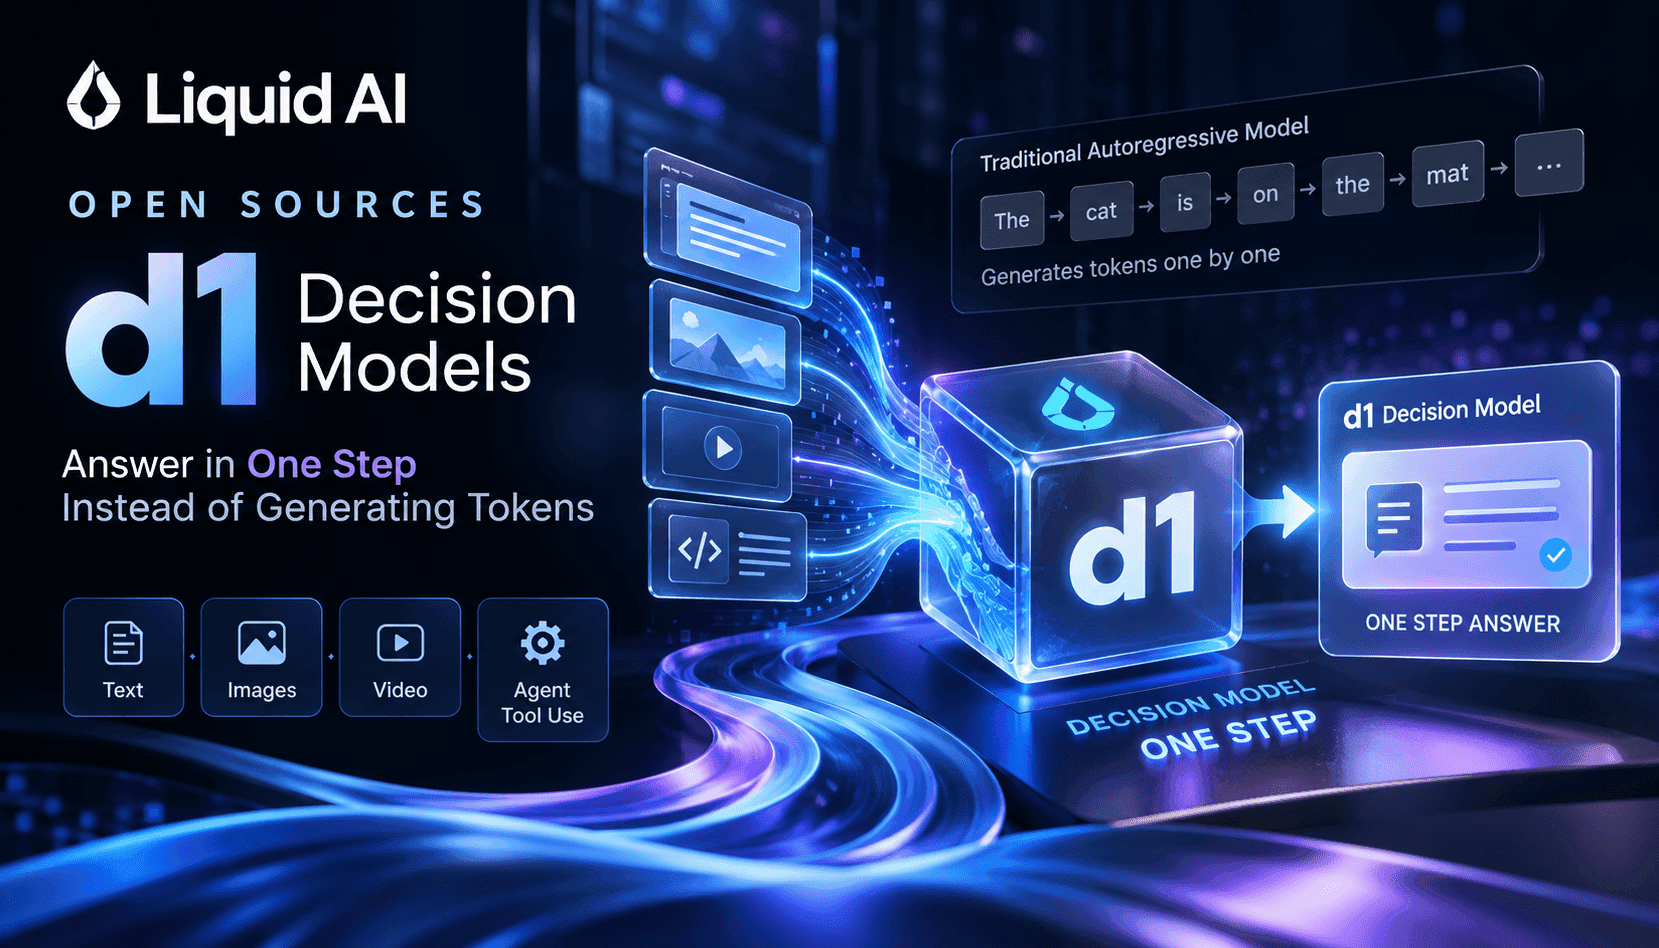
Liquid AIのd1シリーズの発表は、自己回帰型のトークン生成から、構造化された判断を出力するモデルへの明確な転換を示しています。これらのモデルは、1回の順伝播で離散ラベルに対する確率分布を校正して出力します。回答をトークン単位で組み立てるLLMとは異なり、意思決定モデルは入力を評価し、信頼度を示すコンパクトなベクトルを返します。APIレベルではわずかな違いに見えますが、会話文ではなく、決定的で高速かつ監査可能な結果を必要とするシステムにとっては大きな意味があります。
実用面では、d1-3Bとd1-omni-600Mは、生成の流暢さよりも処理能力と解釈しやすさが重視される用途を想定しています。チケットの振り分け、スパムフィルタリング、コンテンツモデレーション、製造現場での品質管理の一次判定、産業分類では、1ステップで判断できることによりリクエスト処理が短縮され、デコードのばらつきがなくなります。また、確率をしきい値判定や校正に利用し、ログに記録したうえで、追加の解析処理やハルシネーションのリスクなしに、後続のルールエンジンや自動化パイプラインへ渡せます。
エンジニアやプロダクトオーナーにとって、運用面でのメリットは明らかです。出力が決定的になることで監視が容易になり、トークン化の細かな差異による再試行を減らせます。また、自己回帰デコードのループが不要なため、計算コストも抑えられます。コンプライアンスや監査証跡の観点でも、確率ベクトルとモデルのバージョンを記録するほうが、自由形式のテキストより記録・検証しやすくなります。一方、意思決定モデルの導入には新たな評価手法が必要です。本番環境の各データ区分で校正を検証し、分布外のケースに対する現実的なフォールバックを設計しなければなりません。
この記事では、何が変わったのか、1ステップの意思決定出力の価値をどう測るのか、エッジおよびクラウドでのデプロイパターン、統合時の落とし穴を解説します。さらに、トークン生成型のソリューションを本番ワークフローの校正済み意思決定モデルに置き換えたいチーム向けに、簡潔な運用チェックリストも紹介します。