

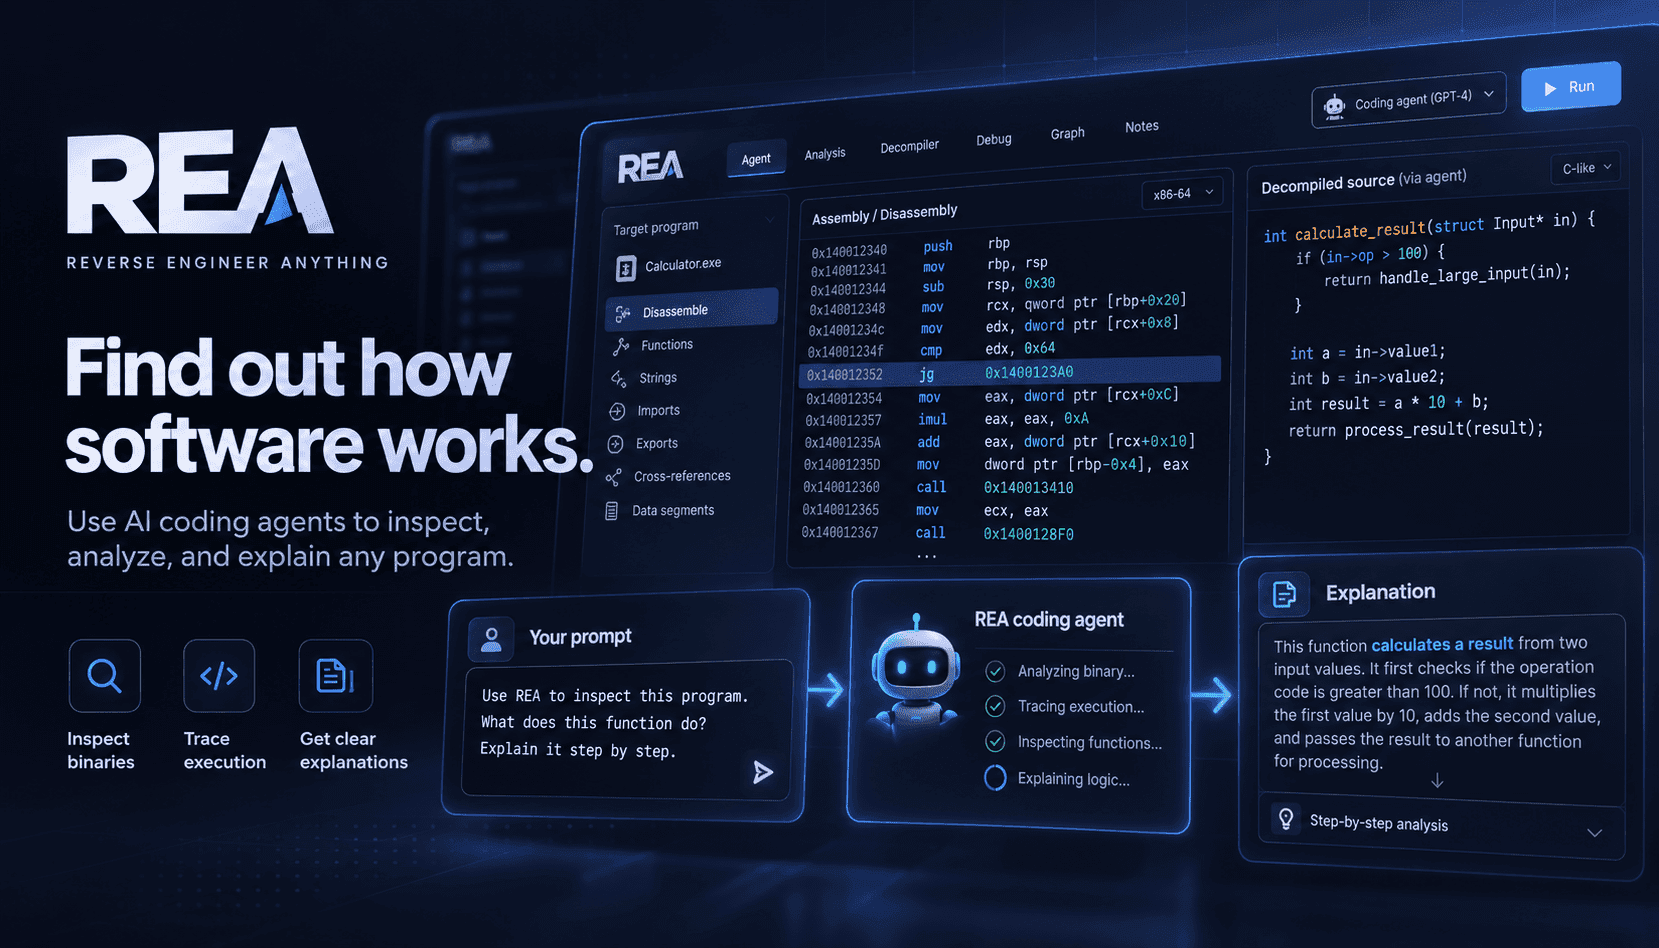
REA(Reverse Engineer Anything)は、リバースエンジニアリングを、ローカルのMCP(Model Context Protocol)サーバーを介してAIエージェントが統括できるツールチェーンとして捉え直します。人間が静的・動的解析ツールを手作業でつなぐのではなく、REAがワークフロー、証拠の取り扱いルール、プロバイダー用アダプターを提供。これにより、エージェントはネイティブ解析エンジン(Ghidra、Hopper、IDA)、JavaScript/Electronパーサー、.NETインスペクター、APKデコンパイラー、実行時キャプチャツールを呼び出せます。その結果、エージェントが手順を実行し、REAが追跡可能な証拠とともに調査結果を返し、エージェントが結論と再構築の手引きをまとめる、体系的な調査が実現します。
このパイプラインは、自分たちで制御できない機能を調査するチームの進め方を大きく変えます。エージェントは、記録されたUI操作を起点に、ネットワークトレースやIPCの境界をたどり、関連する文字列やリソース参照を抽出し、手がかりが見つかれば対象を絞ったバイナリトレースへと調査を深められます。REAは、こうした成果物を設定済みのネイティブプロバイダーによる逆コンパイル済み擬似コードやアセンブリ表示に対応付け、呼び出し・参照グラフを添えて、エージェントが各推論の根拠を説明できる形でまとめます。自動化と証拠を組み合わせることで、再構築の再現性とレビュー可能性が高まります。
連携機能、移行ツール、互換レイヤーを開発するチームにとって、REAがローカルファーストで設計されている点は重要です。解析は第三者のクラウドサービスではなく、調査担当者のマシンまたは自社インフラ上で実行されます。これにより、データ流出のリスクを抑え、解析対象の成果物に関する法的管理権を維持できます。さらにREAは、ウェブサイト、Electronアプリ、.NETアセンブリ、Android APK、ファームウェア、生のパケットキャプチャなど、多様な対象に対応。ひとつのエージェント環境で、レガシーソフトウェアや独自ソフトウェア全体の調査手順を標準化できます。
導入には、運用担当者の規律が欠かせません。ネイティブ領域を深く解析する場合、IDAやHopperを使うにはライセンス済みのバイナリが必要です。また、開始前に許可の有無、ライセンス状況、再構築の範囲を文書化する必要があります。REAには、何を観測し、何が曖昧なまま残ったのかを明確にするための証拠フィールドと制約フィールドが用意されています。ただし、この透明性を活かすには、法務レビューと社内ガードレールを組み合わせ、相互運用性の確保、セキュリティ研究、自社ソフトウェアの保守といった許可された用途にリバースエンジニアリングを限定しなければなりません。