

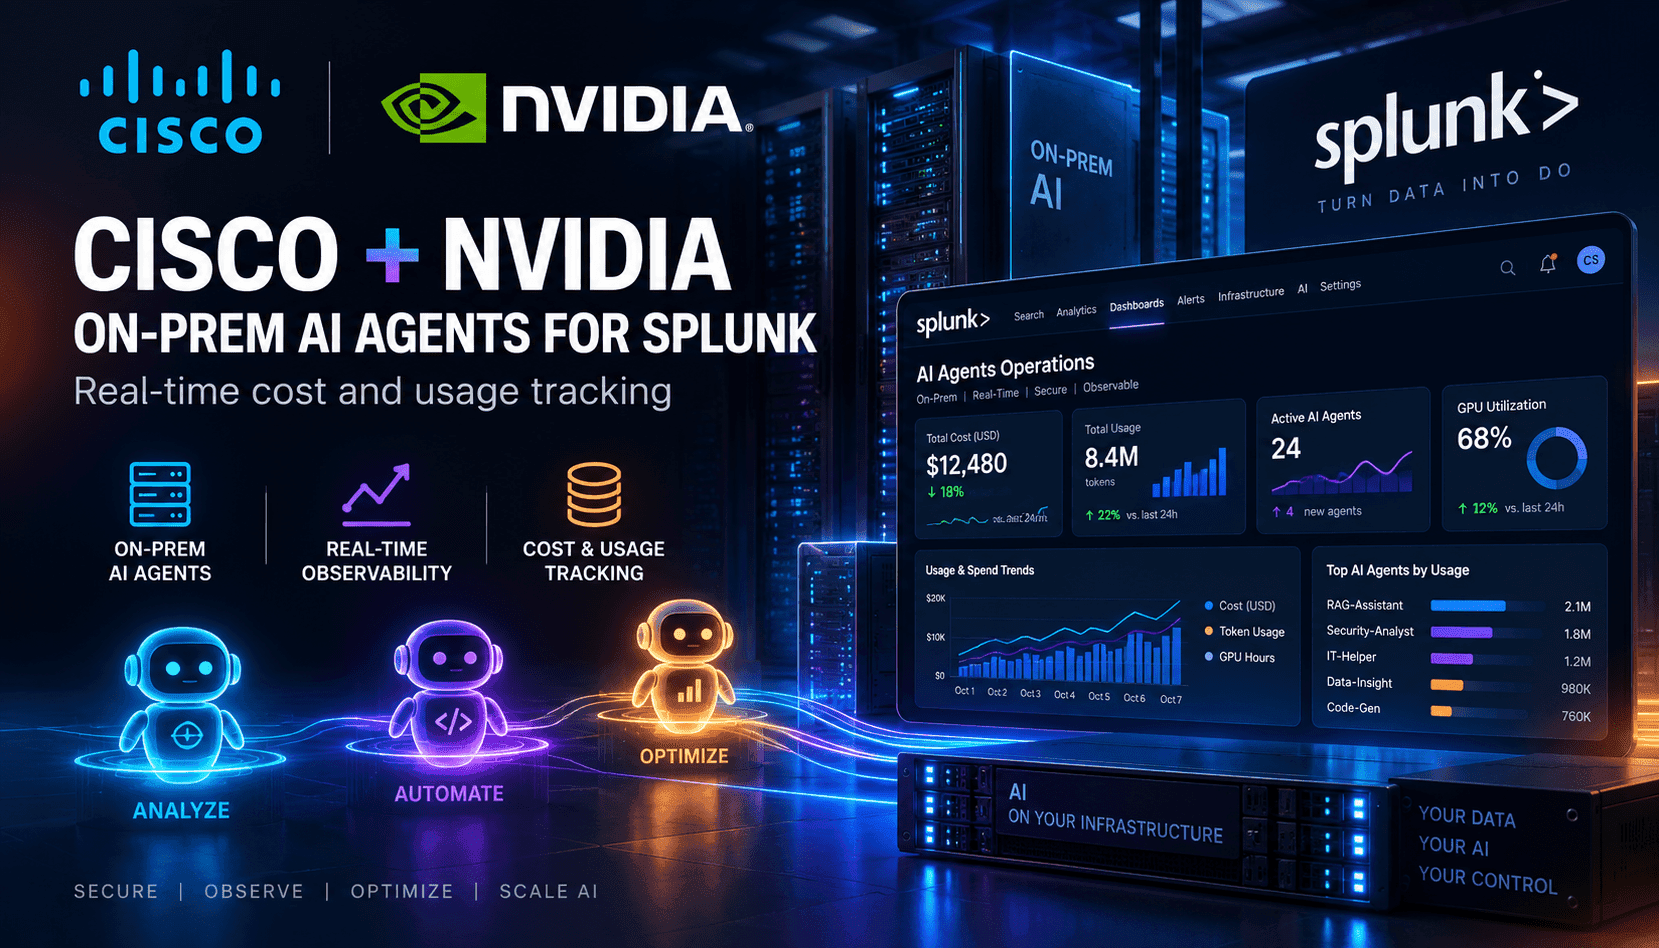
Splunk에서 텔레메트리를 중앙 집중화하는 기업들은 오랫동안 주권과 보안을 위해 데이터를 온프레미스에 유지할지, 최신 AI 에이전트에 접근하기 위해 클라우드로 이동할지의 딜레마에 직면해 왔습니다. NVIDIA 가속 컴퓨팅과 쿠버네티스 런타임 기반으로 구축된 Cisco의 새로운 Splunk용 AI POD는 이 간극을 해소합니다. 팀은 로그와 메트릭 옆에서 Splunk AI 어시스턴트와 신흥 에이전트 런치패드를 실행하면서 오픈 및 독점 모델을 혼합해 자체 호스팅할 수 있습니다. 사전 검증된 스택은 통합 위험과 가치 실현 시간을 줄여 운영 및 보안 팀에 기존 관측 환경과 동일한 제어로 강화할 수 있는 에이전트 기반을 제공합니다.
주목할 만한 운영 변화는 비용 및 행동 가시성입니다. Splunk Agent Observability의 토크노믹스 기능은 Claude Code, Codex, Cursor와 같은 코딩 에이전트를 포함해 에이전트, 사용자, 워크플로우별 토큰 사용량을 추적해 리더들이 채택을 가치에 연결할 수 있게 합니다. 시계열 모델링으로 소비를 예측하고, 무한 루프에 대해 경고하며, 비용을 사업부에 귀속시킵니다. 동일 플랫폼이 프롬프트, 응답, 도구 호출을 검사하므로 팀은 런타임 가드레일을 적용해 위험한 행동을 차단하고 환각 현상을 억제할 수 있습니다. 실제로 예산 설정, 실시간 과다 사용 방지, 단위 경제학으로 ROI 입증이 가능해져 월말의 놀라움을 줄입니다.
전략적으로 이 아키텍처는 파일럿에서 관리되는 에이전트 패브릭으로의 전환을 가속화합니다. 모델 실행을 데이터 근처로 가져옴으로써 기업은 취약한 ETL 경로를 피하고 데이터 유출 위험을 줄입니다. 모델 선택은 유연하게 유지됩니다: 팀은 NVIDIA의 Nemotron 계열과 같은 오픈 웨이트 옵션을 Cisco의 Deep Time Series Model과 같은 도메인 특화 모델과 함께 실행할 수 있습니다. 대가는 운영 성숙도입니다—쿠버네티스, GPU 스케줄링, 모델 평가, 프롬프트 위험 관리를 일급 과제로 다뤄야 합니다. 구매자 입장에서는 “여기에 AI를 사용할 수 있나?”에서 “어떤 에이전트가 어떤 하드웨어와 가드레일 하에서 가치를 창출하는가?”로 질문이 바뀝니다. 정확히 답하는 조직이 더 적은 재작성으로 더 빠르게 확장할 것입니다.