

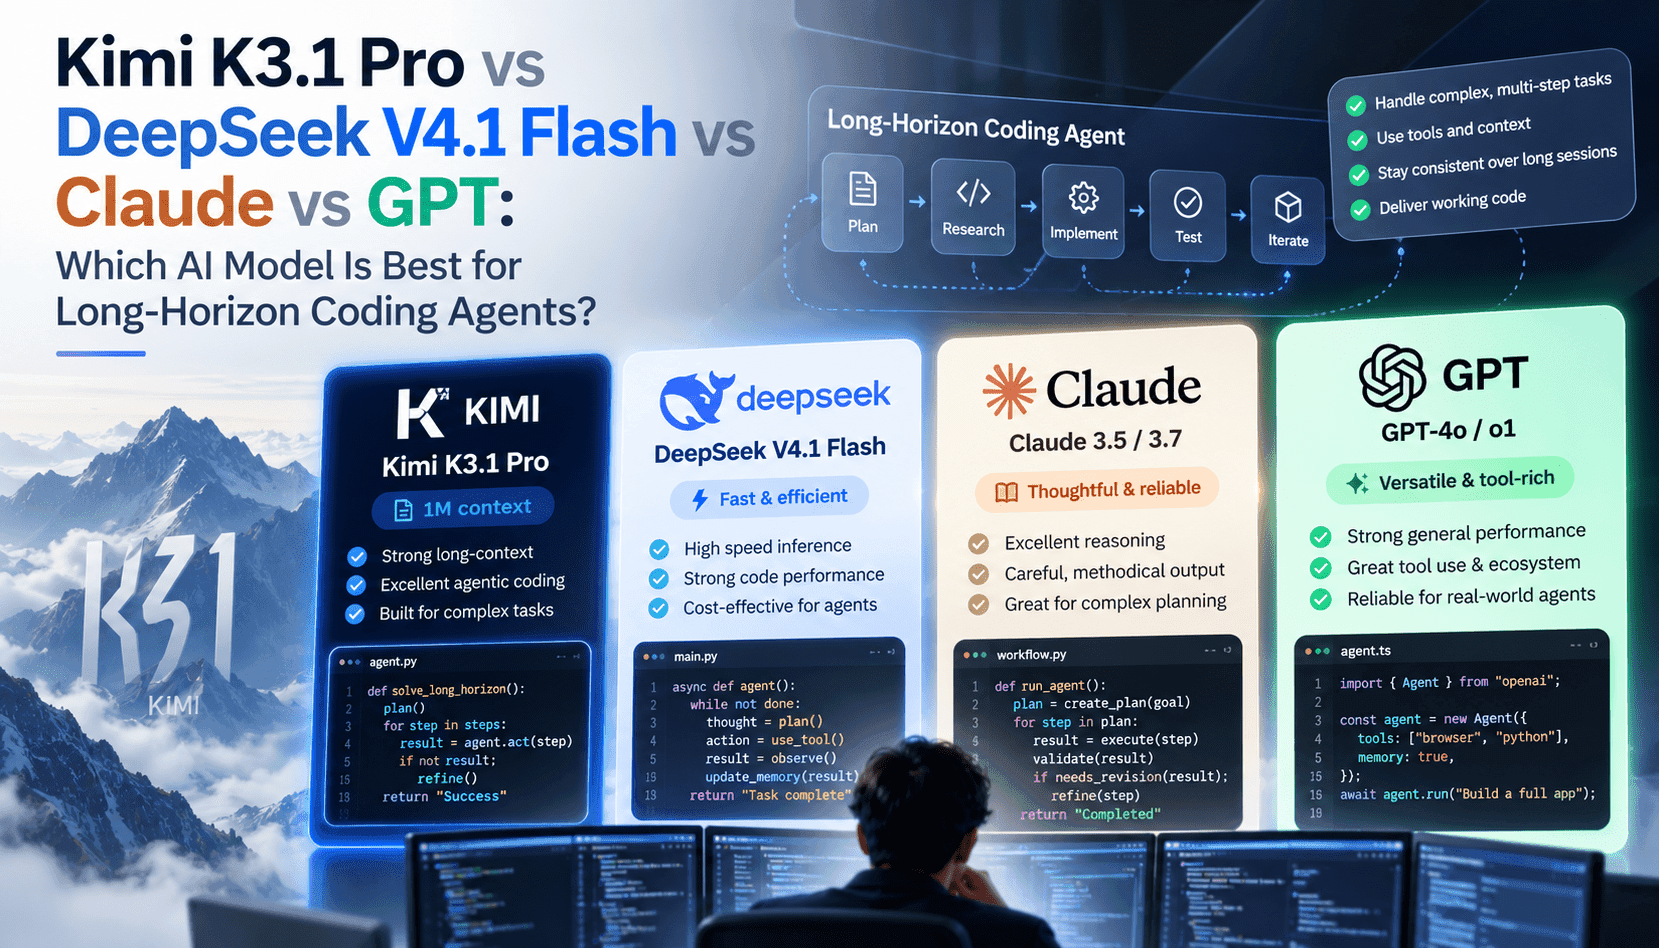
장기 작업을 수행하는 코딩 에이전트는 한 번의 코드 완성 작업과는 다른 기준으로 평가해야 합니다. 여러 차례의 도구 호출에 걸쳐 추론을 이어 가고, 세션 간 상태를 안정적으로 캐싱하며, 변경분을 효율적으로 반영하고, 개발자 작업당 비용을 예측할 수 있어야 합니다. Kimi K3.1 Pro의 100만 토큰 컨텍스트 창과 사고 모드 기능은 이러한 작업 흐름을 겨냥합니다. DeepSeek의 Flash 버전은 지연 시간과 스트리밍 처리량을 우선시하고, Claude는 안전성과 제어 가능한 추론을 강조하며, GPT 계열 모델은 폭넓은 생태계와 대체로 업계 최고 수준의 대화형 도구 체계를 제공합니다. 엔지니어링 팀이 물어야 할 것은 어떤 모델이 객관적으로 ‘최고’인가가 아니라, 자사의 저장소 규모와 CI/CD 주기, 예산, 위험 허용 수준에 어떤 모델이 가장 잘 맞는가입니다.
모델의 기능을 에이전트 작업 흐름에 대입해 보면 실질적인 절충점이 드러납니다. 여러 모듈에 걸친 이력과 긴 설계 문서, 누적된 도구 출력까지 고려해야 하는 에이전트라면 100만 토큰 컨텍스트가 유용합니다. 여러 PR에 걸친 리팩터링이나 여러 저장소의 마이그레이션이 대표적인 사례입니다. 하지만 관련 없는 토큰을 보내지 않도록 에이전트가 선택적 압축, 검색 증강 프롬프팅, 세션 캐시 전략을 활용해야만 그 장점을 제대로 누릴 수 있습니다. 추론 속도가 빠르면(K3.1 Pro Highspeed 또는 DeepSeek Flash) 전체 처리 시간이 줄고 개발자의 대기 시간도 짧아집니다. 그렇더라도 실제 운영 비용이 낮아지는지는 토큰당 비용, 배치 크기, 입출력 오버헤드에 따라 달라집니다.
오픈 웨이트 모델은 배포의 손익 계산을 바꿉니다. 팀은 자체 보유 하드웨어에서 에이전트를 실행하고 텔레메트리를 통제하며 특정 공급업체에 종속되는 일을 피할 수 있지만, 서빙 지연 시간 관리, 긴 컨텍스트 분할, 안전 필터 최신화 같은 운영 부담도 직접 떠안게 됩니다. 독점 프런티어 모델은 여전히 개발 시간을 아껴 줍니다. 즉시 활용할 수 있는 뛰어난 추론 능력과 통합 도구 생태계, 관리형 안전장치 덕분에 엔지니어링 부담이 줄어듭니다. 데이터 프라이버시와 온프레미스 지연 시간을 중시하는지, 아니면 통합 작업을 최소화하고 안전성 업데이트와 모델 개선을 제공업체의 SLA에 맡기고 싶은지에 따라 적절한 선택이 달라집니다.
기본 성능만 볼 것이 아니라 멀티 도구 에이전트 안에서 모델이 어떻게 작동하는지도 평가해야 합니다. 결정론적인 도구 호출 명세, 구조화된 사고 모드, 스트리밍 도구 출력, 권한 기반 승인 기능을 지원하는지 확인하세요. Kimi의 사고 모드와 세션 제어 기능은 긴 작업 흐름에서 환각을 줄이는 데 초점을 맞춥니다. DeepSeek Flash의 성능은 촉박한 CI 루프에서 시간 초과를 줄여 줍니다. Claude의 안전 우선 휴리스틱은 엄격한 규정 준수가 필요한 기업에 매력적이며, GPT 계열 모델은 풍부한 생태계 커넥터와 서드파티 오케스트레이션 프레임워크를 활용할 수 있습니다. 도구가 계획 도중 실패할 때의 복구 방식뿐 아니라 각 모델의 통합 난이도와 감사 가능성도 함께 따져 보세요.