

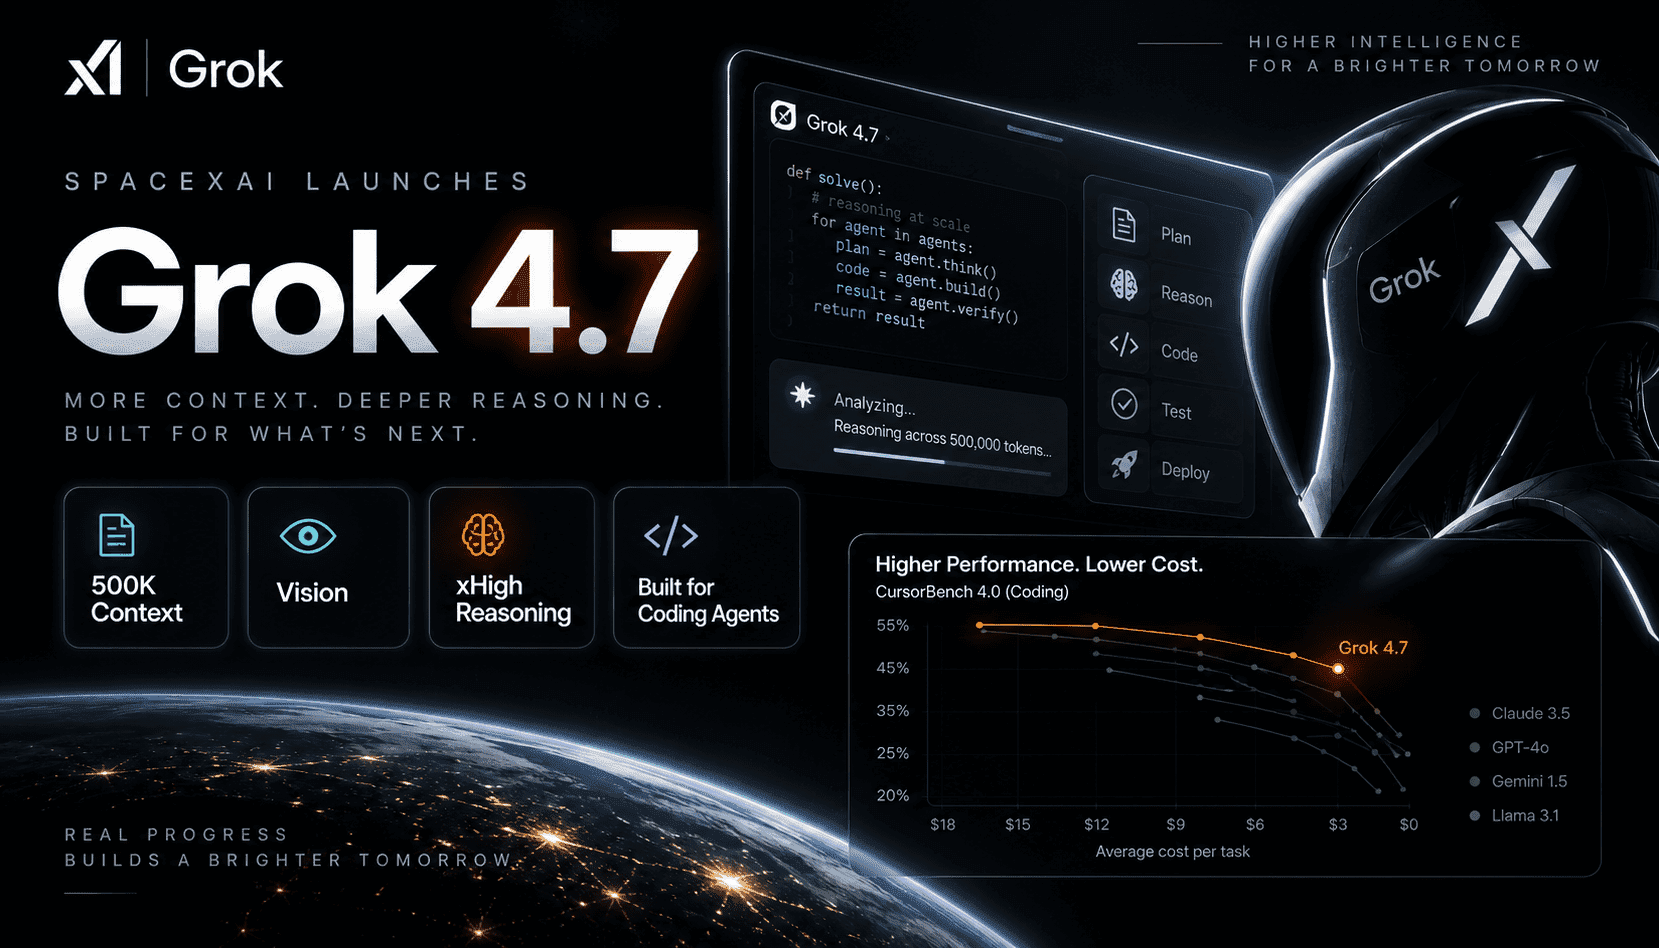
SpaceXAI의 Grok 4.7은 지속적인 코딩과 지식 작업을 위해 설계되었습니다. 50만 토큰 컨텍스트 윈도우는 전체 저장소, 다중 파일 차이, 방대한 사양 문서 등을 메모리에 유지할 수 있어 검색 반복을 줄여줍니다. 모델의 네이티브 비전 기능은 디버깅 스크린샷, 차트 검토, UI 상태 설명에 유용성을 더합니다. 무엇보다 4.7은 xHigh 추론과 자기 검증에 중점을 두어 도구 간 전환을 줄이고 더 길고 신뢰할 수 있는 다단계 실행을 가능하게 합니다. 4.6과 동일한 가격대에 빠른 변형도 제공되어 개발자 환경, 코딩 에이전트, 그리고 이전 컨텍스트 및 검증 한계가 마찰을 일으켰던 다시간 전문 작업을 직접 겨냥합니다.
초기 신호는 장시간 실행되는 코드 작업에서 강력한 가격 대비 성능을 보여줍니다. CursorBench 4.0에서의 개선과 다시간 사무 및 터미널 작업에서의 향상된 지속력이 그 예입니다. DeepSWE와 EEBench에서의 성과는 기술 분야에서 더 강력한 추론 정확도와 오류 복구를 시사하며, 모델의 하니스 인지 훈련은 에이전트 워크플로우에서 대화 흐름 이탈을 줄이는 데 목적을 둡니다. 더 긴 컨텍스트와 안전한 기본 설정의 조합은 아키텍처를 단순화하여 덜 복잡한 청킹, 경량 검색기, 그리고 작은 프롬프트 구조를 가능하게 합니다. 대규모 사양서나 규정 준수 문서를 다루는 팀에게 4.7의 확장된 작업 메모리는 다중 패스 흐름을 단일 패스 계획으로 전환하고, 컨텍스트 내 스크래치패드와 구조화된 자기 검증을 지원할 수 있습니다.
안전성도 눈에 띄게 강화되었습니다. 새로운 보호 스택은 강력한 탈옥 저항과 더 나은 이중 용도 처리 능력을 보고하며, 합법적인 보안 작업을 과도하게 차단하지 않습니다. 이는 에이전트 시스템이 종종 터미널, 코드 실행, 민감한 데이터와 교차하는 기업 도입에 매우 중요합니다. 운영 측면에서 4.7은 API, 코딩 하니스, 라우터를 통해 제공되며 입력 토큰당 200만 분의 2달러, 출력 토큰당 200만 분의 6달러의 가격으로 이용할 수 있고, 두 배 속도와 가격의 선택적 빠른 티어도 있습니다. 팀은 실제 작업 부하에서 직접 비교 파일럿을 실행하여 작업 완료 품질, 도구 호출 신뢰성, 완료된 작업당 총 비용을 측정해야 하며, 단순 지연 시간이나 단발 벤치마크 점수에 의존하지 않아야 합니다.