

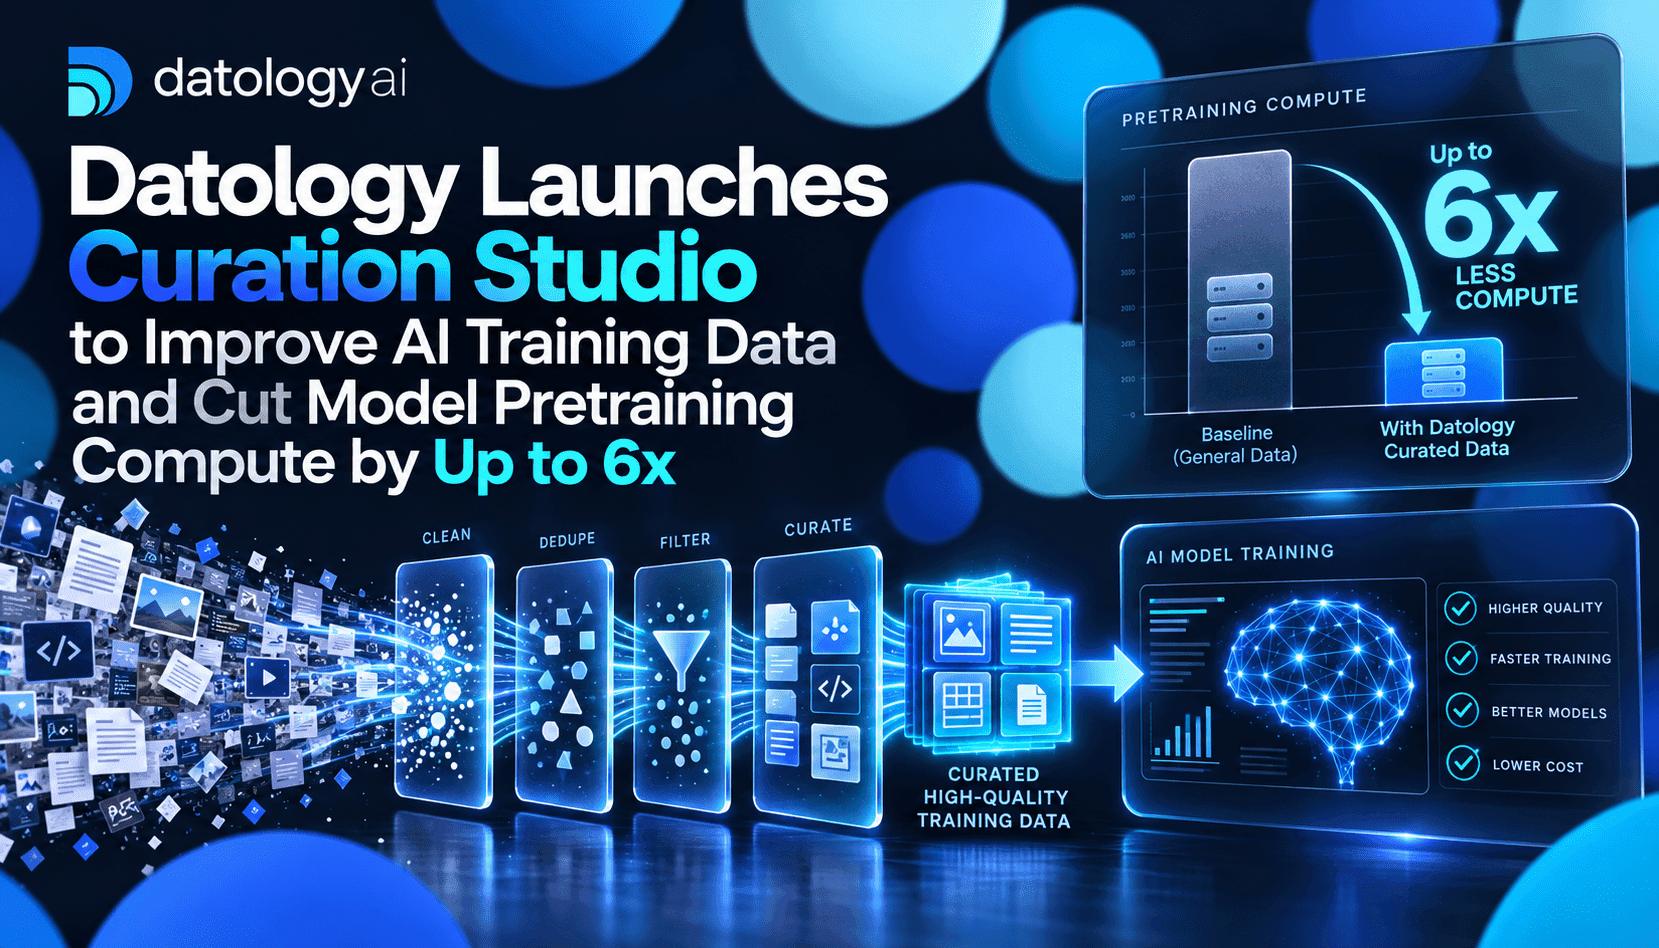
O novo Curation Studio da Datology se apresenta como uma camada operacional entre o conteúdo bruto e o treinamento de modelos. Em vez de simplesmente ingerir quantidades cada vez maiores de tokens, o produto aplica um fluxo de quatro etapas — limpar, calibrar, criar e compor — para identificar os sinais de maior valor para as tarefas que importam para você. Essa abordagem é relevante porque os experimentos da Datology mostram que é possível ampliar o desempenho efetivo de um modelo com muito mais eficiência por meio da curadoria dos dados de treinamento do que pelo aumento indiscriminado da computação no pré-treinamento. Para equipes de engenharia e produto, isso muda o foco e a alocação do orçamento: sai das horas brutas de GPU e vai para a engenharia do ciclo de vida dos dados e as estratégias de ampliação com dados sintéticos.
Em princípio, o núcleo técnico é conhecido, mas sua execução ocorre em outra escala: descontaminação rigorosa e limpeza heurística, pontuação e reponderação por documento, geração sintética fundamentada em exemplos de alta qualidade e um mecanismo configurável de composição que combina subconjuntos para diferentes etapas de treinamento. A Datology afirma ter realizado experimentos nos quais conjuntos de dados curados permitiram que modelos menores, treinados com menos tokens, igualassem ou superassem modelos de referência maiores, treinados com muito mais computação. Para quem atua na área, a implicação imediata é prática: é possível trocar FLOPs de pré-treinamento por fluxos de curadoria mais inteligentes e modelos menores de implantação, com menor custo de inferência.
Levar a curadoria de ponta à escala empresarial exige um trabalho considerável de engenharia. A Datology relata operar pipelines em escala de petabytes, grafos de operadores personalizados e amplo cache de dados intermediários para processar centenas de terabytes a petabytes sem disparar custos nem tempos de execução. Esse trabalho é o que separa a pesquisa de laboratório de um produto que as equipes podem executar dentro da VPC de um cliente. Para empresas que avaliam criar modelos proprietários, esse modelo de produto é importante: elas mantêm o controle dos dados e sua proveniência, evitam enviar propriedade intelectual bruta a serviços externos e ainda aproveitam técnicas avançadas de curadoria.
O argumento de negócio se concentra em dois resultados mensuráveis: desempenho do modelo por unidade de computação no pré-treinamento e custo de inferência por tarefa. Os exemplos da Datology — nos quais um modelo curado de 12B, pré-treinado com menos tokens, superou uma referência de 30B que usou muito mais computação — mostram como a curadoria pode reduzir tanto o tamanho quanto o orçamento de treinamento dos modelos eficazes em produção. Para quem toma decisões, a conclusão é clara: invista cedo em ferramentas e pipelines de dados e planeje experimentos que comparem o desempenho com referências normalizadas pela computação, não apenas pela contagem de tokens.