

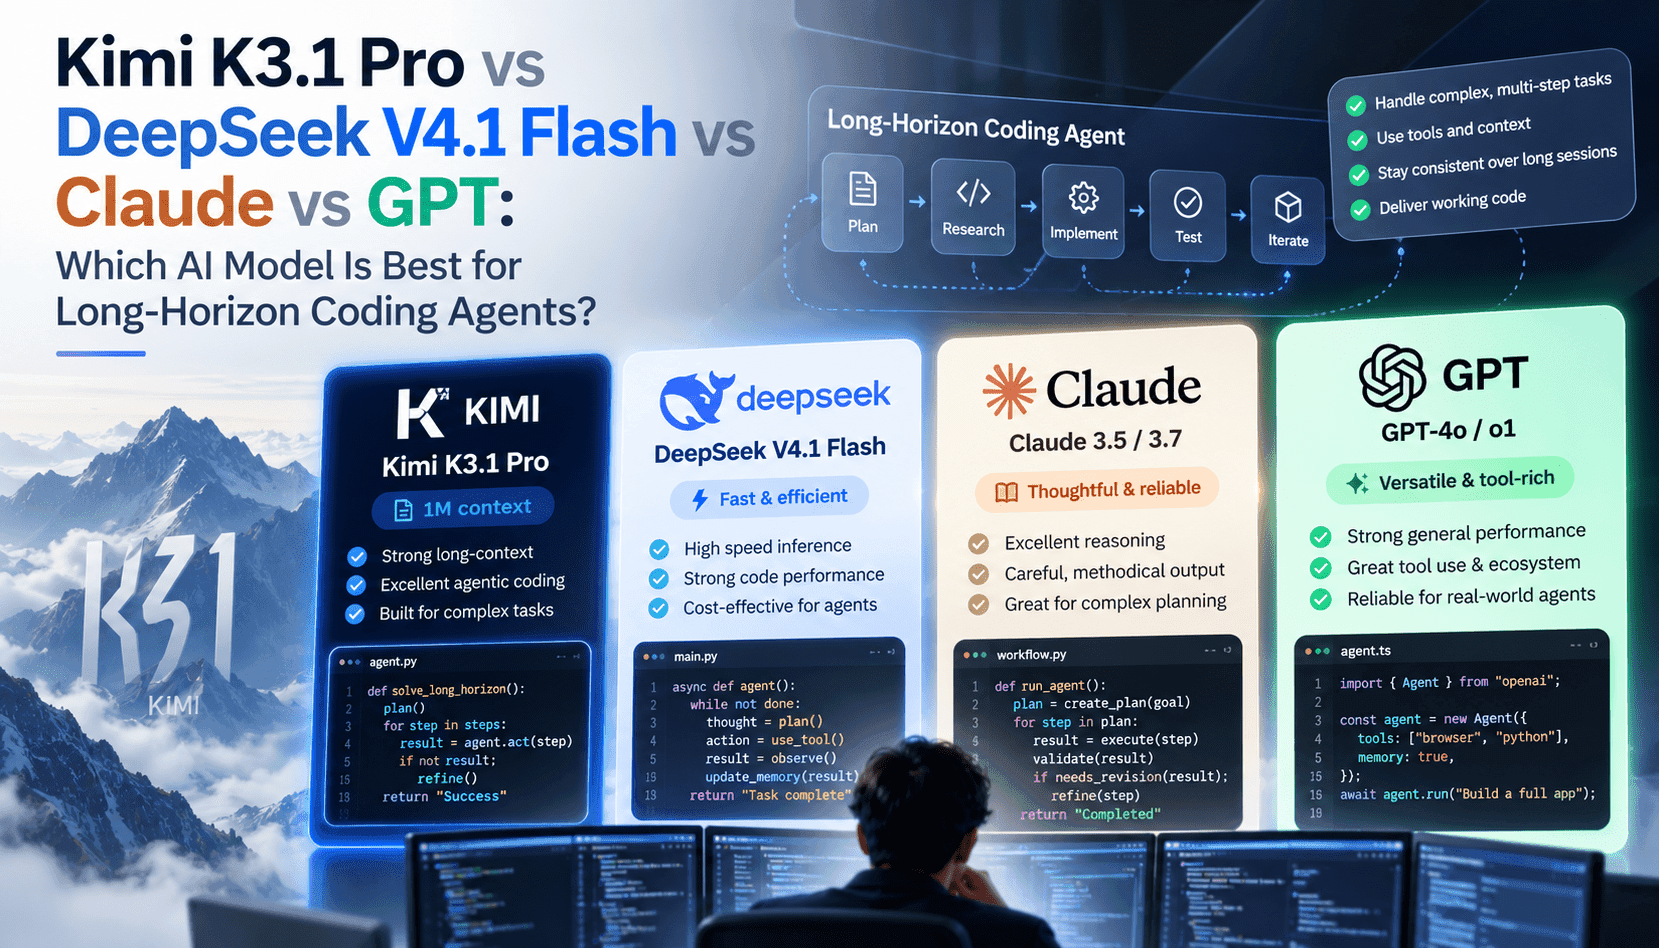
Agentes de programação que trabalham por longos períodos são avaliados por critérios diferentes dos usados para completar código em uma única interação. Eles precisam manter o raciocínio ao longo de muitas chamadas de ferramentas, preservar o estado entre sessões com cache robusto, processar atualizações incrementais com eficiência e oferecer custos previsíveis por tarefa de desenvolvimento. A janela de 1 milhão de tokens e os recursos de modo de raciocínio do Kimi K3.1 Pro foram pensados especificamente para esse fluxo; a variante Flash da DeepSeek prioriza baixa latência e alto desempenho de streaming, o Claude dá ênfase à segurança e ao raciocínio controlável, e os modelos da classe GPT oferecem um ecossistema amplo e, muitas vezes, a melhor cadeia de ferramentas conversacionais da categoria. Para as equipes de engenharia, a questão não é qual modelo é objetivamente “o melhor”, mas qual se adapta ao tamanho do repositório, ao ritmo de CI/CD, ao orçamento e à tolerância a riscos.
As vantagens e desvantagens ficam claras quando relacionamos os recursos dos modelos aos fluxos de trabalho dos agentes. Um contexto de 1 milhão de tokens ajuda quando os agentes precisam raciocinar sobre históricos que abrangem vários módulos, documentos de arquitetura extensos e resultados acumulados de ferramentas — por exemplo, em refatorações com várias PRs ou migrações entre repositórios. Mas esse potencial só se concretiza quando o agente usa compactação seletiva, prompts com geração aumentada por recuperação e estratégias de cache de sessão para não enviar tokens irrelevantes. A inferência mais rápida (K3.1 Pro Highspeed ou DeepSeek Flash) reduz o tempo total e a espera dos desenvolvedores; ainda assim, o custo por token, o tamanho dos lotes e a sobrecarga de E/S determinam se modelos mais rápidos realmente diminuem as despesas operacionais em produção.
Os modelos de pesos abertos mudam a lógica de implantação: as equipes podem executar agentes em hardware privado, controlar a telemetria e evitar a dependência de um único fornecedor, mas também assumem encargos operacionais — latência do serviço, distribuição do contexto longo entre dispositivos e atualização dos filtros de segurança. Os modelos proprietários de ponta ainda economizam tempo: um raciocínio melhor pronto para uso, ecossistemas de ferramentas integrados e proteções gerenciadas reduzem o trabalho de engenharia. A escolha certa depende de a organização priorizar a privacidade dos dados e a baixa latência local ou querer minimizar o esforço de integração e confiar nos SLAs do provedor para atualizações de segurança e melhorias dos modelos.
Além da capacidade bruta, avalie como os modelos se comportam em agentes que usam várias ferramentas: eles oferecem especificações determinísticas para chamadas de ferramentas, modos de raciocínio estruturado, transmissão contínua dos resultados das ferramentas e aprovações com permissões? O modo de raciocínio e os controles de sessão do Kimi buscam reduzir alucinações em fluxos longos; o desempenho do DeepSeek Flash ajuda a evitar tempos limite em ciclos de CI apertados; as heurísticas de segurança do Claude o tornam atraente para empresas com exigências rigorosas de conformidade; e os modelos da classe GPT se beneficiam de conectores de ecossistema abrangentes e estruturas de orquestração de terceiros. Considere o atrito de integração, a capacidade de auditoria e o comportamento de recuperação de cada modelo quando uma ferramenta falha no meio do plano.