

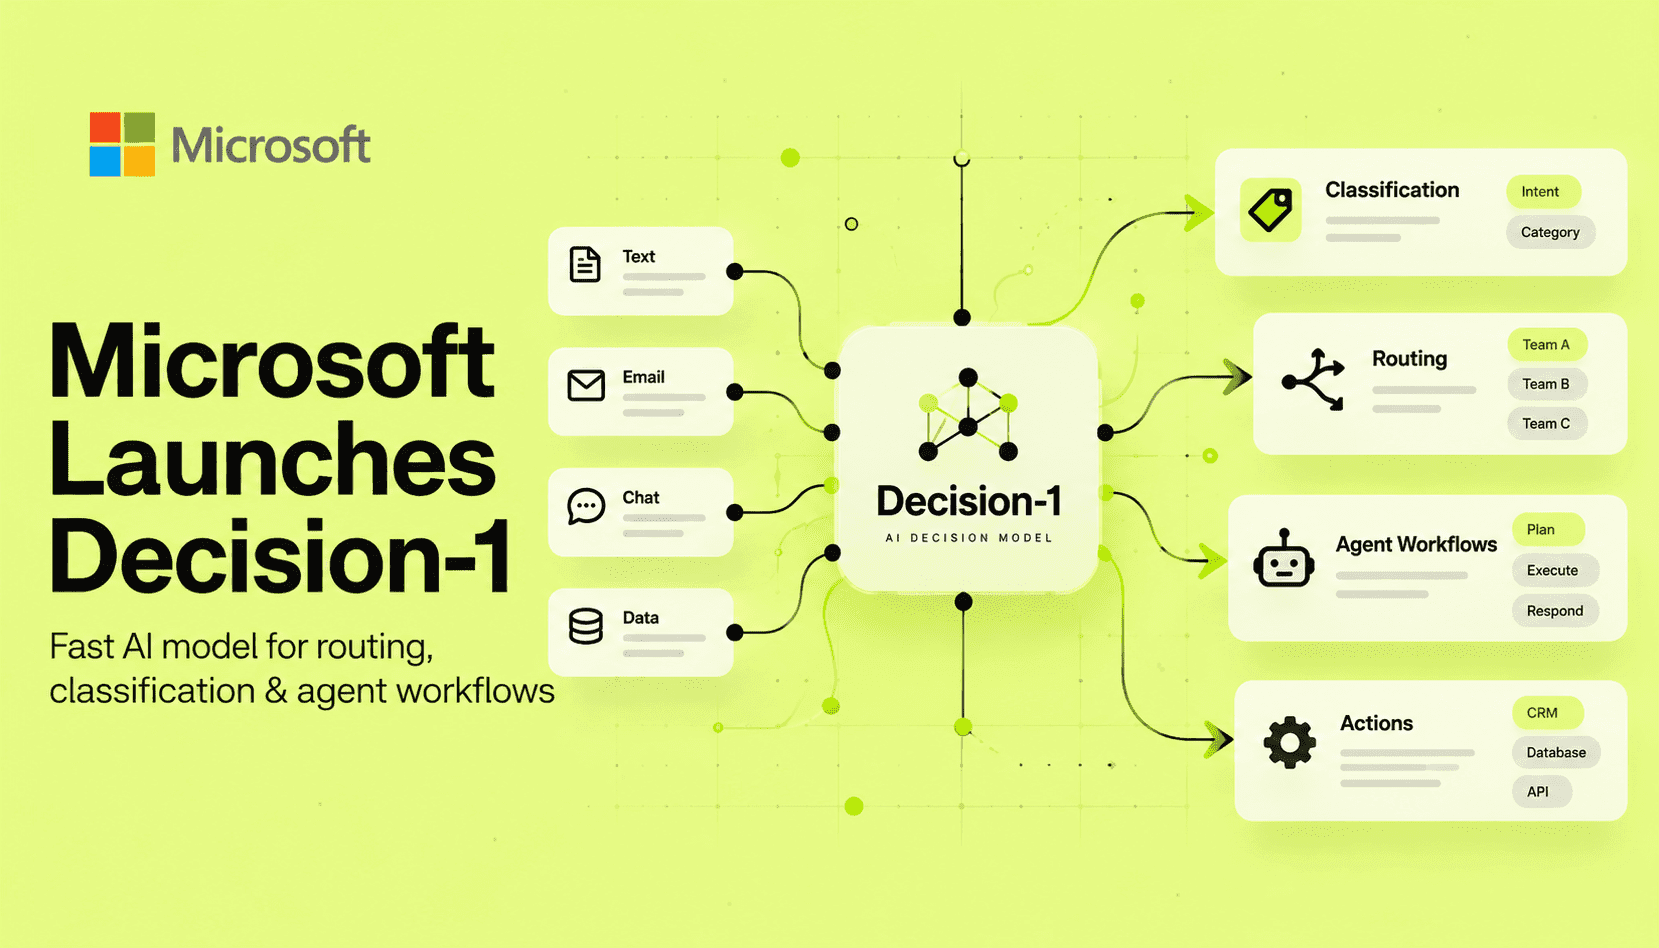
O Microsoft-Decision-1 é um modelo especializado de pontuação, desenvolvido para softwares que precisam tomar decisões — escolher, ordenar, classificar, verificar ou atribuir pontuações — em vez de gerar conteúdo. Ao contrário dos LLMs de uso geral, ajustados para produzir textos fluentes, esse modelo gera resultados estruturados e probabilidades calibradas em uma única passagem direta. Para as equipes de produto, essa diferença é importante: ela transforma cargas de trabalho centradas em decisões, antes dependentes de chamadas caras e lentas a LLMs, em etapas compactas e determinísticas de pontuação, adequadas para agentes em tempo real, webhooks e pipelines de moderação de alto volume.
Do ponto de vista técnico, a Microsoft descreve o modelo como baseado no Qwen3.5‑9B e otimizado para calibração e inferência de baixa latência. O modelo gera probabilidades para opções rotuladas, permitindo que o software use diretamente o vetor de probabilidades para roteamento ou decisões baseadas em limites. Isso evita chamadas de ida e volta a um LLM gerador de texto e elimina a necessidade de processamento adicional ou extração heurística. As pontuações calibradas em uma única passagem também simplificam a telemetria posterior: é possível medir a confiança, ajustar limites e implementar proteções sem recorrer a engenharia de prompts dispendiosa ou a cadeias de verificação com várias etapas.
Os resultados de benchmark anunciados pela Microsoft chamam atenção: o Decision‑1 liderou uma comparação com 36 benchmarks em precisão e, aspecto crucial, foi muito mais rápido do que as alternativas generativas, com uma vantagem de velocidade declarada de 35x sobre um comparador GPT-6 Sol nos testes da empresa. Uma melhoria dessa magnitude é importante quando latência, custo por inferência e volume de processamento impõem limites ao produto. Ainda assim, o contexto do benchmark, o hardware, o processamento em lotes e a compatibilidade dos conjuntos de dados fazem diferença; antes de mudar a arquitetura, as equipes devem reproduzir os principais microbenchmarks em sua infraestrutura de produção.
Na prática, o Decision‑1 fica entre classificadores leves e LLMs robustos: é mais especializado do que um classificador pequeno, pois foi treinado e calibrado para diversas tarefas de decisão, mas custa muito menos e é mais rápido do que usar um LLM generativo completo para interpretar e decidir. Para as equipes de engenharia, isso oferece um plano operacional claro: substitua chamadas a LLMs completos quando o objetivo for selecionar, rotear, pontuar ou verificar; reserve os LLMs generativos para tarefas criativas, resumos ou síntese de textos longos.
Adotar um modelo de decisão em produção exige atenção à calibração, à mudança na distribuição dos dados e à integração com as ferramentas existentes para agentes. As equipes devem monitorar os limites de confiança, prever alternativas que recorram a LLMs generativos quando houver problemas de calibração ou deriva nos dados e estabelecer ciclos de treinamento e avaliação alinhados às classes específicas do negócio e aos objetivos de custo. Quando implementado corretamente, o Decision‑1 pode reduzir a latência e o custo de inferência, além de tornar mais determinísticos os fluxos de trabalho com muitas decisões.