

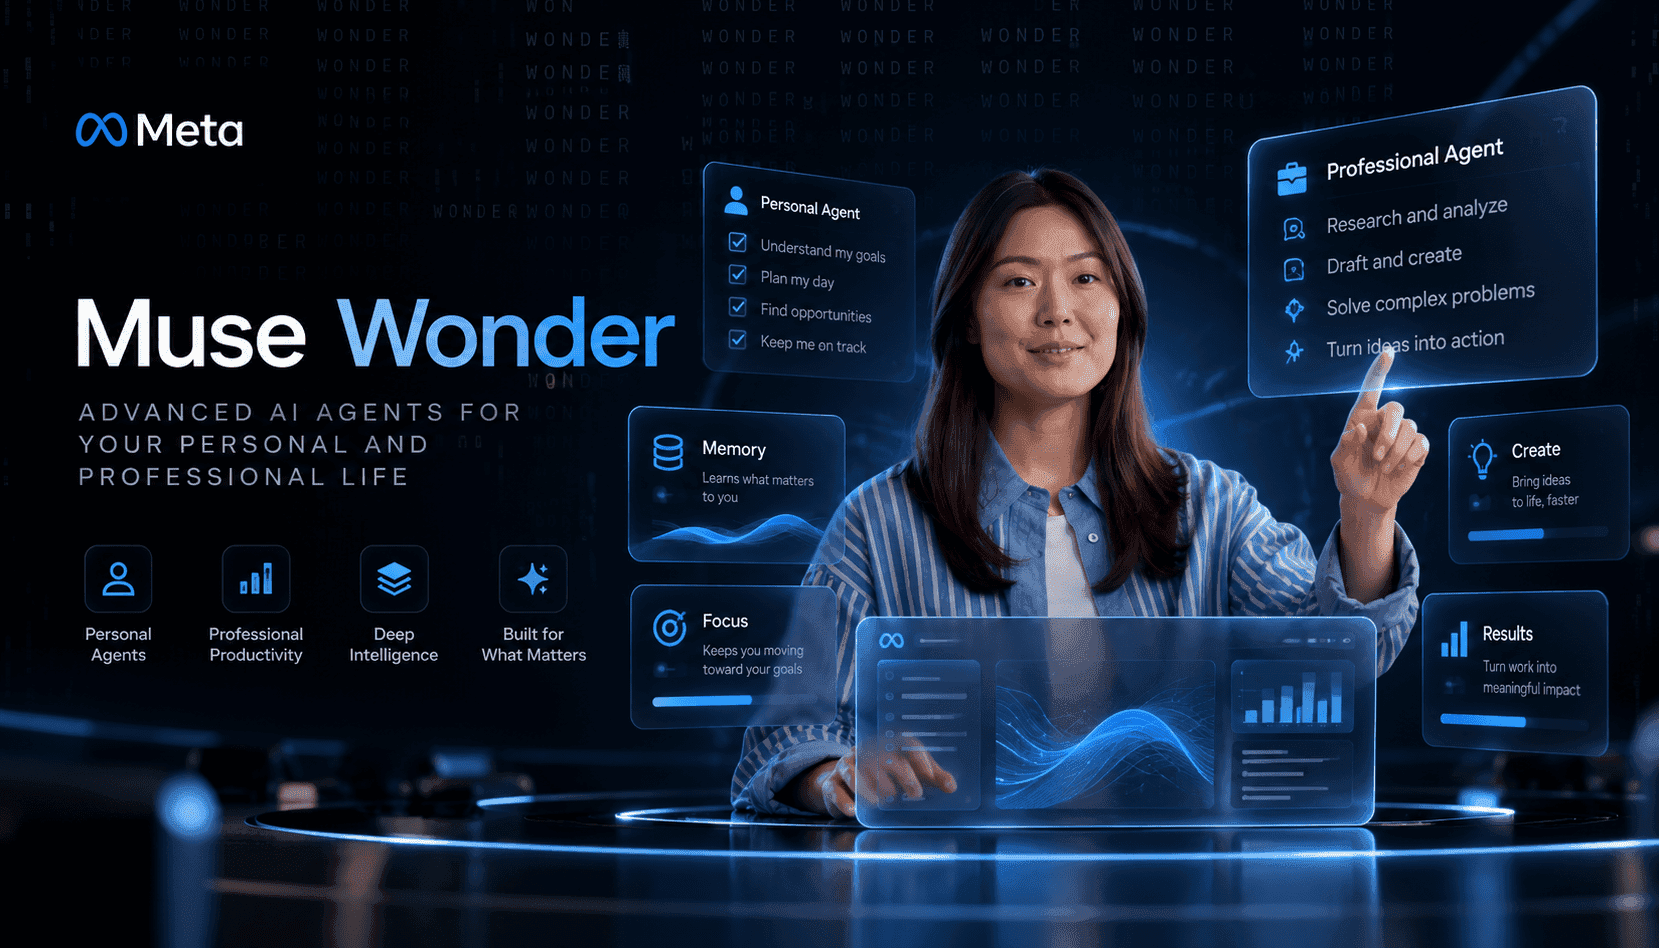
O anúncio da Meta sobre o Muse Wonder e o Muse Wonder Full vai além de uma simples atualização de recursos: representa a transformação clara de fundamentos voltados primeiro a agentes em produtos. A Memória Ativa permite que o modelo retenha fatos relevantes para a tarefa, preferências do usuário e decisões anteriores entre conversas, reduzindo repetições e agilizando fluxos de trabalho com várias etapas. O Foco Ativo complementa a memória ao permitir que o modelo persista na busca por um objetivo — tentando novamente quando uma abordagem falha, sugerindo alternativas e organizando subtarefas até concluir o trabalho, além de pedir esclarecimentos nos momentos decisivos.
Para os desenvolvedores, a Meta apresenta o Muse Wonder como disponível desde já pela Meta Model API e pelo Muse Code, enquanto o Muse Wonder Full chega aos assinantes do Muse Code. Essa distinção importa: o Muse Wonder oferece acesso amplo para integrar raciocínio de nível mais avançado a aplicativos, enquanto o Wonder Full parece voltado a fluxos mais exigentes, possivelmente mais caros, que requerem máxima precisão em áreas como direito, finanças e saúde. Em muitos casos, quem desenvolve precisará repensar o gerenciamento de estado e optar pelos recursos nativos de Memória Ativa, em vez de recorrer a repositórios externos de contexto improvisados.
Do ponto de vista estratégico, o Muse Wonder muda a posição competitiva da Meta. Ao incorporar memória e foco como recursos nativos, e não como integrações, ele reduz a distância em relação ao GPT-6, da OpenAI, ao Claude, da Anthropic, e ao Gemini, do Google, em tarefas de agentes de longo prazo. Isso levanta questões imediatas sobre a comparabilidade de benchmarks, preços e dependência do ecossistema: equipes que escolhem a Meta ganham ferramentas integradas para agentes, mas precisam avaliar como a retenção de memória, as permissões e a portabilidade se encaixam nas exigências de conformidade empresarial e nas estratégias multinuvem.