

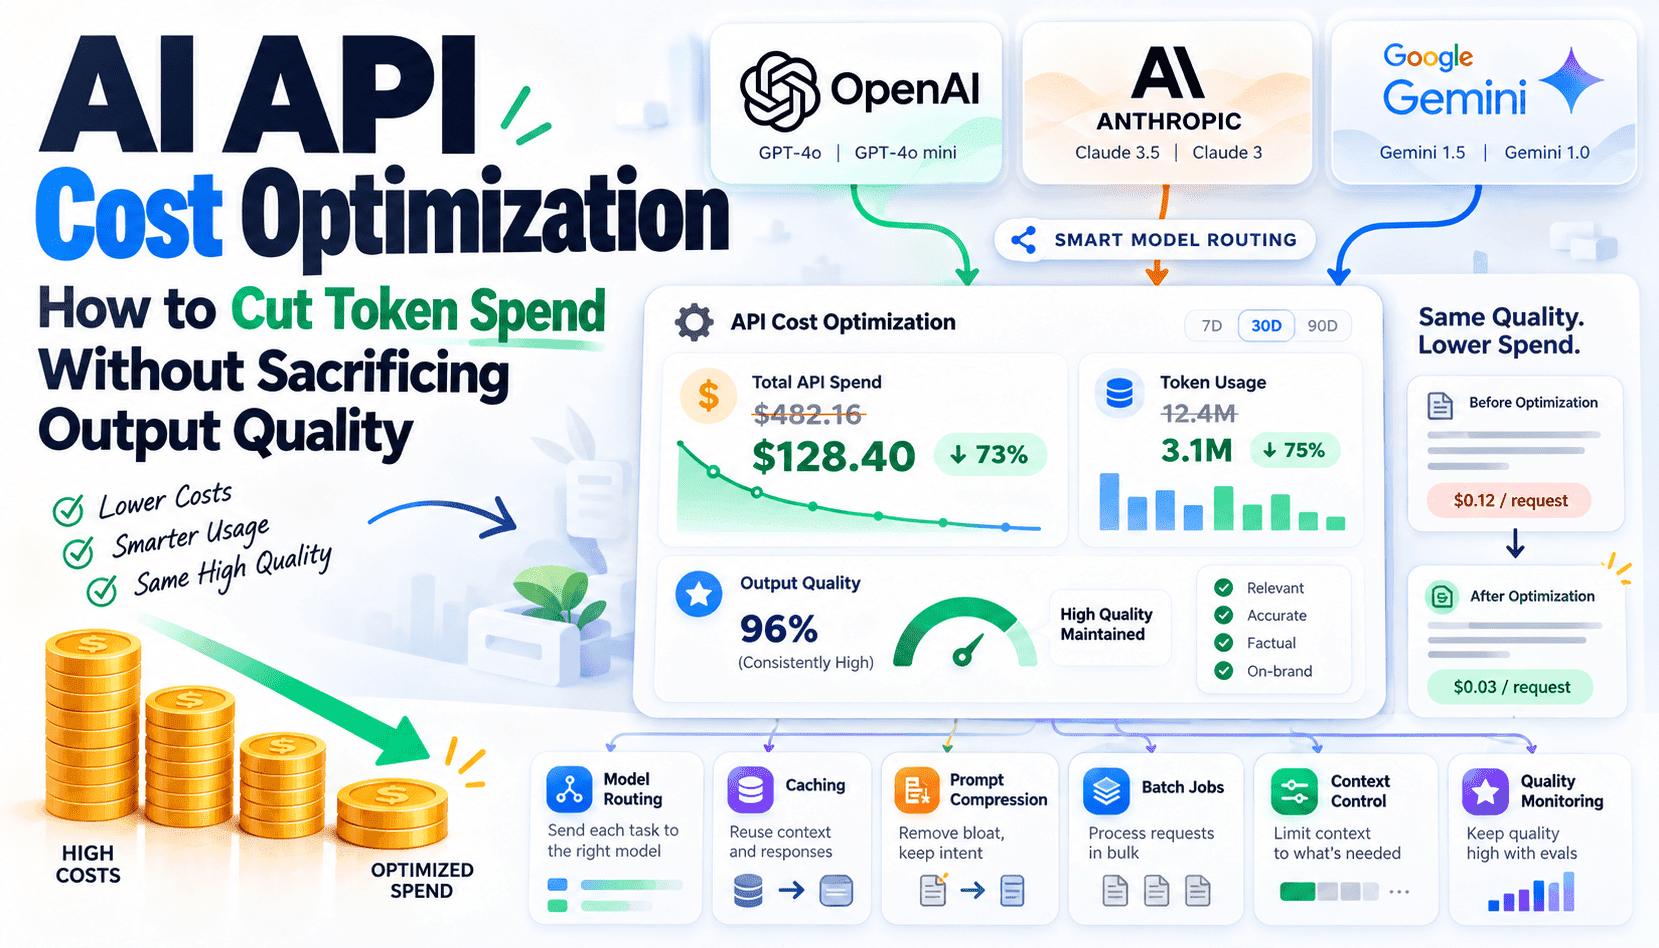
Sự phát triển của AI tạo sinh đã khiến chi phí token trở thành một khoản đáng kể trong ngân sách. Nếu không được kiểm soát, chi tiêu token sẽ tăng theo lượng người dùng, độ dài ngữ cảnh và đầu ra không giới hạn. Tối ưu chi phí không có nghĩa là lúc nào cũng chọn mô hình rẻ nhất; điều quan trọng là ghép năng lực mô hình với độ phức tạp của tác vụ, loại bỏ token dư thừa ở cả đầu vào lẫn đầu ra, đồng thời điều chỉnh quy trình để chỉ dùng suy luận tốn kém khi nó thực sự cải thiện kết quả kinh doanh. Bài viết này trình bày những biện pháp vận hành mà các nhóm có thể áp dụng và các chỉ số cần theo dõi để đánh giá sự đánh đổi.
Hãy bắt đầu bằng cách lập bản đồ năng lực và định tuyến: phân loại yêu cầu theo độ phức tạp và mức độ nhạy cảm về chất lượng, sau đó chuyển các tác vụ đơn giản sang mô hình nhỏ, ít tốn kém hơn hoặc các mô-đun xác định. Chẳng hạn, chỉnh sửa nội dung ngắn, dịch theo định dạng nghiêm ngặt hoặc trích xuất ý định đơn giản thường có thể xử lý bằng mô hình đã chưng cất hoặc các quy tắc heuristic; còn sáng tạo nội dung dài và suy luận nhiều bước tinh tế nên được chuyển cho mô hình mạnh hơn. Hãy đo lường tỷ lệ thành công và tỷ lệ chuyển tiếp của từng tuyến để phát hiện khi nào phương án rẻ hơn không hiệu quả và chỉ nâng cấp khi cần.
Có ba cách thực tiễn để kiểm soát chi phí thông qua thiết kế prompt: rút gọn chỉ dẫn mà không làm mất ý nghĩa, tận dụng tối đa ngữ cảnh hệ thống dùng chung và cắt giảm ngữ cảnh động. Dùng mẫu súc tích, ví dụ few-shot được đánh số và lược đồ hàm có cấu trúc để giảm độ dài. Lưu ngữ cảnh hệ thống ổn định trên máy chủ và chỉ bổ sung những thành phần động mới. Với lịch sử hội thoại dài, hãy tóm tắt thay vì gửi lại nguyên văn; với tác vụ có nhiều tài liệu, hãy truy xuất và xếp hạng các đoạn liên quan nhất thay vì đưa cả tài liệu vào prompt.
Ngoài prompt, hãy tích hợp bộ nhớ đệm, xử lý hàng loạt và các cơ chế kiểm soát quy trình vào hệ thống. Bộ nhớ đệm kết hợp ngữ nghĩa và khớp chính xác giúp tránh chạy lại các suy luận tốn kém giống nhau. Xử lý các tác vụ ưu tiên thấp theo lô vào giờ thấp điểm hoặc trên các cụm điện toán rẻ hơn. Khi có thể, hãy giới hạn đầu ra, dùng token dừng và gọi hàm theo cách xác định để mô hình không tạo văn bản không giới hạn. Cuối cùng, áp dụng một khung kiểm soát chi phí thống nhất, theo dõi đồng thời token đầu vào, token đầu ra, tỷ lệ truy cập bộ nhớ đệm, độ trễ và các chỉ số chất lượng—để quyết định cân bằng được chi phí với thành công của sản phẩm.