

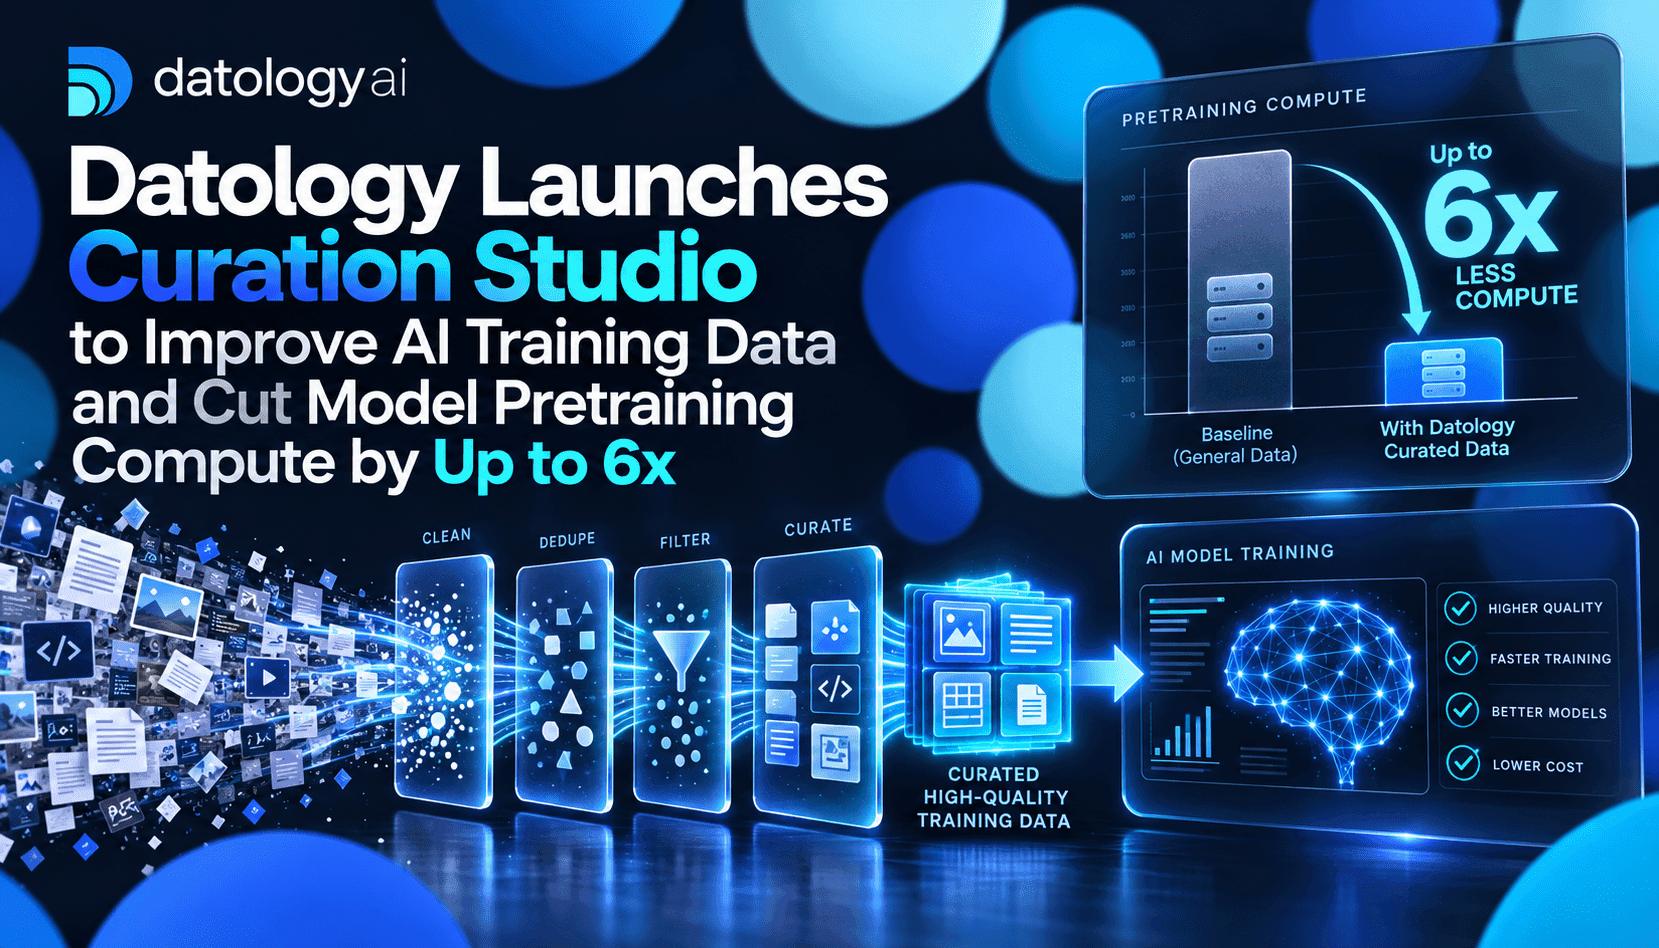
Curation Studio mới của Datology được định vị là một lớp vận hành nằm giữa nội dung thô và quá trình huấn luyện mô hình. Thay vì chỉ tiếp nhận lượng token ngày càng lớn, sản phẩm áp dụng quy trình bốn giai đoạn — làm sạch, hiệu chỉnh, tạo dữ liệu và phối trộn — để tìm ra những tín hiệu giá trị nhất cho các tác vụ bạn quan tâm. Cách tiếp cận này đáng chú ý vì các thử nghiệm của Datology cho thấy hiệu năng thực tế của mô hình có thể được cải thiện hiệu quả hơn nhiều bằng cách tuyển chọn dữ liệu huấn luyện thay vì tăng tài nguyên tính toán tiền huấn luyện một cách thiếu chọn lọc. Với các nhóm kỹ thuật và sản phẩm, điều đó đồng nghĩa cần chuyển hướng sự quan tâm và ngân sách: từ số giờ chạy GPU sang kỹ thuật hóa vòng đời dữ liệu và chiến lược tăng cường dữ liệu tổng hợp.
Về nguyên tắc, các thành phần kỹ thuật cốt lõi không mới, nhưng được triển khai ở quy mô lớn: khử nhiễm nghiêm ngặt và làm sạch bằng heuristic, chấm điểm và điều chỉnh trọng số theo từng tài liệu, tạo dữ liệu tổng hợp dựa trên các ví dụ nguồn chất lượng cao, cùng một công cụ phối trộn có thể cấu hình để kết hợp các tập con cho từng giai đoạn huấn luyện. Datology cho biết các thử nghiệm của họ cho thấy bộ dữ liệu được tuyển chọn giúp những mô hình nhỏ hơn, huấn luyện trên ít token hơn, đạt kết quả ngang bằng hoặc vượt các mô hình nền lớn hơn vốn sử dụng nhiều tài nguyên tính toán hơn đáng kể. Với người triển khai, ý nghĩa trước mắt rất thiết thực: có thể giảm FLOPs tiền huấn luyện bằng quy trình tuyển chọn thông minh hơn, đồng thời dùng các mô hình phục vụ nhỏ hơn, ít tốn kém hơn khi suy luận.
Đưa hoạt động tuyển chọn dữ liệu ở cấp độ tiên phong vào vận hành trên quy mô doanh nghiệp đòi hỏi nhiều công sức kỹ thuật. Datology cho biết họ vận hành các pipeline ở quy mô petabyte, đồ thị toán tử tùy chỉnh và hệ thống lưu đệm trung gian rộng khắp để xử lý hàng trăm terabyte đến petabyte dữ liệu mà không khiến chi phí hoặc thời gian chạy tăng vọt. Chính những công việc này tạo nên khác biệt giữa nghiên cứu trong phòng thí nghiệm và một sản phẩm mà các nhóm có thể chạy ngay trong VPC của khách hàng. Với các công ty đang cân nhắc tự xây dựng mô hình độc quyền, mô hình sản phẩm này rất đáng lưu ý: doanh nghiệp vẫn kiểm soát dữ liệu, duy trì nguồn gốc dữ liệu và tránh gửi tài sản trí tuệ thô đến dịch vụ bên ngoài, đồng thời vẫn hưởng lợi từ các kỹ thuật tuyển chọn tiên tiến.
Giá trị kinh doanh tập trung vào hai kết quả có thể đo lường: hiệu năng mô hình trên mỗi đơn vị tài nguyên tính toán tiền huấn luyện và chi phí suy luận trên mỗi tác vụ. Các ví dụ của Datology — trong đó mô hình 12B được tuyển chọn và tiền huấn luyện trên ít token hơn đã vượt mô hình nền 30B sử dụng nhiều tài nguyên tính toán hơn đáng kể — cho thấy tuyển chọn dữ liệu có thể giảm cả quy mô lẫn ngân sách huấn luyện của các mô hình hiệu quả khi đưa vào sản xuất. Với người ra quyết định, bài học rất rõ ràng: hãy đầu tư sớm vào công cụ và pipeline dữ liệu, đồng thời thiết kế thử nghiệm để đo hiệu năng so với các mô hình nền đã chuẩn hóa theo tài nguyên tính toán, thay vì chỉ xét số lượng token.