

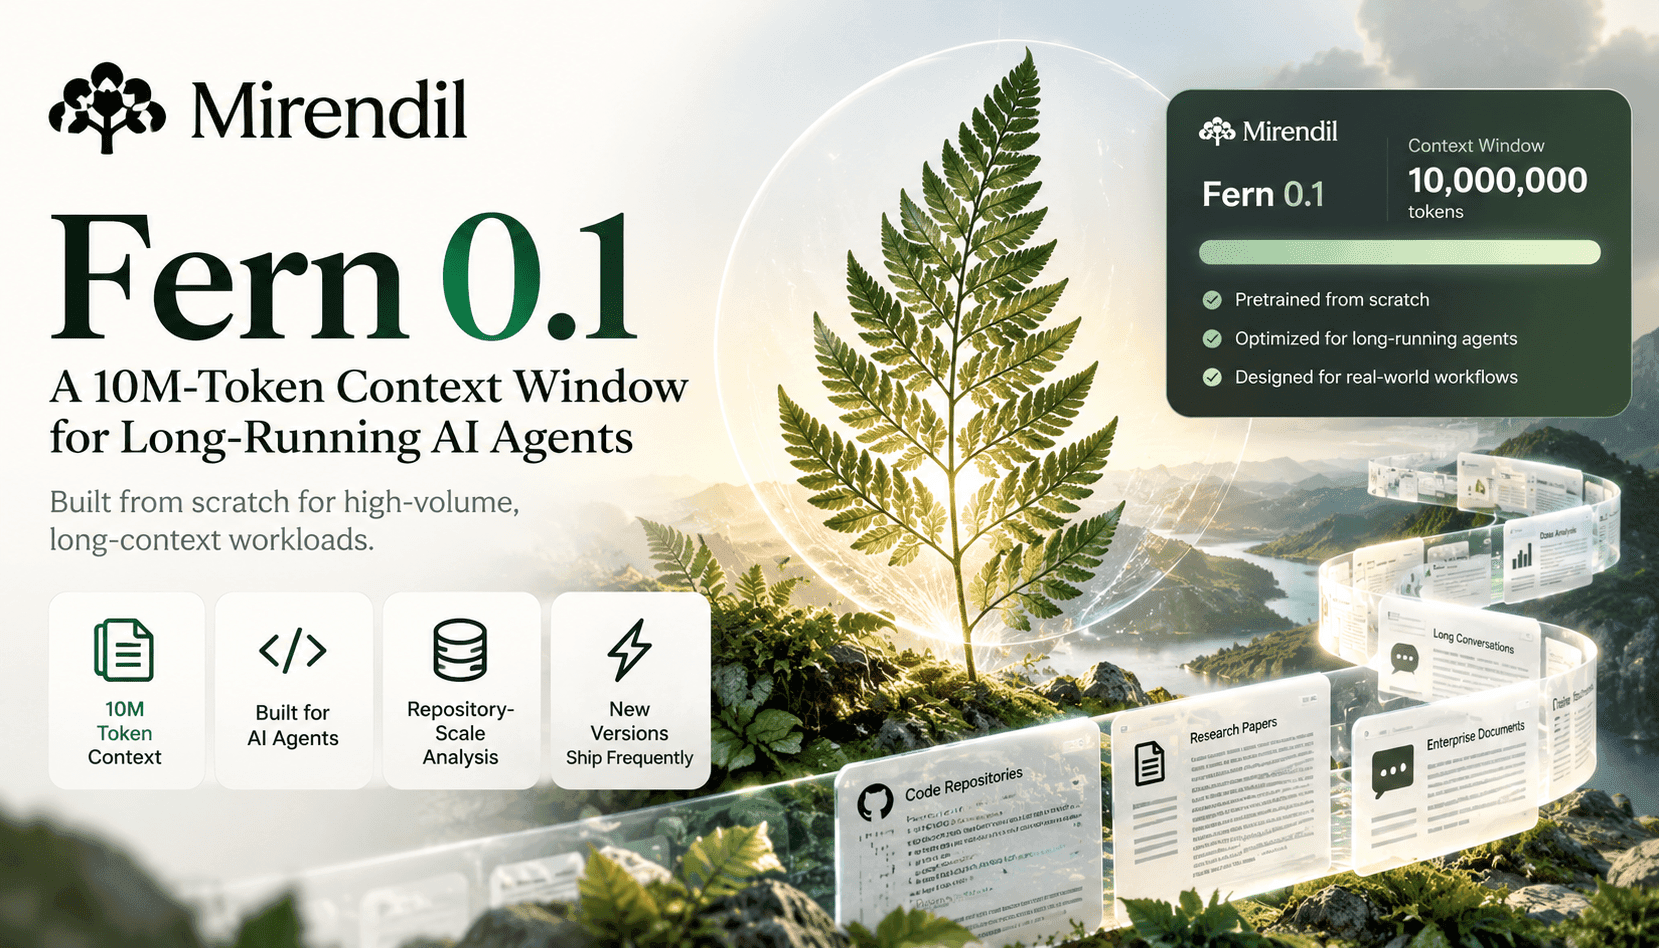
Fern 0.1 là mô hình nền tảng đầu tiên của Mirendil, được huấn luyện và triển khai trên kiến trúc hỗ trợ ngữ cảnh lên đến 10 triệu token. Trên lý thuyết, đây là một bước đột phá: hàng chục megabyte mã nguồn hoặc lịch sử tương tác nhiều ngày của một tác tử AI có thể được giữ trong ngữ cảnh làm việc, thay vì phải chuyển sang kho lưu trữ bên ngoài. Với các nhóm xây dựng tác tử tự hành hoạt động dài hạn, lợi ích trước mắt rất rõ ràng — giảm số lượt gọi đến hệ thống truy xuất bên ngoài, có thể suy luận trên toàn bộ kho mã hoặc phân đoạn dữ liệu huấn luyện cùng lúc, và đơn giản hóa cách nhà phát triển hình dung hệ thống khi dấu vết và nhật ký vẫn có thể được mô hình truy cập trực tiếp.
Tuy nhiên, cửa sổ ngữ cảnh lớn là yếu tố mở ra khả năng mới, chứ không đảm bảo kết quả tốt hơn. Để khai thác hiệu quả 10 triệu token, cần có kiến trúc mô hình, chiến lược attention và phương pháp truy xuất giúp đưa đúng ngữ cảnh lên hàng đầu; đồng thời, hạ tầng triển khai và mô hình chi phí phải khiến việc sử dụng ngữ cảnh khổng lồ trở nên khả thi. Các số liệu ban đầu của Mirendil tập trung vào cải thiện khả năng dự đoán token tiếp theo và những bài kiểm tra cơ bản về ngữ cảnh dài — một khởi đầu đáng khích lệ. Dù vậy, các nhóm đưa mô hình vào thực tế cần quan tâm đến những câu hỏi then chốt: mô hình nhớ lại và suy luận tốt đến đâu khi ngữ cảnh ở xa, độ trễ và chi phí tăng như thế nào, và ngữ cảnh dài hơn có thực sự giảm tỷ lệ lỗi trong các tác vụ thực tế như gỡ lỗi nhiều tệp hay kiểm toán dữ liệu huấn luyện hay không.
Với doanh nghiệp, sự đánh đổi rất cụ thể: nên trả tiền cho một phiên bản mô hình ngữ cảnh cực dài duy nhất có thể giữ toàn bộ kho mã và dấu vết trong bộ nhớ, hay xây dựng kiến trúc kết hợp giữa mô hình lõi nhỏ hơn với RAG, các lớp bộ nhớ có lập chỉ mục và quy trình xác minh? Fern mở rộng phạm vi những gì có thể thực hiện mà không cần truy xuất trung gian, nhưng trước khi chọn chiến lược ngữ cảnh cực dài, các nhóm vẫn cần cân nhắc độ tin cậy, khả năng quan sát và những lỗi suy luận ở các trường hợp đặc biệt.