

NexusAi logo

NexusAi

  • Sản phẩm
  • Danh mục
  • Prompts
  • Tìm kiếm
  • Tin AI
  • Giá cả
  • Quảng bá
  • Liên hệ
Đăng nhập
NexusAi LogoNexusAi

NexusAI giúp bạn khám phá, so sánh và tìm hiểu các công cụ AI một cách dễ dàng. Từ những hiểu biết chuyên sâu của chuyên gia đến các tài nguyên đào tạo, chúng tôi trao quyền cho các cá nhân và doanh nghiệp khai thác công nghệ AI để đưa ra quyết định thông minh hơn, đổi mới và phát triển.

Liên kết hữu ích

  • Về chúng tôi
  • Sản phẩm AI
  • Danh mục AI
  • Câu lệnh AI
  • Tìm kiếm AI
  • Góc nhìn AI

Dịch vụ & Pháp lý

  • Quảng bá & Trưng bày
  • Gói thành viên
  • Điều khoản & Điều kiện
  • Chính sách hoàn tiền
  • Chính sách bảo mật
  • Tuyên bố miễn trừ

Liên hệ với chúng tôi

88 Tribune Street
South Brisbane, QLD, Australia, 4101
Trang web: www.nexusai-tech.com
Email: info@nexusai-tech.com

© Bản quyền 2026 NexusAi Bảo lưu mọi quyền

Phát triển bởi DStudio Technology
Trang chủ/Góc nhìn AI/Hướng dẫn Quy trình Làm việc với AI/Ontology trong AI: Cách các tác nhân doanh nghiệp dùng tri thức có cấu trúc để suy luận, truy xuất và hành động đáng tin cậy
Hướng dẫn Quy trình Làm việc với AIHướng dẫn về ontology cho tác nhân AI

Ontology trong AI: Cách các tác nhân doanh nghiệp dùng tri thức có cấu trúc để suy luận, truy xuất và hành động đáng tin cậy

Hướng dẫn thực tiễn về lý do ontology quan trọng đối với tác nhân doanh nghiệp, hệ thống RAG và hoạt động tìm kiếm có quản trị. Tìm hiểu cách các khái niệm, thuộc tính, mối quan hệ và tiên đề giúp hệ thống AI hiểu đúng ý nghĩa có thẩm quyền, truy xuất nguồn gốc và thực thi quyền truy cập ngay khi vận hành; đồng thời khám phá khung triển khai tinh gọn với 20–50 khái niệm, kèm lời khuyên về đo lường và quản trị.

NexusAI Research Desk22 thg 10, 20262.9K lượt xem12 phút đọc
Ontology trong AI: Cách các tác nhân doanh nghiệp dùng tri thức có cấu trúc để suy luận, truy xuất và hành động đáng tin cậy
Tóm tắt AI

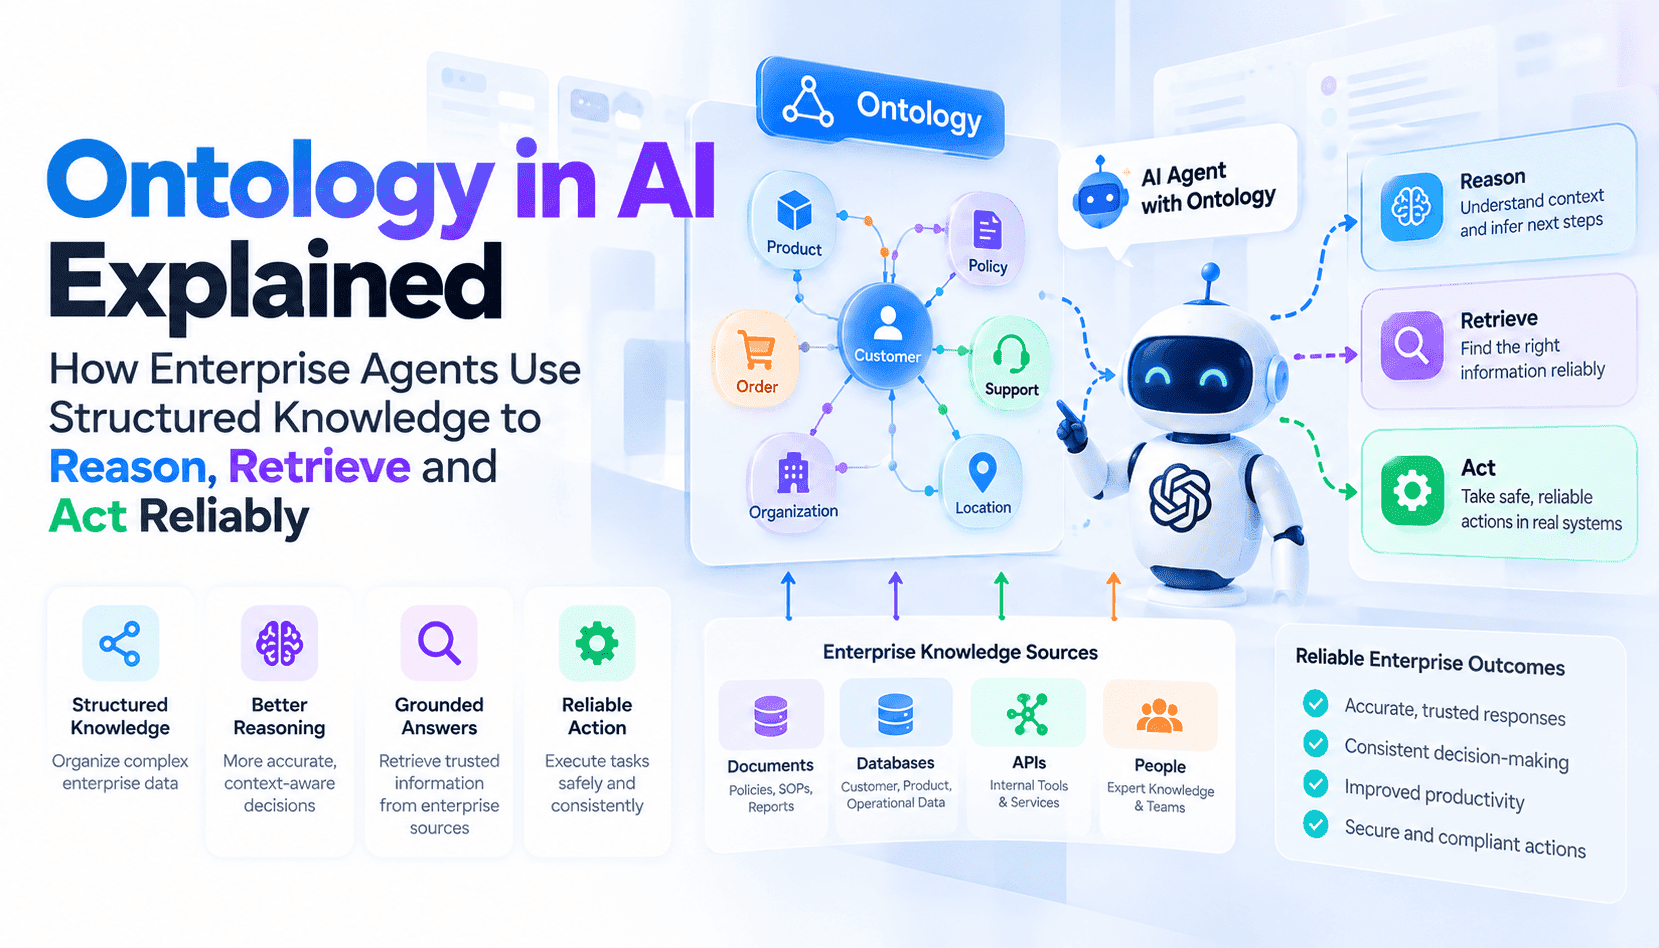
Tác nhân doanh nghiệp và các hệ thống tăng cường truy xuất có thể tiếp cận dữ liệu nhanh chóng nhưng thường không diễn giải dữ liệu một cách nhất quán. Bài viết giải thích cách ontology — gồm các lớp, thuộc tính, mối quan hệ và tiên đề — tạo ra ý nghĩa mà máy có thể đọc, để hệ thống RAG và tác nhân dùng vào việc phân biệt các thuật ngữ, chọn định nghĩa có thẩm quyền, truy xuất các khẳng định về nguồn đã được chứng nhận, cũng như thực thi quyền truy cập và quy tắc chính sách khi vận hành. Bài viết so sánh ontology với hệ phân loại, đồ thị tri thức, lớp ngữ nghĩa và mô hình dữ liệu; tóm lược các tiêu chuẩn chính (RDF, OWL, SPARQL, SHACL); và kết thúc bằng khung triển khai thực tiễn: chọn trường hợp sử dụng, mô hình hóa 20–50 khái niệm cốt lõi, ánh xạ dòng dữ liệu và siêu dữ liệu quản trị, rồi đo lường độ chính xác suy luận và khả năng truy xuất nguồn gốc.

AI doanh nghiệp phần lớn đã giải quyết được bài toán kết nối và luân chuyển dữ liệu: các trình kết nối, kho dữ liệu và phương thức truy xuất đều đã phát triển hoàn thiện. Thách thức khó hơn hiện nay là đảm bảo ý nghĩa nhất quán trên quy mô lớn. Một tác nhân có thể truy vấn mọi bảng nhưng vẫn hiểu sai một trường như customer_status hoặc revenue. Ontology giải quyết vấn đề này bằng cách mã hóa các khái niệm kinh doanh, thuộc tính, mối quan hệ và tiên đề, giúp hệ thống AI suy luận về ý nghĩa của dữ liệu thay vì xem dữ liệu như các token không nhãn hoặc thành phần lược đồ. Sự thay đổi này rất quan trọng đối với các quyết định ở bước sau — từ thẩm định bảo hiểm tự động đến báo cáo cho lãnh đạo — vì sai sót sẽ tích lũy khi được tạo ra và lặp lại theo chương trình.

Bài viết tiếp cận vấn đề theo hướng thực tiễn, bắt đầu từ các trường hợp sử dụng. Chúng tôi giải thích những thành phần nào giúp ontology trở nên hữu ích với tác nhân, chỉ ra điểm khác biệt giữa ontology với hệ phân loại, đồ thị tri thức và lớp ngữ nghĩa, đồng thời đưa ra các ví dụ cụ thể — hồ sơ rủi ro khách hàng, chỉ số doanh thu, hồ sơ yêu cầu bồi thường bảo hiểm — để làm rõ những tín hiệu về quản trị, dòng dữ liệu và quyền truy cập mà tác nhân cần khi vận hành. Mục tiêu là đưa vào ứng dụng: thiết kế ontology sẵn sàng cho AI, có khả năng truy xuất nguồn gốc, cung cấp định nghĩa có thẩm quyền và các cơ chế thực thi, để tác nhân chọn đúng dữ liệu và hành động, còn con người có thể tự tin kiểm tra các quyết định.

Ontology mở ra khả năng suy luận. Trong khi danh mục dữ liệu hoặc hệ phân loại chỉ sắp xếp tài sản, các tiên đề cho phép tác nhân suy ra những thông tin không được lưu trữ tường minh: tập dữ liệu có chứa thông tin nhận dạng cá nhân (PII) sẽ kế thừa quyền truy cập hạn chế; hai bản ghi có cùng mã số thuế hàm ý thuộc về cùng một pháp nhân; hoặc việc thuê bao hết hạn không đồng nghĩa với chấm dứt nghĩa vụ của khách hàng. Những suy luận này giúp giảm các danh sách quy tắc cứng nhắc và tăng độ tin cậy cho quyết định khi vận hành. Tuy nhiên, chúng đòi hỏi mô hình hóa có chủ đích: các lớp, cá thể, thuộc tính, mối quan hệ có hướng và ràng buộc hình thức được ánh xạ tới dữ liệu vật lý, chủ sở hữu và chính sách.

Cuối cùng, chúng tôi đưa ra khung triển khai tinh gọn có thể áp dụng trong 4–8 tuần đầu tiên. Hãy bắt đầu với một quyết định hoặc quy trình làm việc của tác nhân, mô hình hóa 20–50 khái niệm có tác động lớn, xác định các mối quan hệ và tiên đề cần thiết cho suy luận, rồi liên kết ngay các khái niệm với dòng dữ liệu, điểm chất lượng và quy tắc truy cập. Đo lường thành công bằng độ chính xác suy luận, khả năng truy xuất nguồn gốc và mức độ nhận biết quyền truy cập — thay vì chỉ dựa vào mức độ ứng dụng. Nhờ vậy, ontology trở thành một tài sản quản trị luôn được cập nhật, phát triển cùng việc sử dụng AI thay vì mai một trong một kho tài liệu biệt lập.

Điểm mấu chốt

Bắt đầu với một trường hợp sử dụng và 20–50 khái niệm

Mô hình hóa những khái niệm cần thiết cho một quy trình làm việc của tác nhân, liên kết từng khái niệm với tập dữ liệu, chủ sở hữu và chính sách, thay vì cố mô hình hóa toàn bộ doanh nghiệp ngay từ đầu.

Đặt tiên đề và quản trị làm trọng tâm

Các ràng buộc và siêu dữ liệu về quyền sở hữu hỗ trợ suy luận, truy xuất nguồn gốc và kiểm soát quyền truy cập khi vận hành; thiếu chúng, ontology chỉ là tài liệu.

Đo lường khả năng suy luận, truy xuất nguồn gốc và kiểm soát truy cập

Đánh giá ontology dựa trên khả năng tác nhân suy luận chính xác, truy xuất câu trả lời về các nguồn đã được chứng nhận và thực thi chính sách truy cập khi vận hành.

Ontology thực chất là gì (và vì sao tiên đề quan trọng)

Ontology không chỉ là bảng thuật ngữ hay hệ phân loại: nó định nghĩa các lớp (khái niệm), cá thể (thực thể cụ thể), thuộc tính, mối quan hệ và tiên đề (quy tắc cùng ràng buộc). Tiên đề chính là yếu tố tạo nên khác biệt: chúng cho phép hệ thống suy ra kết luận mà không một trường dữ liệu đơn lẻ nào thể hiện được. Ví dụ, một tiên đề có thể quy định rằng “mỗi hồ sơ yêu cầu bồi thường phải tham chiếu chính xác một hợp đồng bảo hiểm” hoặc “các tập dữ liệu được đánh dấu là có chứa PII sẽ kế thừa quyền truy cập hạn chế”. Bằng cách hình thức hóa những ràng buộc này, tác nhân có thể đưa ra kết luận an toàn và tránh lối logic chắp vá, cứng nhắc vốn dễ thất bại khi cấu trúc dữ liệu thay đổi.

Ontology khác gì hệ phân loại, đồ thị tri thức và mô hình dữ liệu?

Mỗi lớp giải quyết một vấn đề khác nhau: hệ phân loại dùng để phân nhóm, lớp ngữ nghĩa chuẩn hóa các chỉ số, mô hình dữ liệu tối ưu hóa lưu trữ, còn đồ thị tri thức lưu trữ các mối quan hệ ở cấp độ cá thể. Ontology là lược đồ về ý nghĩa: nó cho biết các cạnh trong đồ thị hoặc nút trong hệ phân loại thực sự biểu thị điều gì. Đồ thị tri thức không có ontology vẫn có thể liên kết các thực thể, nhưng không thể suy luận hoặc giải thích một cách đáng tin cậy vì sao kết quả là nguồn có thẩm quyền. Với tác nhân doanh nghiệp, điều cốt yếu là kết nối ngữ nghĩa của ontology với siêu dữ liệu quản trị — quyền sở hữu, dòng dữ liệu, chất lượng và chính sách — để việc suy luận vừa chính xác vừa có thể quy trách nhiệm.

Cách tác nhân sử dụng ontology khi vận hành

Khi vận hành, tác nhân dựa vào ba cơ chế được ontology dẫn dắt: định vị ngữ cảnh, phân giải nhập nhằng và xác định giới hạn hành động. Định vị ngữ cảnh ánh xạ yêu cầu tới các khái niệm kinh doanh đã được định nghĩa trước khi truy xuất; phân giải nhập nhằng làm rõ các thuật ngữ đa nghĩa dựa trên ngữ cảnh về lĩnh vực, vai trò và chính sách; giới hạn hành động gắn ý nghĩa với quyền hạn và quy trình phê duyệt để các thao tác rủi ro cao có thể được chuyển cấp. Trên thực tế, khi được yêu cầu “hiển thị khách hàng có rủi ro cao”, tác nhân sẽ xác định định nghĩa rủi ro nào cần áp dụng, truy xuất các nguồn đã được chứng nhận và thực thi kiểm soát truy cập trên những trường PII, thay vì trả về một danh sách chưa được kiểm chứng bằng cách so khớp từ khóa.

Tiêu chuẩn và công cụ: RDF, OWL, SPARQL và SHACL

Hãy sử dụng các tiêu chuẩn mở để ý nghĩa có thể chuyển đổi giữa các hệ thống. RDF biểu diễn các bộ ba (chủ thể–vị từ–đối tượng), OWL thể hiện lớp, thuộc tính và ràng buộc logic phục vụ suy luận, SPARQL truy vấn đồ thị, còn SHACL xác thực dữ liệu RDF theo các cấu trúc quy định. Kết hợp lại, chúng tạo thành một nền tảng thực tiễn: mô hình hóa bằng OWL, lưu trữ các cá thể dưới dạng RDF trong cơ sở dữ liệu đồ thị, xác thực bằng SHACL và chạy truy vấn về quan hệ nhân quả hoặc nguồn gốc bằng SPARQL. Áp dụng tiêu chuẩn giúp giảm công sức chuyển đổi giữa danh mục, đồ thị tri thức và công cụ AI, đồng thời giúp các tín hiệu quản trị có thể được máy đọc trên nhiều hệ thống.

Khung triển khai tinh gọn: Từ 20 khái niệm đến môi trường thực tế

Hãy bắt đầu nhỏ, với một trường hợp sử dụng có giá trị cao và một tập hợp khái niệm giới hạn. Bước 1: chọn trường hợp sử dụng và các câu hỏi năng lực cần trả lời. Bước 2: xác định 20–50 khái niệm cốt lõi từ bảng thuật ngữ, báo cáo và phỏng vấn chuyên gia lĩnh vực (SME). Bước 3: ánh xạ các mối quan hệ và viết tiên đề để hỗ trợ những suy luận cần thiết. Bước 4: bổ sung thông tin về dòng dữ liệu, tham chiếu tập dữ liệu, điểm chất lượng và quyền sở hữu. Bước 5: quản lý phiên bản, kiểm thử độ chính xác suy luận bằng các truy vấn tiêu biểu và thực thi quy tắc truy cập khi vận hành. Chỉ mở rộng tập khái niệm sau khi đã ghi nhận những cải thiện có thể đo lường về khả năng truy xuất nguồn gốc và tính chính xác của quyết định.

Đánh giá thành công bằng ba chỉ số: độ chính xác suy luận (các câu trả lời suy ra có khớp với kết quả mong đợi không?), khả năng truy xuất nguồn gốc (có thể truy vết từng câu trả lời về các nguồn và cột dữ liệu đã được chứng nhận không?) và mức độ nhận biết quyền truy cập (các trường bị hạn chế có được chặn hoặc chuyển sang quy trình phê duyệt khi cần không?). Những chỉ số vận hành này giúp tập trung nỗ lực duy trì ontology và tạo cơ sở để mở rộng từng bước với lợi tức đầu tư (ROI) có thể chứng minh.

Câu hỏi thường gặp

Nên mô hình hóa bao nhiêu khái niệm trong giai đoạn đầu?

Tập trung vào 20–50 khái niệm có tác động lớn, gắn với một trường hợp sử dụng. Phạm vi này đủ rộng để hỗ trợ suy luận và truy xuất nguồn gốc có ý nghĩa, nhưng vẫn đủ nhỏ để nhanh chóng cải tiến cùng các chủ sở hữu và dữ liệu xác thực.

Tôi có cần OWL và RDF để khai thác giá trị từ ontology không?

Các tiêu chuẩn như OWL và RDF giúp ý nghĩa có thể chuyển đổi giữa các hệ thống và máy có thể đọc được, nhưng bạn có thể bắt đầu với một mô hình nội bộ thực tiễn. Hãy chuyển sang RDF/OWL khi cần khả năng tương thích giữa nhiều hệ thống, suy luận hình thức hoặc xác thực tự động bằng SHACL và SPARQL.

Làm thế nào để ontology không bị lỗi thời?

Phân công chủ sở hữu chịu trách nhiệm, quản lý phiên bản các định nghĩa, liên kết khái niệm với dòng dữ liệu và chỉ số chất lượng, đồng thời bổ sung cơ chế giám sát để đối chiếu kết quả suy luận với câu trả lời kỳ vọng. Nhờ đó, có thể phát hiện sai lệch trước khi tác nhân lan truyền các quyết định sai.

#Đồ Thị Kiến Thức Theo Cấu Trúc#Đồ Thị Ngữ Cảnh Doanh Nghiệp#Đại lý AI Doanh nghiệp#Quy trình RAG#Căn cứ vào nguồn#Truy xuất nguồn gốc dữ liệu doanh nghiệp#Quản Trị Đại Lý Doanh Nghiệp#Quản Trị Dữ Liệu Nhạy Cảm#Ủy quyền Thời gian Chạy cho Đại lý#Đánh giá & Truy xuất nguồn gốc#bản thể luận doanh nghiệp#Quản trị bản thể luận#tiêu-chuẩn-rdf-owl#Suy luận của tác nhân

Bản tin Góc nhìn AI

Nhận các cập nhật AI, tin tức công cụ và góc nhìn mới nhất được gửi đến hộp thư của bạn.

Không spam. Hủy đăng ký bất cứ lúc nào.
Trên trang này
1.Ontology thực chất là gì (và vì sao tiên đề quan trọng)2.Ontology khác gì hệ phân loại, đồ thị tri thức và mô hình dữ liệu?3.Cách tác nhân sử dụng ontology khi vận hành4.Tiêu chuẩn và công cụ: RDF, OWL, SPARQL và SHACL5.Khung triển khai tinh gọn: Từ 20 khái niệm đến môi trường thực tế
Chia sẻ bài viết này

Bài viết liên quan

Từ Lời Gợi Ý Đến Đồ Thị: Cẩm Nang Năm Lớp Cho Ứng Dụng AI Hiện Đại
Hướng dẫn Quy trình Làm việc với AI

Từ Lời Gợi Ý Đến Đồ Thị: Cẩm Nang Năm Lớp Cho Ứng Dụng AI Hiện Đại

7 thg 9, 2026

GPU Không Đủ: NVIDIA Spectrum‑X Đưa Nút Thắt AI Vào Mạng Lưới
Tin tức Sản phẩm AI

GPU Không Đủ: NVIDIA Spectrum‑X Đưa Nút Thắt AI Vào Mạng Lưới

3 thg 9, 2026

Công Ty Siêu Tinh Gọn: Cách Các Nhóm AI Nhỏ Có Thể Sản Xuất Nhiều Hơn Các Tập Đoàn Lớn
Tin tức Chung về Ngành AI

Công Ty Siêu Tinh Gọn: Cách Các Nhóm AI Nhỏ Có Thể Sản Xuất Nhiều Hơn Các Tập Đoàn Lớn

31 thg 8, 2026

Từ MCP đến MHS: Tiêu Chuẩn Phần Cứng của Anthropic Biến Các Tác Nhân Thành Người Vận Hành Thực Tế
Tin tức Sản phẩm AI

Từ MCP đến MHS: Tiêu Chuẩn Phần Cứng của Anthropic Biến Các Tác Nhân Thành Người Vận Hành Thực Tế

29 thg 8, 2026

Giai Đoạn Tiếp Theo Của Lập Trình AI: Xác Thực Chứng Minh Build, Kiểm Tra và Hợp Nhất An Toàn
Tin tức Chung về Ngành AI

Giai Đoạn Tiếp Theo Của Lập Trình AI: Xác Thực Chứng Minh Build, Kiểm Tra và Hợp Nhất An Toàn

13 thg 8, 2026