

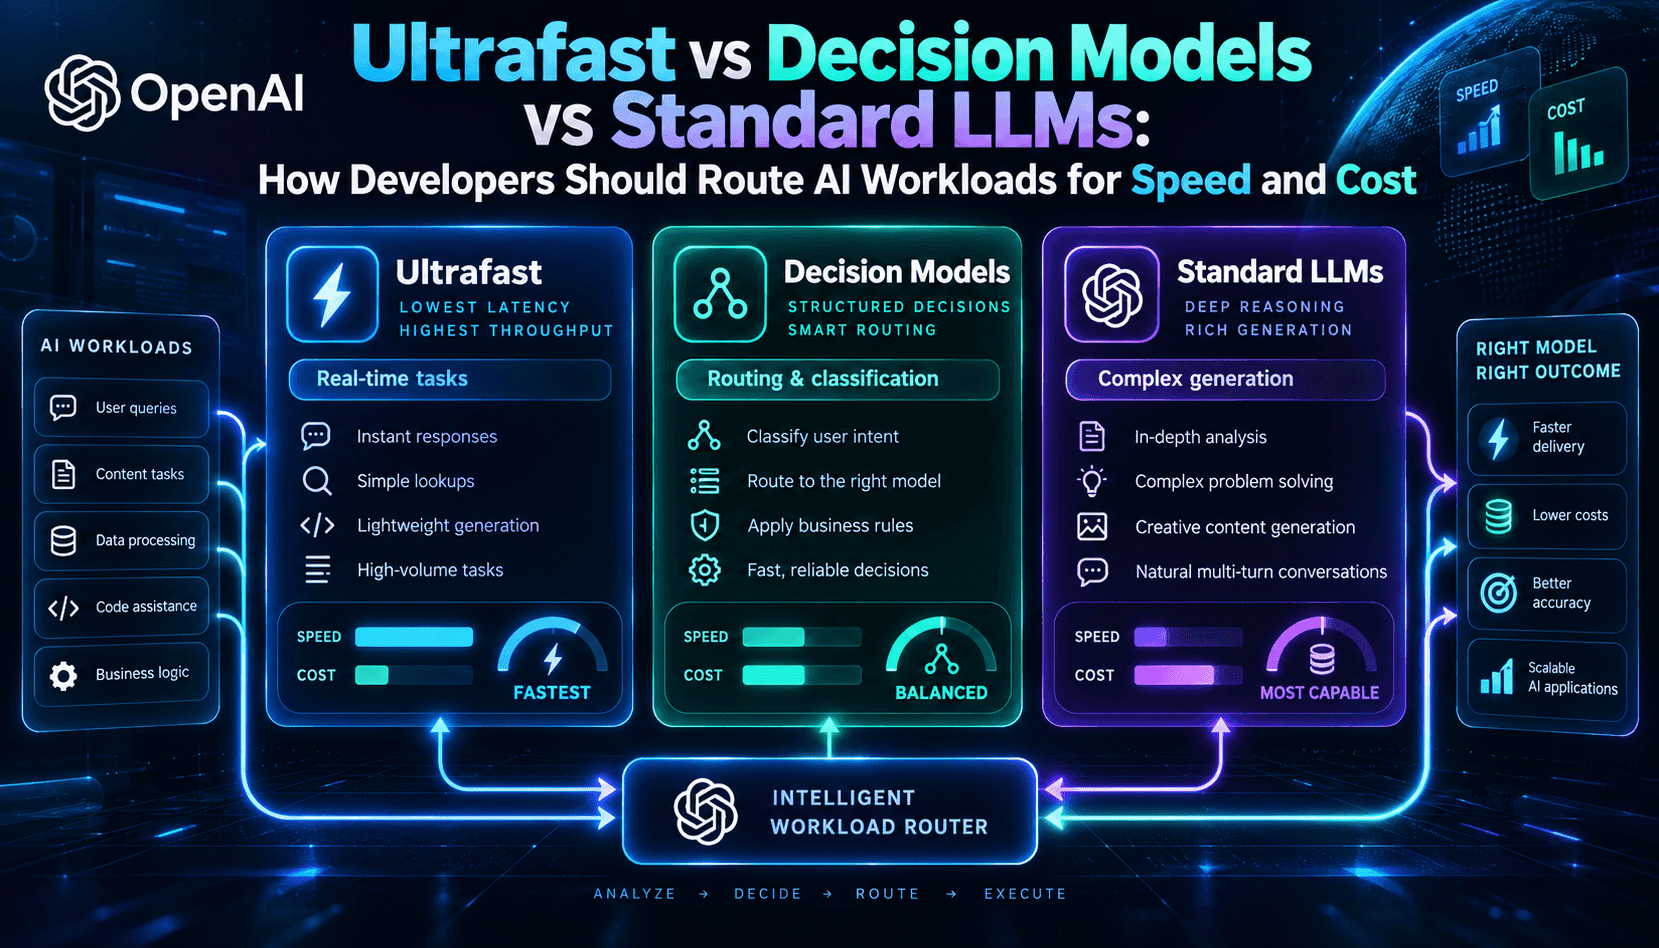
Các nhà phát triển thường phải lựa chọn kiến trúc: gửi mọi yêu cầu đến mô hình mạnh nhất hay định tuyến công việc đến các endpoint chuyên biệt có chi phí thấp hơn và tốc độ cao hơn. Những bổ sung gần đây của OpenAI—GPT-6.1 Sol Ultrafast và GPT-6 Luna Decisions—giúp lựa chọn này trở nên thiết thực hơn. Ultrafast Sol giảm độ trễ tạo token cho các luồng sinh nội dung; Luna Decisions cung cấp câu trả lời và quyết định có cấu trúc với thông lượng nhanh hơn khoảng một bậc độ lớn so với các endpoint Responses đầy đủ. Bài viết này chuyển những cải tiến nền tảng đó thành các phương án định tuyến thực tế mà bạn có thể áp dụng ngay.
Trước khi định tuyến, hãy phân loại khối lượng công việc theo bốn tiêu chí: độ sâu suy luận cần thiết (phân loại đơn giản hay chuỗi suy luận sâu), độ trễ có thể chấp nhận (giao diện dưới 100 ms hay xử lý hàng loạt trong vài giây), cấu trúc đầu ra (quyết định có kiểu dữ liệu hay văn bản tự do) và mức độ nhạy cảm với chi phí. Chẳng hạn, các tác vụ phân loại và định tuyến ngắn, có tính xác định thường chỉ cần Decisions API. Tạo hội thoại giàu tính sáng tạo sẽ phù hợp với các biến thể Sol hoặc Astra có khả năng suy luận đầy đủ; còn truyền token với thông lượng cao cho giao diện sẽ hưởng lợi nhiều nhất từ dòng Ultrafast. Ánh xạ khối lượng công việc theo các tiêu chí này giúp tránh lạm dụng những mô hình tiên tiến có chi phí cao.
Trên thực tế, hãy triển khai ba luồng định tuyến bổ trợ cho nhau: luồng Decisions (Luna) dành cho quyết định có cấu trúc, thông lượng cao và phân loại; luồng tạo sinh Ultrafast (GPT-6.1 Sol với service_tier:"ultrafast") dành cho truyền token độ trễ thấp và giao diện tương tác; cùng luồng suy luận (GPT-6 Sol/Astra) dành cho suy luận phức tạp, tổng hợp mã hoặc sử dụng công cụ nhiều bước. Bổ sung một bộ định tuyến gọn nhẹ để chọn luồng dựa trên siêu dữ liệu như độ dài prompt, mức suy luận dự kiến, ngân sách độ trễ và việc yêu cầu có cần đầu ra có cấu trúc, kiểu dữ liệu cụ thể hay không.
Ví dụ cụ thể: dùng Decisions để phát hiện thư rác, định tuyến ý định, đưa ra quyết định cho feature flag, phân loại đơn giản và tạo đầu ra có kiểu dữ liệu; dùng Ultrafast cho trò chuyện truyền trực tiếp, tự động hoàn thành, gợi ý theo thời gian thực và trải nghiệm giao diện mà người dùng ưu tiên phản hồi tức thì hơn một chút suy xét sâu; chỉ dùng các mô hình suy luận đầy đủ cho việc tạo mã, phân tích nhiều bước hoặc những trường hợp mà việc gọi công cụ và suy luận dài thực sự làm thay đổi kết quả. Những cách làm này giảm tổng chi phí mà vẫn giữ độ chính xác ở những nơi quan trọng nhất.