

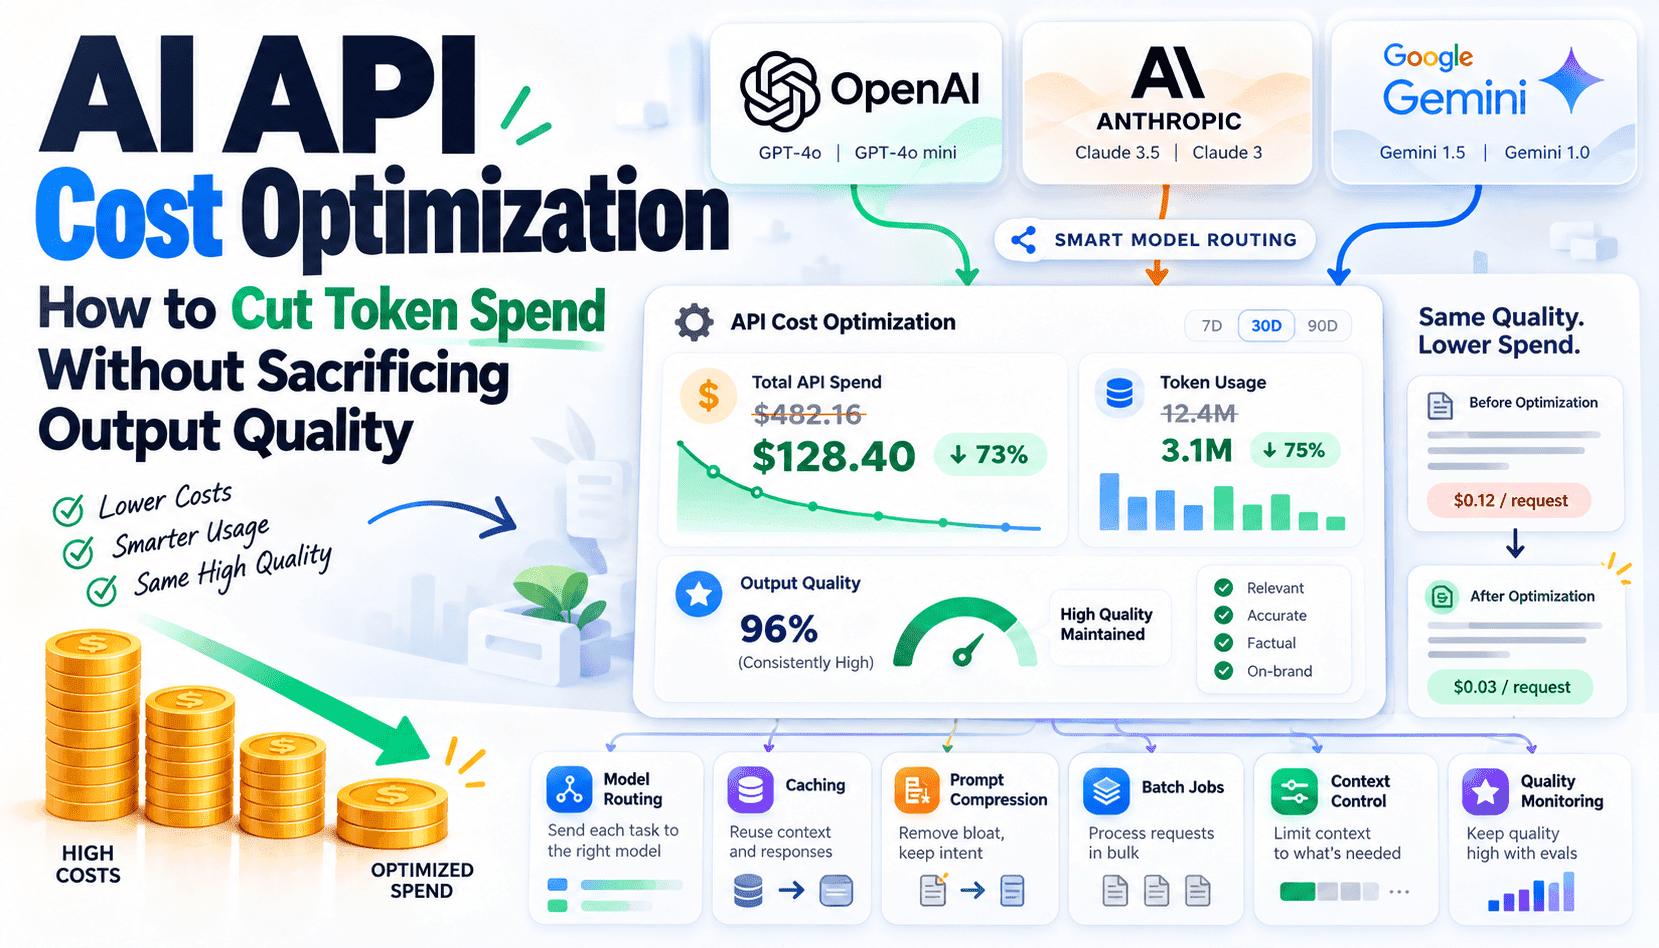
生成式 AI 的蓬勃發展,讓 Token 成本成為不可忽視的支出項目。若缺乏控管,Token 支出會隨著使用者數量、上下文長度與未受限制的輸出一同攀升。成本最佳化並不是一味選用最便宜的模型,而是要依照任務複雜度選擇合適的模型能力、減少輸入與輸出中不必要的 Token,並調整工作流程,確保只有在能明顯改善業務成果時,才使用成本較高的推論。本文將說明團隊可採取的營運措施,以及衡量取捨時應追蹤的指標。
首先,建立路由與能力對照表:依照複雜度和品質敏感度為請求分類,再將低複雜度任務導向規模較小、成本較低的模型或確定性模組。例如,短文案潤飾、格式嚴謹的翻譯或簡單的意圖擷取,通常可交由蒸餾模型或啟發式方法處理;創意長文生成與細膩的多步驟推理,則應交由能力更強的模型。為每條路由設定成功率與轉送指標,便能找出較便宜的路徑何時失效,並只在必要時升級處理。
透過提示詞工程控管成本,有三個實用做法:在不損失語意的前提下精簡指令、盡可能重用共用的系統上下文,以及刪減動態上下文。使用精簡範本、編號的少樣本範例與結構化函式結構描述,降低提示詞冗長程度。將穩定的系統上下文保留在伺服器端,只附加增量的動態內容。對於冗長的對話紀錄,應先摘要再傳送,而非重新傳送所有原始訊息;對於大量文件的任務,則應檢索並排序最相關的段落,而不是把整份文件都塞進提示詞。
除了提示詞,也要在技術架構中加入快取、批次處理與流程控管。混合式語意與完全比對快取,可避免對相同內容重複執行成本高昂的推論。將低優先級工作安排在離峰時段,或放到成本較低的運算資源池中批次處理。盡可能設定輸出上限、停止 Token,並採用確定性的函式呼叫,避免模型無限制地產生文字。最後,建立整合式成本控管架構,同時追蹤輸入 Token、輸出 Token、快取命中率、延遲與品質指標,讓決策能兼顧成本與產品成效。