

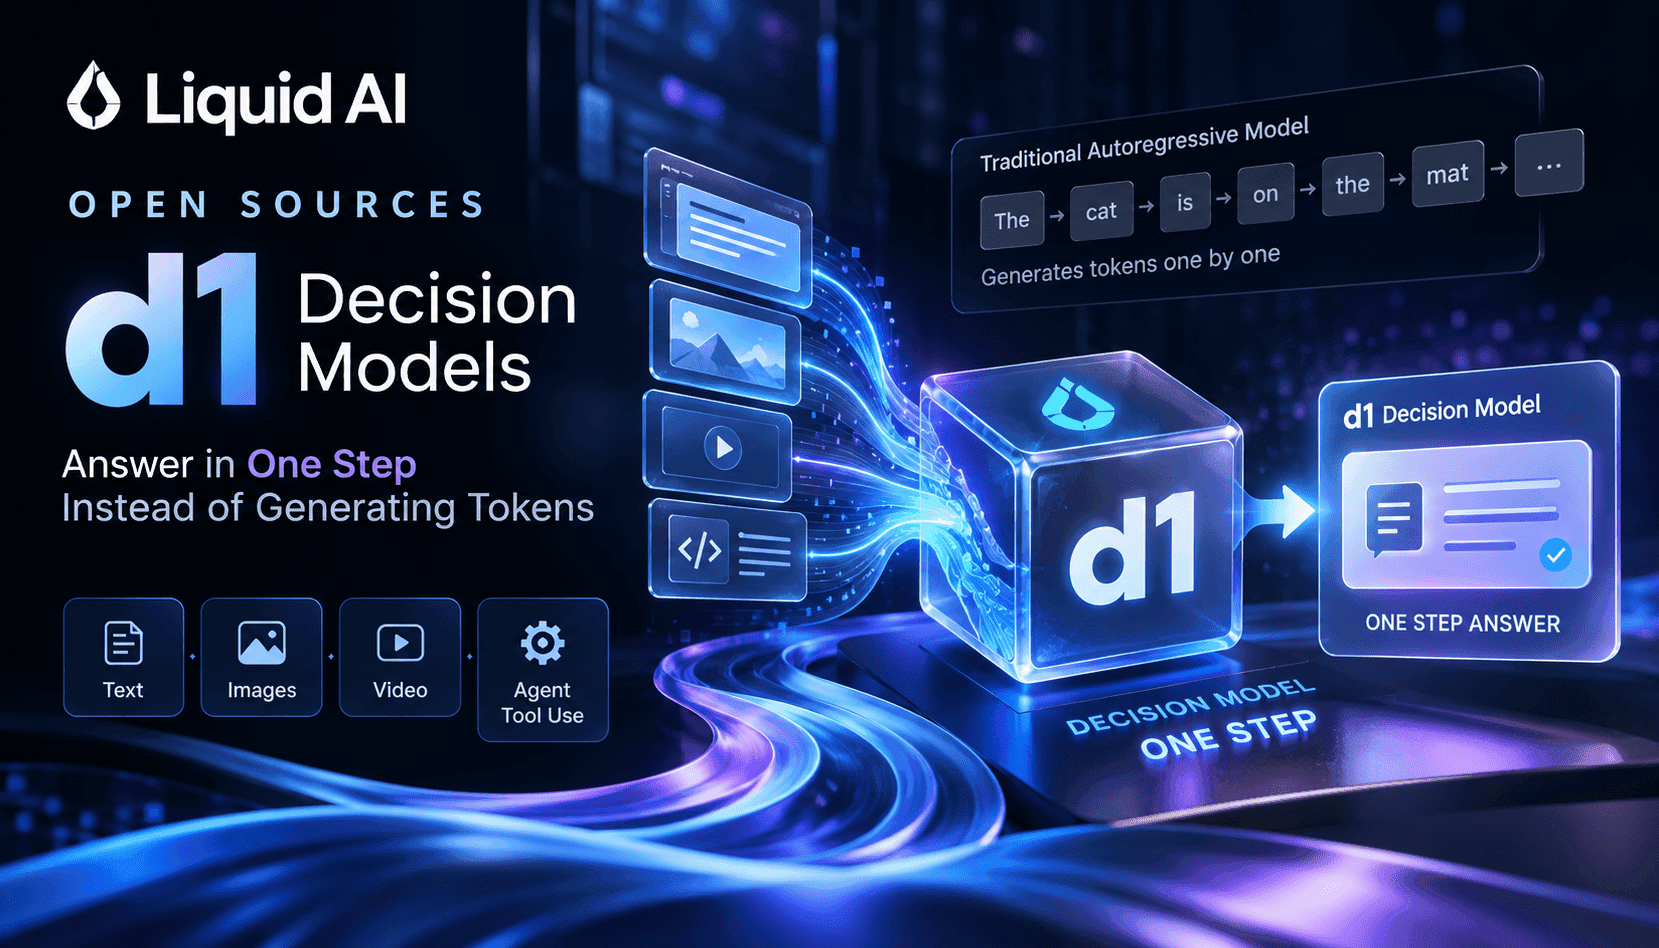
Liquid AI 推出 d1,明確展現從自回歸 token 生成轉向結構化決策模型的方向:模型只需一次前向傳播,就能針對離散標籤輸出經校準的機率分布。不同於逐個 token 組織答案的大型語言模型(LLM),這類決策模型會評估輸入內容,並回傳精簡的信心度向量。這項轉變在 API 層面看似細微,對需要確定、快速且可稽核結果,而非對話文字的系統而言,卻有重大影響。
實際來說,d1-3B 和 d1-omni-600M 適用於重視處理量與可解釋性、更勝生成流暢度的情境。工單分流、垃圾訊息過濾、內容審核、製造業品質管控分流及工業分類,都能受惠於單步決策:它能縮短請求路徑、消除解碼造成的變異,並產生可設定閾值、校準、記錄的機率,直接交由下游規則引擎或自動化流程使用,無須額外解析,也能降低幻覺風險。
對工程師與產品負責人而言,這項改變帶來實質的營運效益:確定性的輸出讓監控更簡單、減少因 tokenization 細節而觸發的重試,也因省去自回歸解碼迴圈而降低運算成本。在合規與稽核追蹤方面,記錄機率向量及模型版本,也比記錄自由格式文字更容易管理與檢視。不過,採用決策模型也需要新的評估方式:必須驗證模型在不同生產資料切片上的校準表現,並為分布外案例設計務實的備援處理機制。
本文將說明這項技術帶來的改變、如何衡量單步決策輸出的價值、邊緣端與雲端部署模式、整合時容易遇到的問題,以及一份簡明的營運檢查清單,協助團隊在正式工作流程中以經校準的決策模型取代 token 生成方案。