

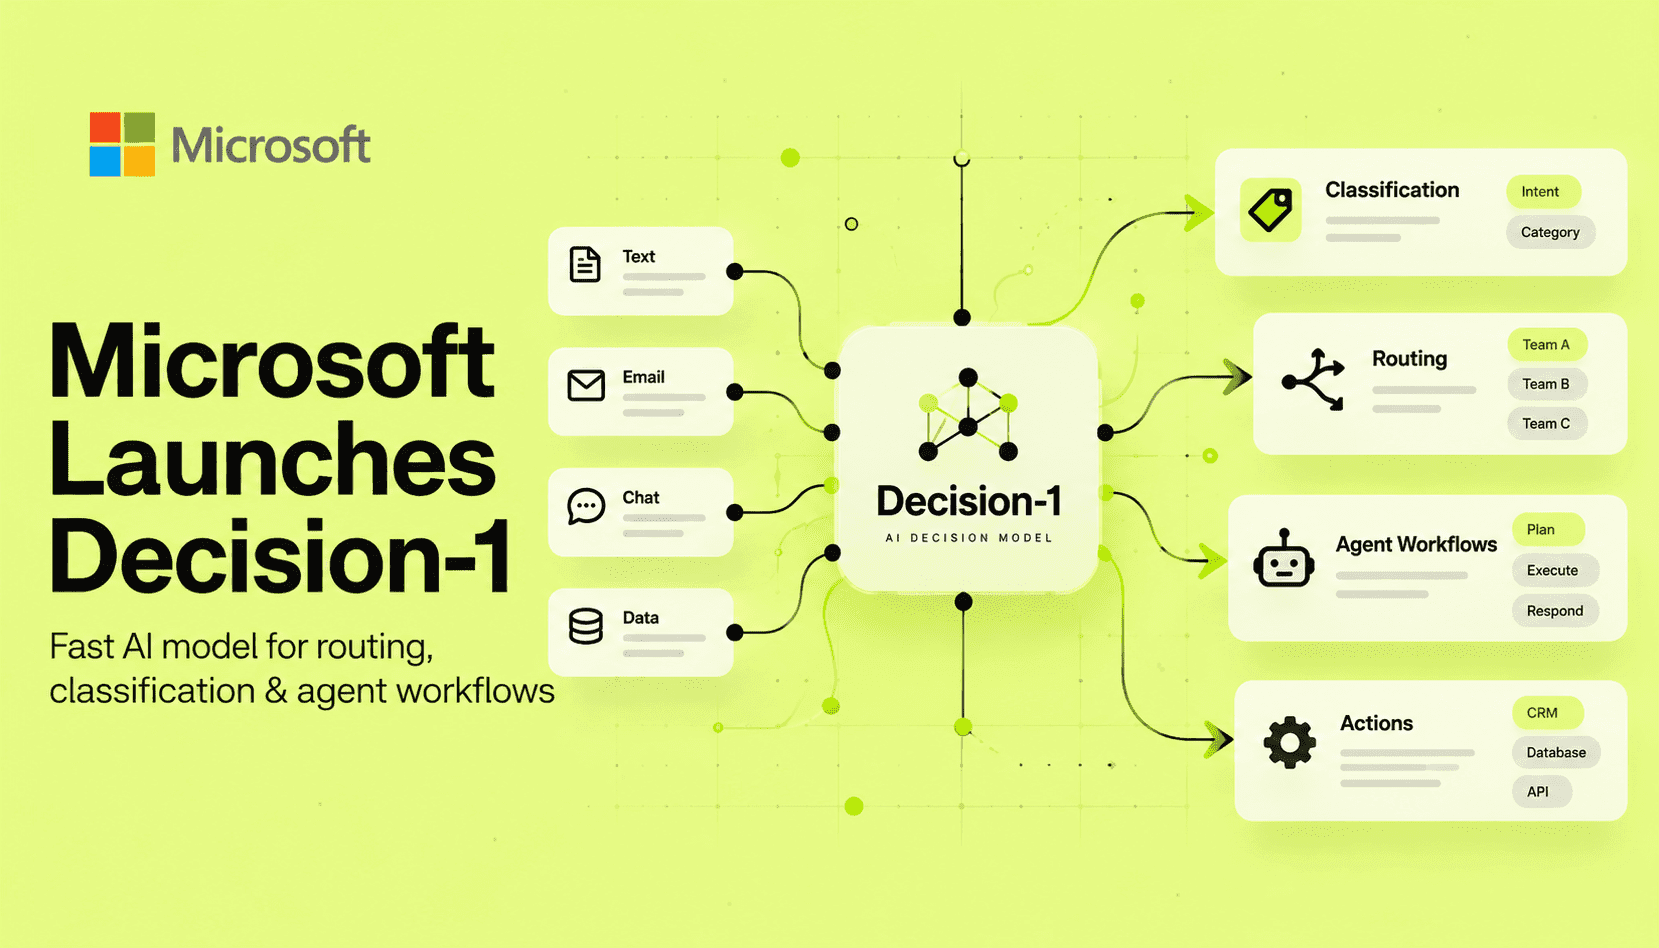
Microsoft-Decision-1 是一款專門的評分模型,適用於需要做出決策的軟體,例如選擇、排序、分類、驗證或評分,而非生成內容。不同於以產生流暢文字為目標調校的通用 LLM,這款模型能在單次前向推論中輸出結構化結果與經校準的機率。對產品團隊而言,這項差異至關重要:它能將以決策為主的工作負載,從昂貴且延遲較高的 LLM 呼叫,轉變為精簡、確定性高的評分步驟,適用於即時代理、webhook 和高吞吐量內容審核管線。
Microsoft 表示,這款模型以 Qwen3.5‑9B 為基礎,並針對校準能力與低延遲推論進行最佳化。模型會針對帶有標籤的選項輸出機率,讓軟體可直接利用機率向量進行路由或依門檻做出決策。這樣就不必再往返呼叫文字生成 LLM,也省去額外的解析或啟發式資訊擷取。單次推論即可取得經校準的分數,也讓下游遙測更簡單:團隊能衡量信心度、調整門檻並部署防護措施,不必仰賴昂貴的提示工程或多步驟驗證鏈。
Microsoft 公布的基準測試結果相當突出:Decision‑1 在涵蓋 36 項基準的比較中準確度名列前茅,更重要的是,速度遠勝生成式基準模型;在其測試中,據稱比 GPT-6 Sol 比較對象快 35 倍。當延遲、單次推論成本與吞吐量都會左右產品設計時,這種幅度的提升格外重要。不過,基準測試的情境、硬體、批次處理方式與資料集是否一致都會影響結果;團隊在決定調整架構前,應先在正式環境技術堆疊上重現關鍵微基準測試。
實務上,Decision‑1 的定位介於輕量分類器與大型 LLM 之間:它比小型分類器更專門,因為訓練與校準時涵蓋了多種決策任務;但與使用完整生成式 LLM 進行解析和決策相比,它的成本更低、速度也更快。對工程團隊而言,這提供了明確的實務方針:當目標是選擇、路由、評分或驗證時,以 Decision‑1 取代完整文字 LLM 呼叫;創作、摘要或長篇綜合整理等任務,則繼續使用生成式 LLM。
在正式環境採用決策模型時,必須留意校準能力、資料分布偏移,以及與現有代理工具鏈的整合。團隊應設定信心度門檻;一旦出現校準問題或資料漂移,就回退至生成式 LLM;並建立訓練與評估週期,讓決策模型符合業務專屬類別與成本目標。若導入得當,Decision‑1 就能降低延遲與推論成本,並提升以決策為主流程的系統確定性。