

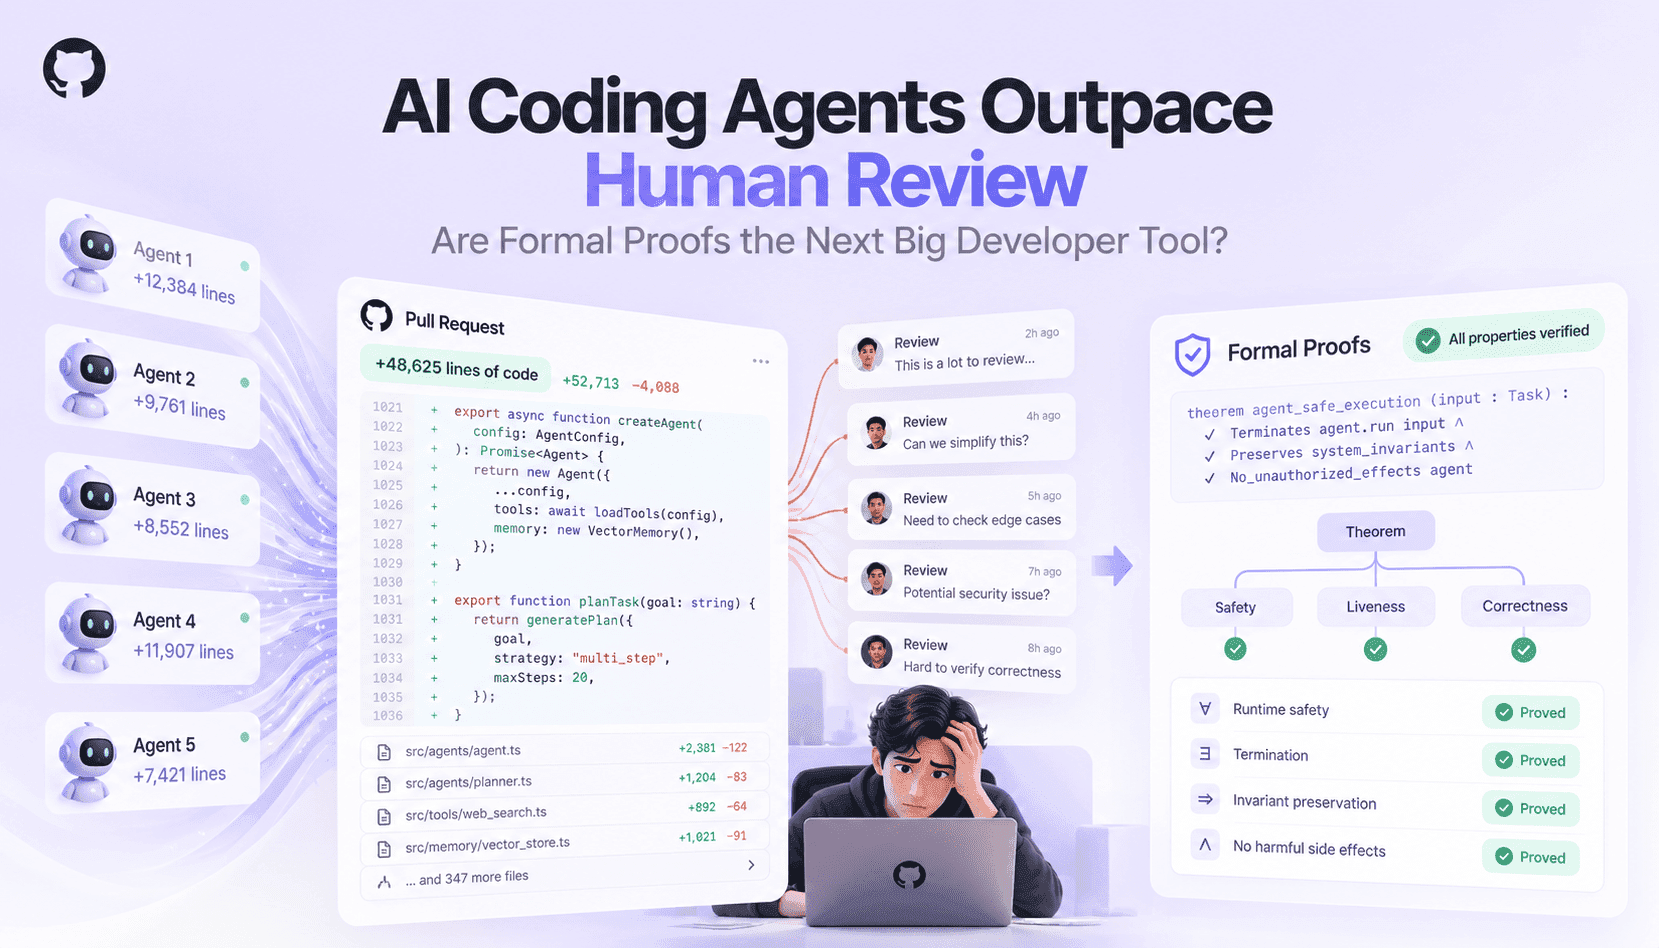
从 Copilot 衍生工具到自主智能体工作流,代码生成代理的兴起改变了工程团队的工作节奏。过去,一个团队每天处理的可能只有少量由人工编写的拉取请求;如今,许多团队收到的却是源源不断的生成式补丁、脚手架代码和新模块。代码产出量的提升加快了功能交付,但也造成了验证积压:人工审查者的时间和精力有限,而格式检查、代码检查工具和浅层审查等轻量级手段也难以随产出同步扩展。这种落差,正是智能体增强型开发流水线中事故增多、配置回归和安全配置错误频发背后的运营难题。
不同的验证技术针对不同类型的问题。单元测试和集成测试会验证指定输入下的行为;静态分析可以发现类型、流程以及某些 API 误用问题;AI 辅助代码审查能够标记风格问题和疑似缺陷;形式化验证则能在规范足够精确时,证明所有可能输入下的属性。没有哪一种方法能解决所有问题。测试可能遗漏所选输入之外的边界情况。静态分析会产生误报,也难以应对动态模式。AI 审查可能受到模型幻觉的影响。形式化证明前期成本较高,需要清晰的规范,而且往往要求代码结构受到一定约束。
微软的“证明驱动开发”研究展示了如何将形式化方法务实地融入开发流程:聚焦关键模块,并从可执行规范推导证明,团队就能消除整类测试难以发现的逻辑错误和并发错误。GitHub AI Scan 等扫描平台则可以持续、大规模地检测已知漏洞模式和存在风险的依赖项。两者共同指向一种混合方案:在适合的环节使用自动化、概率型和确定性工具,把成本高但结论明确的形式化方法留给风险最高的代码。
对于使用 Claude Code、Codex、GitHub Copilot 或智能体工作流的团队来说,实际问题在于如何把这些工具整合进运营流水线,既保留智能体带来的生产力,又让缺陷和漏洞风险保持在可控范围内。本文接下来将逐一比较各种验证方法,说明何时适合采用有针对性的形式化证明,并介绍一套分阶段工作流,将自动生成与沙箱测试、渐进式证明和人工判断结合起来,让验证能力像代码产出一样扩展,而不受审查人员规模的限制。