

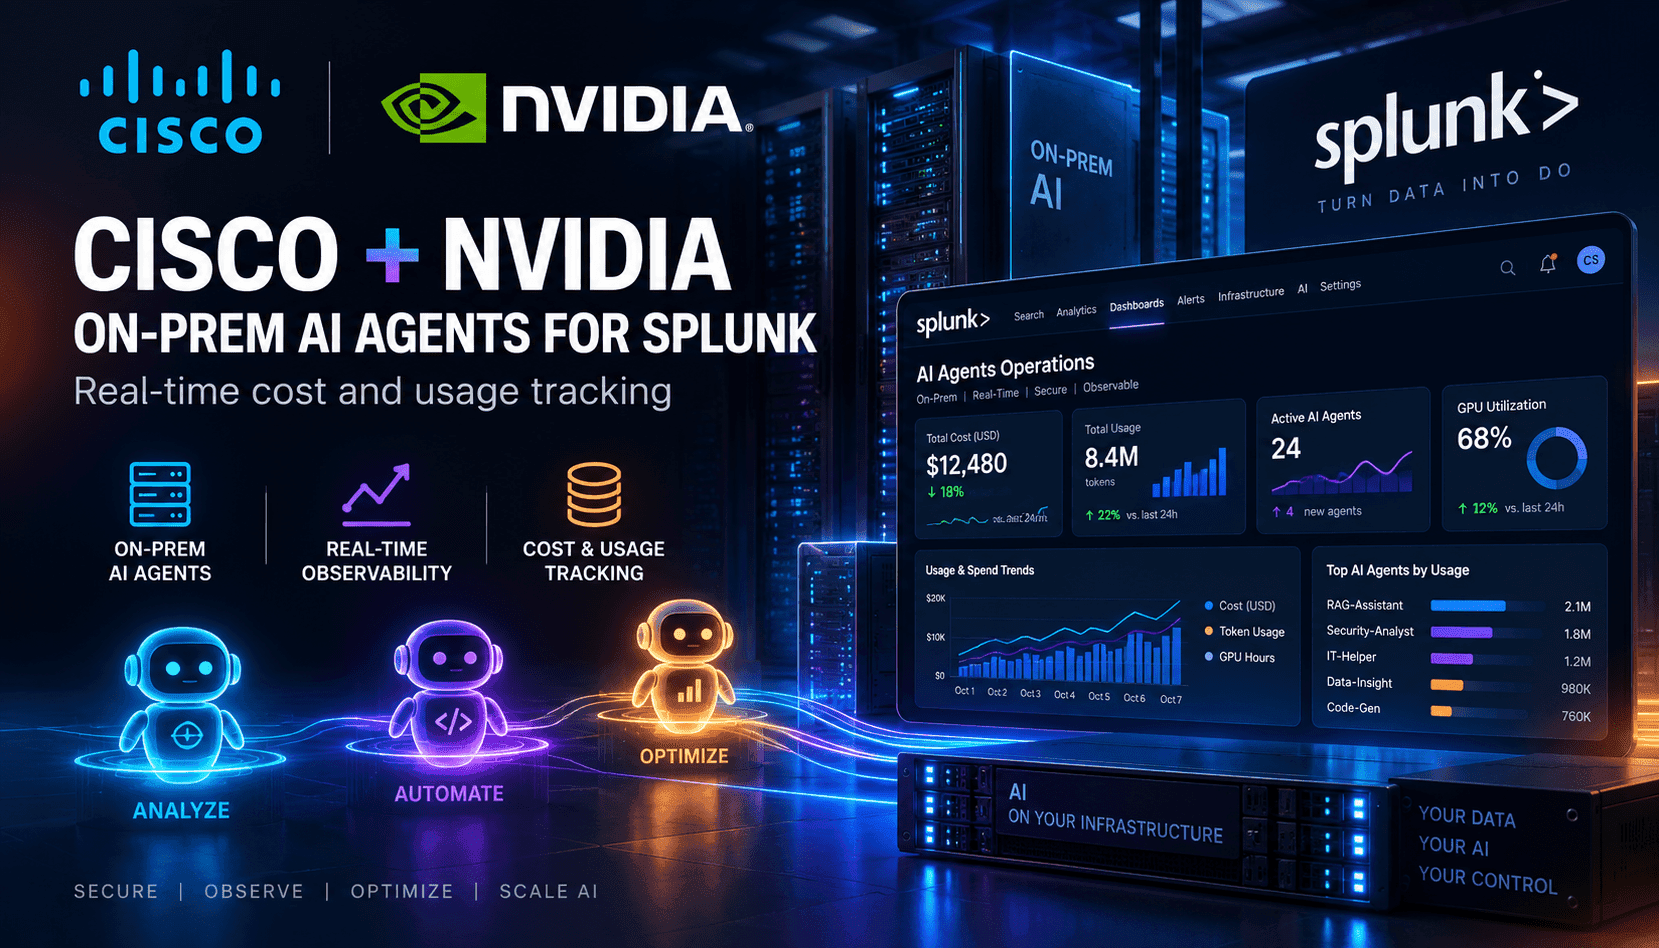
长期以来,将遥测数据集中于Splunk的企业面临着权衡:是将数据保留在本地以确保主权和安全,还是迁移到云端以访问现代AI代理。思科基于英伟达加速计算和Kubernetes运行时构建的Splunk AI POD打破了这一壁垒。它允许团队在日志和指标旁边运行Splunk的AI助手和新兴的代理启动平台,同时自托管开放和专有模型的混合。预验证的技术栈降低了集成风险和价值实现时间,为运维和安全团队提供了一个可以用现有可观测性控制措施加固的代理基础。
最显著的运营变革是成本和行为的可视化。Splunk代理可观测性的代币经济学功能按代理、用户和工作流跟踪代币消耗——包括Claude Code、Codex或Cursor等编码代理——使领导者能够将采用率与价值挂钩,而非凭空想象。它通过时间序列建模预测消耗,监测异常循环并将成本归因到业务单元。由于同一平台检查提示、响应和工具调用,团队可以应用运行时安全防护,阻止不安全操作并抑制幻觉。实际上,这意味着您可以设定预算,实时防止过度使用,并通过单位经济学证明投资回报,而非月底惊讶。
从战略角度看,该架构加速了从试点到受控代理网络的转变。通过将模型执行带到数据侧,企业避免了脆弱的ETL路径并减少了数据外泄风险。模型选择保持灵活:团队可以在运行英伟达Nemotron系列等开放权重模型的同时,使用思科的深度时间序列模型等领域专用模型进行预测。权衡点在于运营成熟度——Kubernetes、GPU调度、模型评估和提示风险管理必须作为一流学科对待。对于采购者来说,问题从“我们能否在这里使用AI?”转变为“哪些代理能带来价值,运行在哪些硬件上,并受哪些安全防护约束?”精准回答这一问题的组织将以更少的重写更快扩展。