

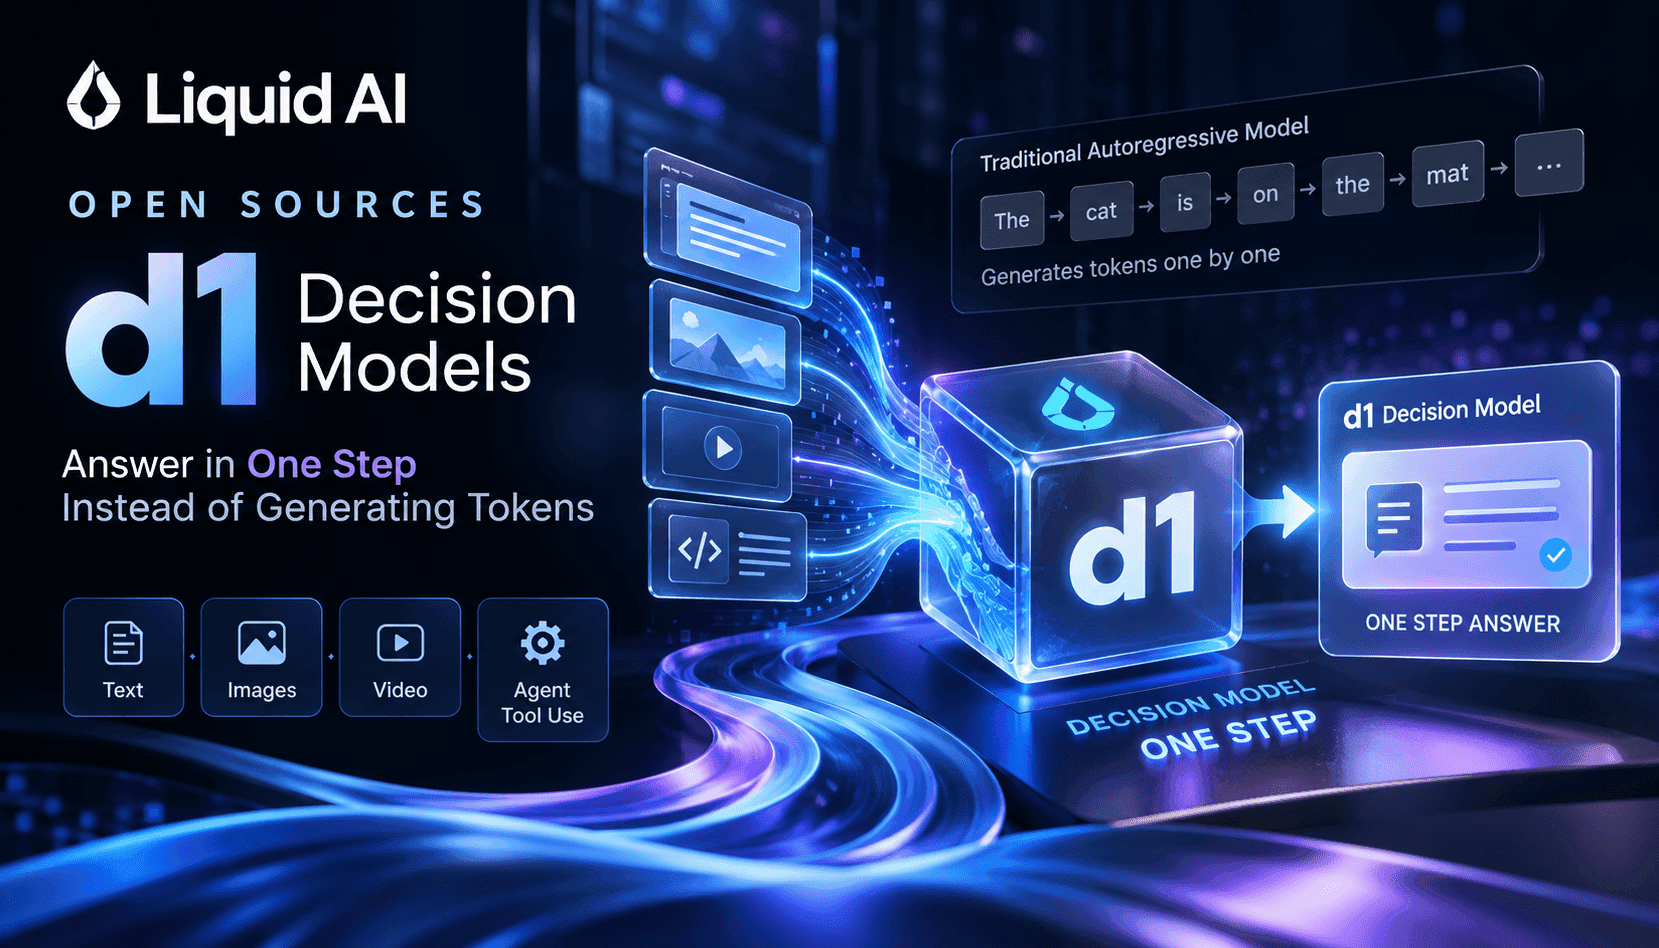
Liquid AI 发布 d1,标志着模型设计有意从自回归 token 生成转向结构化决策输出:模型只需一次前向传递,即可给出针对离散标签的校准概率分布。与逐 token 组织答案的大语言模型不同,这类决策模型会评估输入,并返回一组精简的置信度数值。从 API 层面看,这一变化似乎不大,但对于需要确定、快速且可审计结果,而非对话文本的系统而言,影响却十分显著。
在实际应用中,d1-3B 和 d1-omni-600M 面向更看重吞吐量与可解释性、而非生成流畅度的场景。工单路由、垃圾信息过滤、内容审核、制造业质量控制分流和行业分类,都能从一步决策中受益:它能缩短请求链路、消除解码带来的波动,并生成可用于设定阈值、校准、记录,以及传递给下游规则引擎或自动化流程的概率,无需额外解析,也能降低幻觉风险。
对于工程师和产品负责人来说,这种架构能带来切实的运营改善:确定性输出简化了监控,减少因 token 化细节而触发的重试,并通过免去自回归解码循环来降低算力成本。在合规和审计追踪方面,记录概率向量和模型版本,也比记录自由文本更容易分析和追溯。不过,采用决策模型也需要新的评估方法——必须验证模型在生产环境不同数据切片上的校准情况,并为分布外情况设计实用的回退机制。
本文将介绍这项变化的意义、如何衡量一步决策输出的价值、边缘端与云端的部署模式、集成时容易遇到的问题,以及一份简明的运营检查清单,帮助团队在生产工作流中用经过校准的决策模型取代 token 生成方案。