

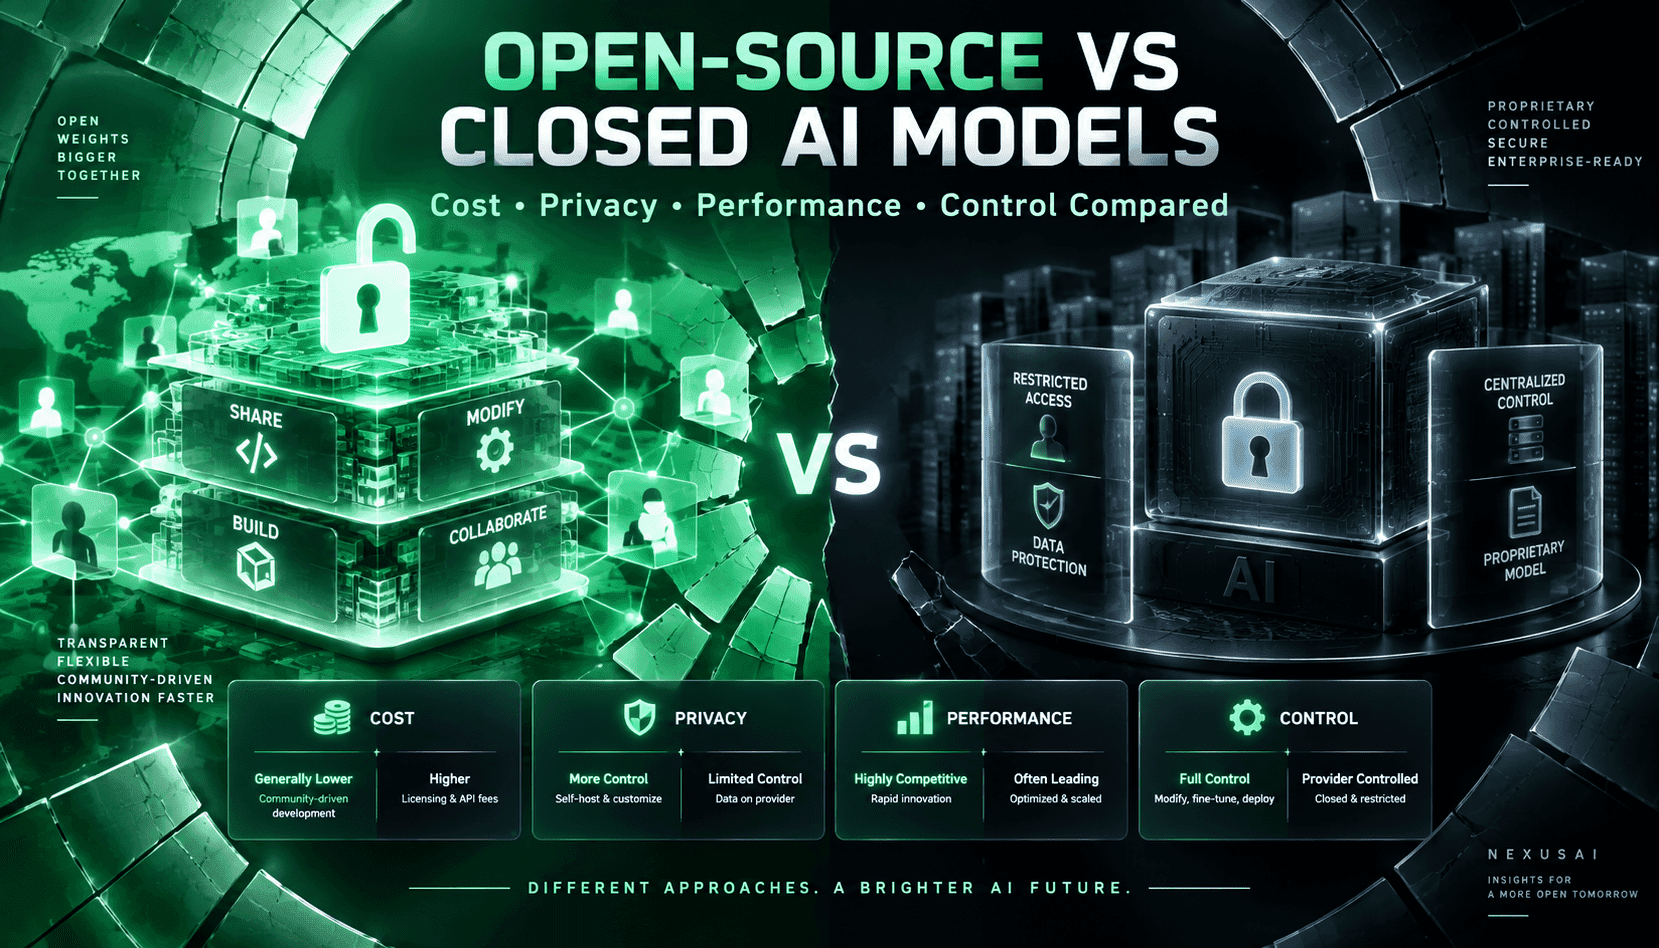
大多数团队仍将模型选择视为争夺最高分的竞赛,但运营决策更为广泛:结果的成本是多少,谁掌控数据路径?开源权重模型在许多实际工作负载上,尤其是编码和结构化输出方面,已接近高端系统的表现。封闭选项在通用推理深度和代理可靠性方面仍占优势。现代买家指南融合两者:按任务类型而非品牌路由,实现显著节省,同时在关键领域不牺牲质量。
标价仅是起点。有效成本取决于冗长度、上下文长度、工具使用模式、重试次数和监控开销。通过智能路由,组织通常能在类似实施任务中发现高端封闭模型与强大开源权重模型之间输出成本差异达5–8倍。但当冗长度激增或可靠性需求迫使多次尝试时,这种优势会缩小。换句话说:每百万令牌最便宜的模型不一定是每个解决任务成本最低的模型。务必监测工作负载,计算整个流程的成本,而非仅仅推理部分。
隐私态势是第二个决策点,绝非事后考虑。自托管开源权重可实现强数据控制、确定性出口,并可选择将日志完全保留在自有环境中——这对受监管团队和含敏感代码或个人信息的机器学习平台尤为重要。管理型封闭服务则通常提供即插即用的合规文档、成熟的滥用防护和稳定的SOC 2/ISO报告。两种路径都能保证安全,只是风险集中方式不同:开源将责任转移给团队;封闭则将信任集中在供应商的控制和路线图上。
性能依然复杂。封闭模型通常在复杂多步推理和长时多代理工作流中保持优势。开源权重在编码、检索增强任务和良好搭建的工作流中竞争力日益增强。基准测试有帮助,但不能决定采购:利用差异、输出冗长度和提示搭建可以显著影响分数。务必在自己的技术栈中使用代表性仓库、工具架构和延迟预算进行验证,然后将路由规则和服务水平协议写入运行手册。