

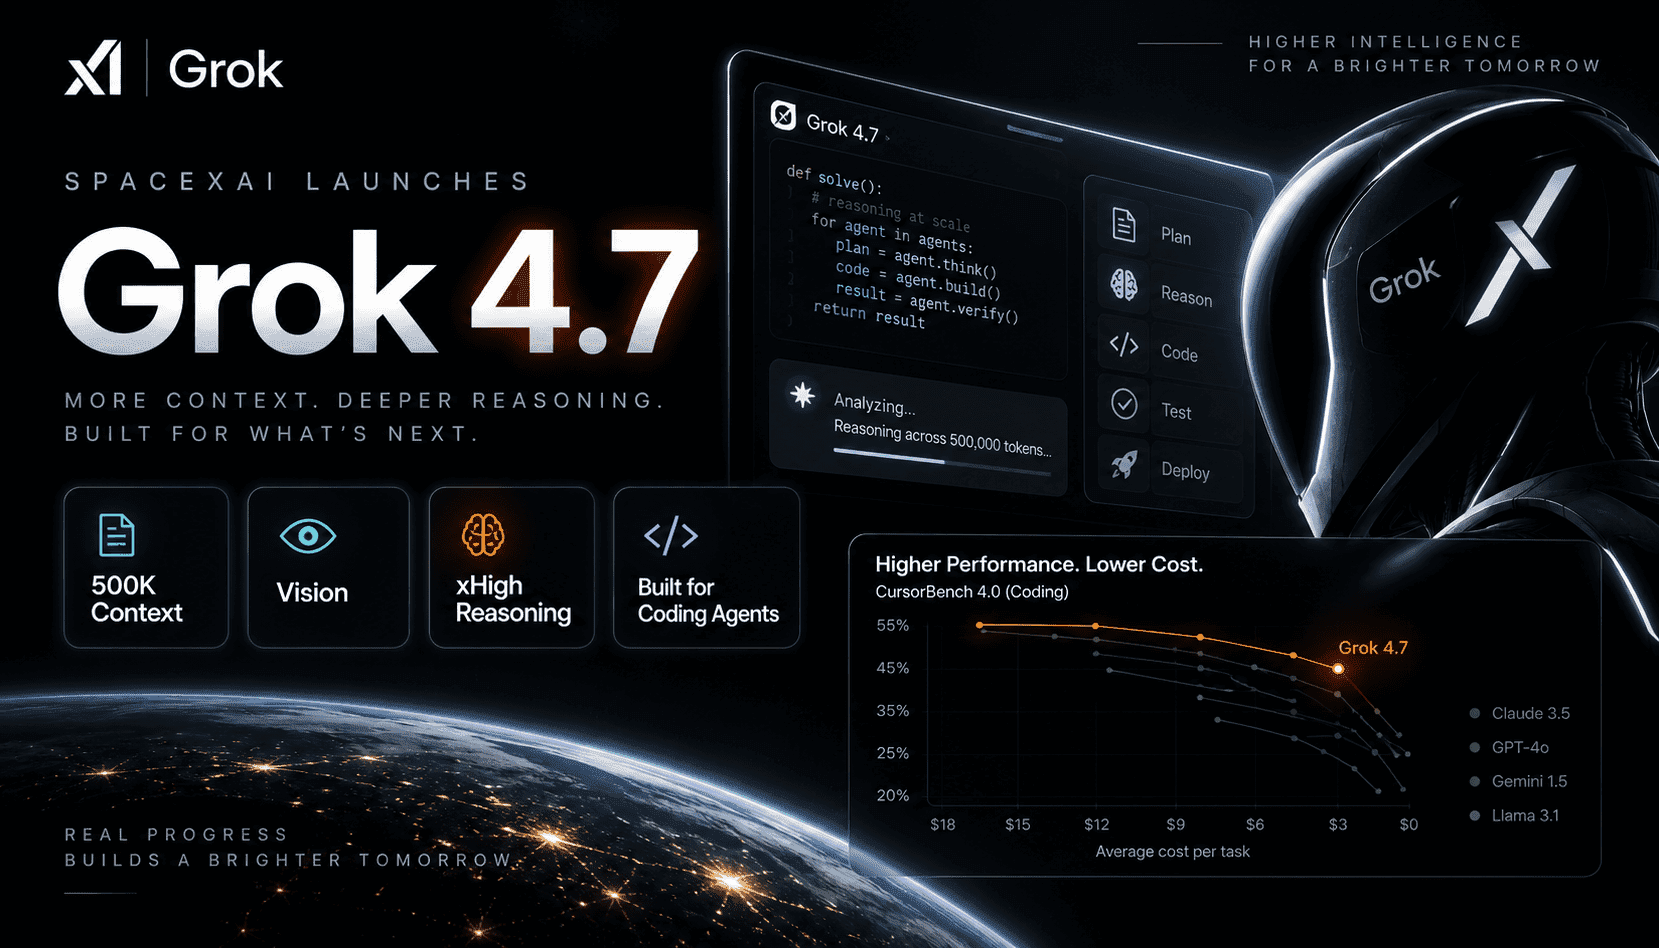
SpaceXAI 的 Grok 4.7 专为持续编码和知识工作打造。50 万令牌的上下文窗口通过允许整个代码库、多文件差异或详尽的规格文档驻留内存,减少了检索开销。模型的本地视觉功能为调试截图、审查图表和解释 UI 状态提供了实用性。最重要的是,4.7 强调超高推理和自我验证,实现了更长、更可靠的多步骤执行,减少了工具间的交接。该版本与 4.6 处于同一价格档位,并提供快速变体,直接面向开发者环境、编码代理和多小时专业任务,解决了以往上下文和验证限制带来的摩擦。
早期信号显示其在长时间代码任务上的性价比表现强劲,在 CursorBench 4.0 上有提升,并在多小时办公和终端工作中表现出更好的耐力。DeepSWE 和 EEBench 的成绩表明其在技术领域具有更强的推理准确性和错误恢复能力,同时模型的 harness-aware 训练旨在减少代理工作流中的对话漂移。更长的上下文和更安全的默认设置将简化架构:减少分块技巧、更精简的检索器和更小的提示框架。对于处理大型规格或合规文档的团队,4.7 扩展的工作内存可能将多次流程转化为单次流程,配合上下文内草稿板和结构化自检。
安全性显著增强。新的安全防护堆栈报告了更强的防越狱能力和更好的双重用途处理,同时不过度阻断合法的安全工作。这对企业采用尤为重要,因为代理系统常常涉及终端、代码执行和敏感数据。运营方面,4.7 通过 API、编码 harness 和路由器提供,输入令牌价格为每百万 2 美元,输出令牌为每百万 6 美元,并提供速度和价格均为两倍的可选快速档。团队应在真实工作负载上进行对比试点,衡量任务完成质量、工具调用可靠性和每完成任务的总成本,而非单纯关注延迟或单次基准分数。