

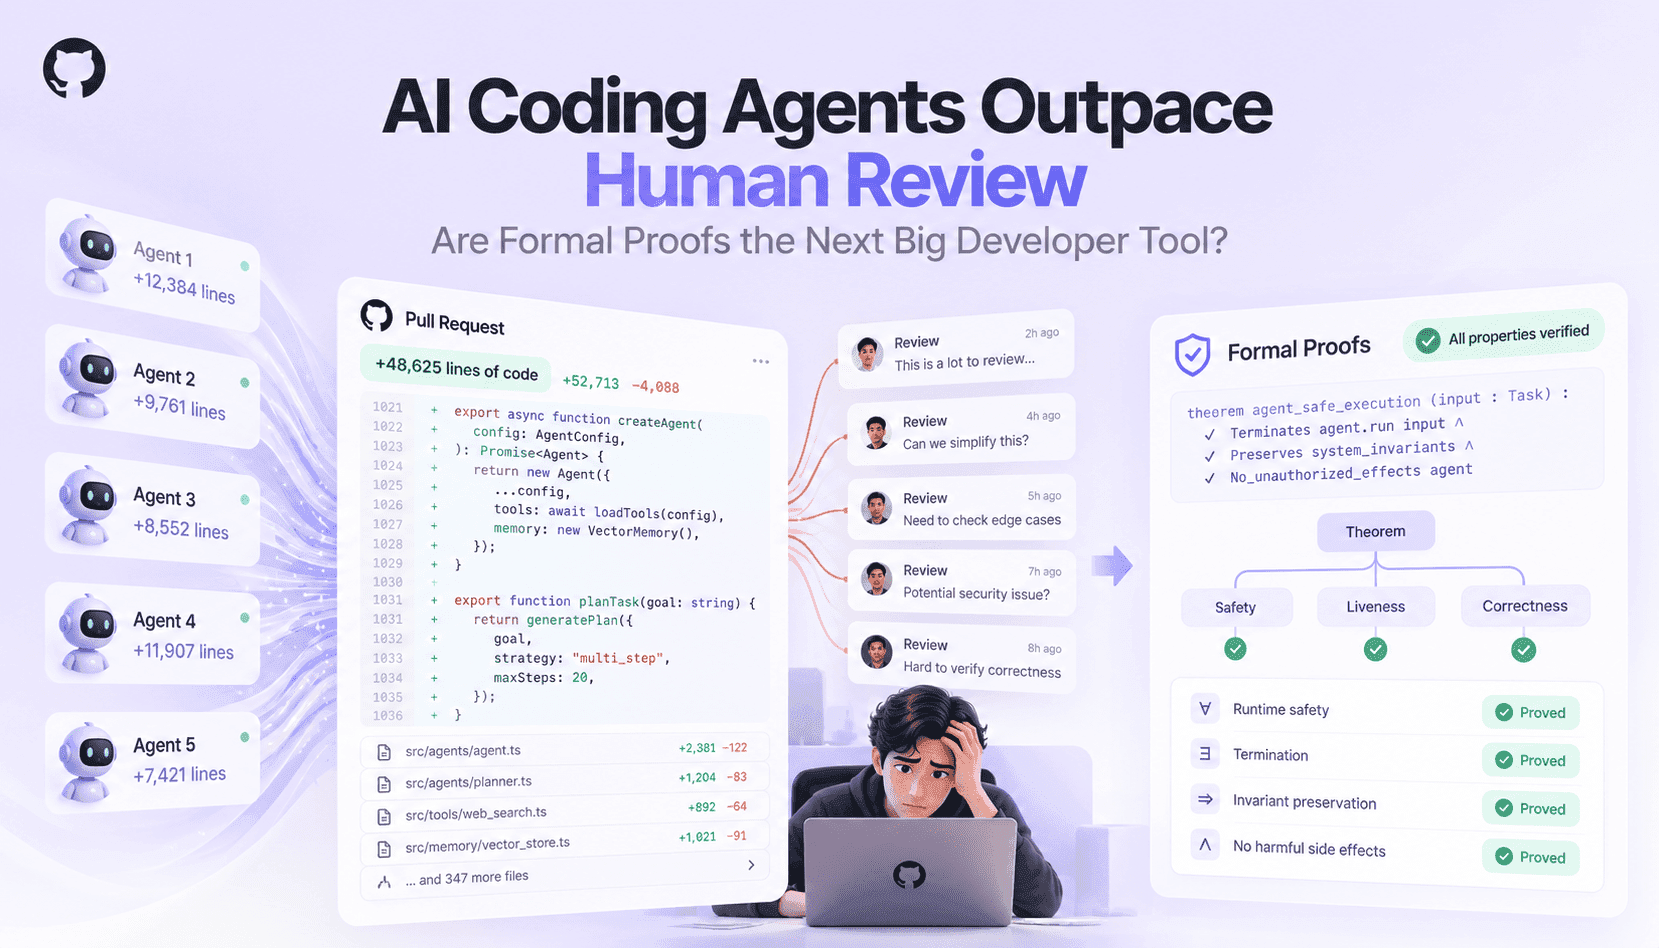
Der Aufstieg von Agenten, die Code schreiben – von Copilot-Ablegern bis hin zu autonomen Agenten-Workflows – hat den Takt in der Softwareentwicklung verändert. Früher bearbeitete ein Team vielleicht eine Handvoll von Menschen verfasster Pull Requests pro Tag; heute erhalten viele Teams ganze Ströme automatisch erzeugter Patches, Gerüste und neuer Module. Dieses Volumen beschleunigt die Feature-Entwicklung, schafft aber zugleich einen Rückstau bei der Verifikation: Die Kapazität menschlicher Reviewer ist begrenzt, und einfache Prüfungen wie Formatierung, Linter und oberflächliche Reviews lassen sich nicht beliebig skalieren. Diese Lücke ist das operative Kernproblem hinter zunehmenden Vorfällen, Konfigurationsregressionen und Sicherheitsfehlkonfigurationen in Pipelines, die durch Agenten erweitert werden.
Verschiedene Verifikationsmethoden erkennen unterschiedliche Fehlerarten. Unit- und Integrationstests prüfen das Verhalten für vorgegebene Eingaben; statische Analysen entdecken Typ- und Ablaufprobleme sowie bestimmte Fehler bei der API-Nutzung; KI-gestützte Code-Reviews weisen auf Stilprobleme und wahrscheinliche Bugs hin; formale Verifikation beweist Eigenschaften für alle möglichen Eingaben – sofern sich eine präzise Spezifikation formulieren lässt. Keine dieser Methoden ist ein Allheilmittel. Tests übersehen Randfälle außerhalb der gewählten Eingaben. Statische Analysen liefern falsch positive Ergebnisse und haben Schwierigkeiten mit dynamischen Mustern. KI-Reviews können durch Halluzinationen des Modells in die Irre geführt werden. Formale Beweise verursachen anfänglichen Aufwand, setzen klare Spezifikationen voraus und erfordern oft eine eingeschränkte Code-Struktur.
Microsofts Forschung zur beweisgestützten Entwicklung zeigt, wie sich formale Methoden pragmatisch in Entwickler-Workflows integrieren lassen: Konzentrieren sich Teams auf kritische Module und leiten Beweise aus ausführbaren Spezifikationen ab, können sie ganze Klassen von Logik- und Nebenläufigkeitsfehlern ausschließen, die Tests entgehen. GitHub AI Scan und vergleichbare Scan-Plattformen ermöglichen die skalierbare, kontinuierliche Erkennung bekannter Schwachstellenmuster und riskanter Abhängigkeiten. Zusammen spricht das für einen hybriden Ansatz: Automatisierte, probabilistische und deterministische Werkzeuge dort einsetzen, wo sie am besten geeignet sind, und die aufwendigen, aber aussagekräftigen formalen Methoden den risikoreichsten Codebereichen vorbehalten.
Für Teams, die Claude Code, Codex, GitHub Copilot oder agentische Workflows einsetzen, lautet die praktische Frage: Wie lassen sich diese Werkzeuge zu einer operativen Pipeline verbinden, die die Produktivität der Agenten erhält und zugleich Fehler und Schwachstellen beherrschbar macht? Im weiteren Verlauf vergleicht dieser Artikel Verifikationsmethoden direkt miteinander, gibt gezielte Empfehlungen für den Einsatz formaler Beweise und stellt einen schrittweisen Workflow vor. Er verbindet automatisierte Code-Erzeugung mit Tests in einer Sandbox, inkrementellen Beweisen und menschlichem Urteilsvermögen – damit die Verifikation ebenso gut mit dem Code-Ausstoß wächst wie die Zahl der Reviewer.