

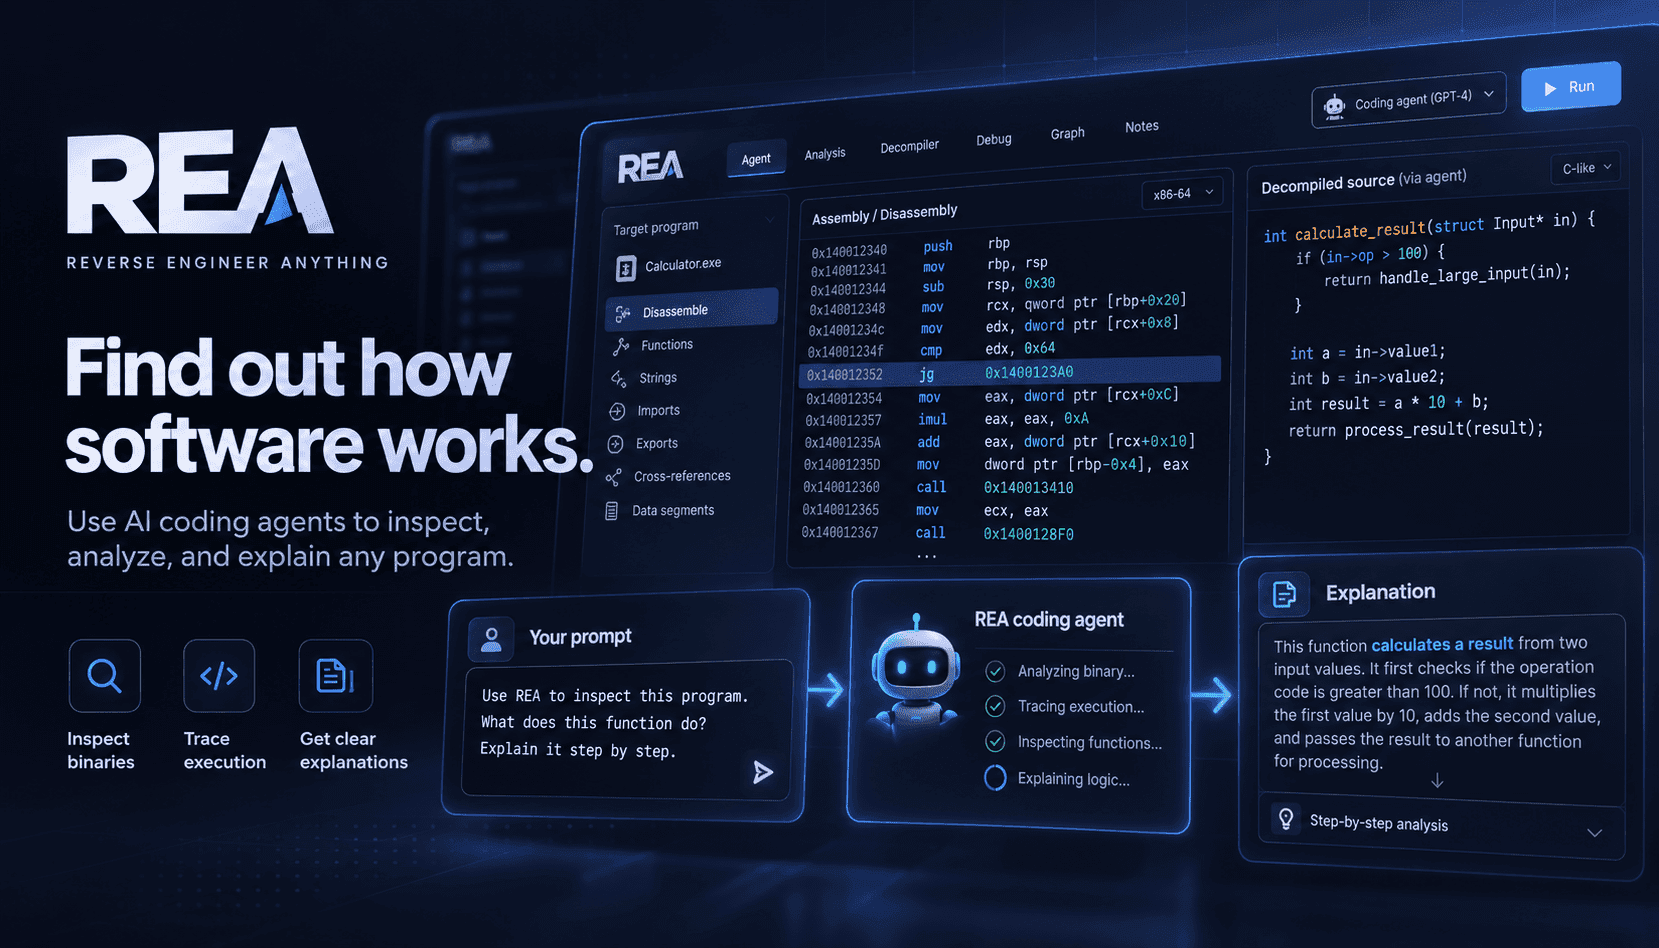
REA (Reverse Engineer Anything) versteht Reverse Engineering neu: als Toolchain, die ein KI-Agent über einen lokalen MCP-Server (Model Context Protocol) orchestrieren kann. Statt dass ein Mensch statische und dynamische Analysewerkzeuge manuell miteinander verbindet, stellt REA Workflows, Belegstrukturen und Provider-Adapter bereit. Damit können Agenten native Analyse-Engines wie Ghidra, Hopper und IDA, JavaScript-/Electron-Parser, .NET-Inspektoren, APK-Dekompilierer und Tools zur Laufzeiterfassung aufrufen. Das Ergebnis ist eine strukturierte Untersuchung: Der Agent stößt einzelne Schritte an, REA liefert nachvollziehbar belegte Ergebnisse, und der Agent leitet daraus Schlussfolgerungen und Anleitungen zur Rekonstruktion ab.
In der Praxis verändert diese Pipeline, wie Teams Funktionen untersuchen, die sie nicht selbst kontrollieren. Ein Agent kann mit einer aufgezeichneten UI-Interaktion beginnen, Netzwerk-Traces und IPC-Grenzen verfolgen, relevante Zeichenfolgen und Ressourcenverweise extrahieren und einen Treffer anschließend mit einer gezielten Binärdatei-Analyse weiter untersuchen. REA verknüpft diese Artefakte mit dekompiliertem Pseudocode und Assembleransichten des konfigurierten nativen Providers, ergänzt Aufruf- und Referenzgraphen und bündelt die Belege, damit der Agent jede Schlussfolgerung begründen kann. Diese Verbindung aus Automatisierung und Belegen macht Rekonstruktionen reproduzierbar und überprüfbar.
Für Teams, die Integrationen, Migrationstools oder Kompatibilitätsschichten entwickeln, ist REAs Local-First-Konzept entscheidend: Die Analyse läuft auf dem Rechner oder in der Infrastruktur der untersuchenden Person – nicht bei einem externen Cloud-Dienst. Das senkt das Risiko einer Datenabflusses und sichert die rechtliche Kontrolle über die analysierten Artefakte. REA unterstützt außerdem verschiedenste Ziele – Websites, Electron-Apps, .NET-Assemblies, Android-APKs, Firmware und rohe Paketmitschnitte. So kann eine einzige Agentenkonfiguration Untersuchungen über den gesamten Bestand an älterer und proprietärer Software hinweg vereinheitlichen.
Der erfolgreiche Einsatz hängt von der Sorgfalt der Anwender ab. Für tiefgehende native Analysen sind weiterhin lizenzierte Versionen von IDA oder Hopper erforderlich, sofern diese zum Einsatz kommen. Außerdem müssen Teams vorab die Berechtigung, den Lizenzstatus und den Umfang der Rekonstruktion dokumentieren. REA enthält eigens Felder für Belege und Einschränkungen, damit sichtbar wird, was beobachtet wurde und was unklar blieb. Unternehmen müssen diese Transparenz jedoch durch eine rechtliche Prüfung und interne Schutzvorkehrungen ergänzen, damit Reverse Engineering auf zulässige Zwecke wie Interoperabilität, Sicherheitsforschung oder die Wartung eigener Software beschränkt bleibt.