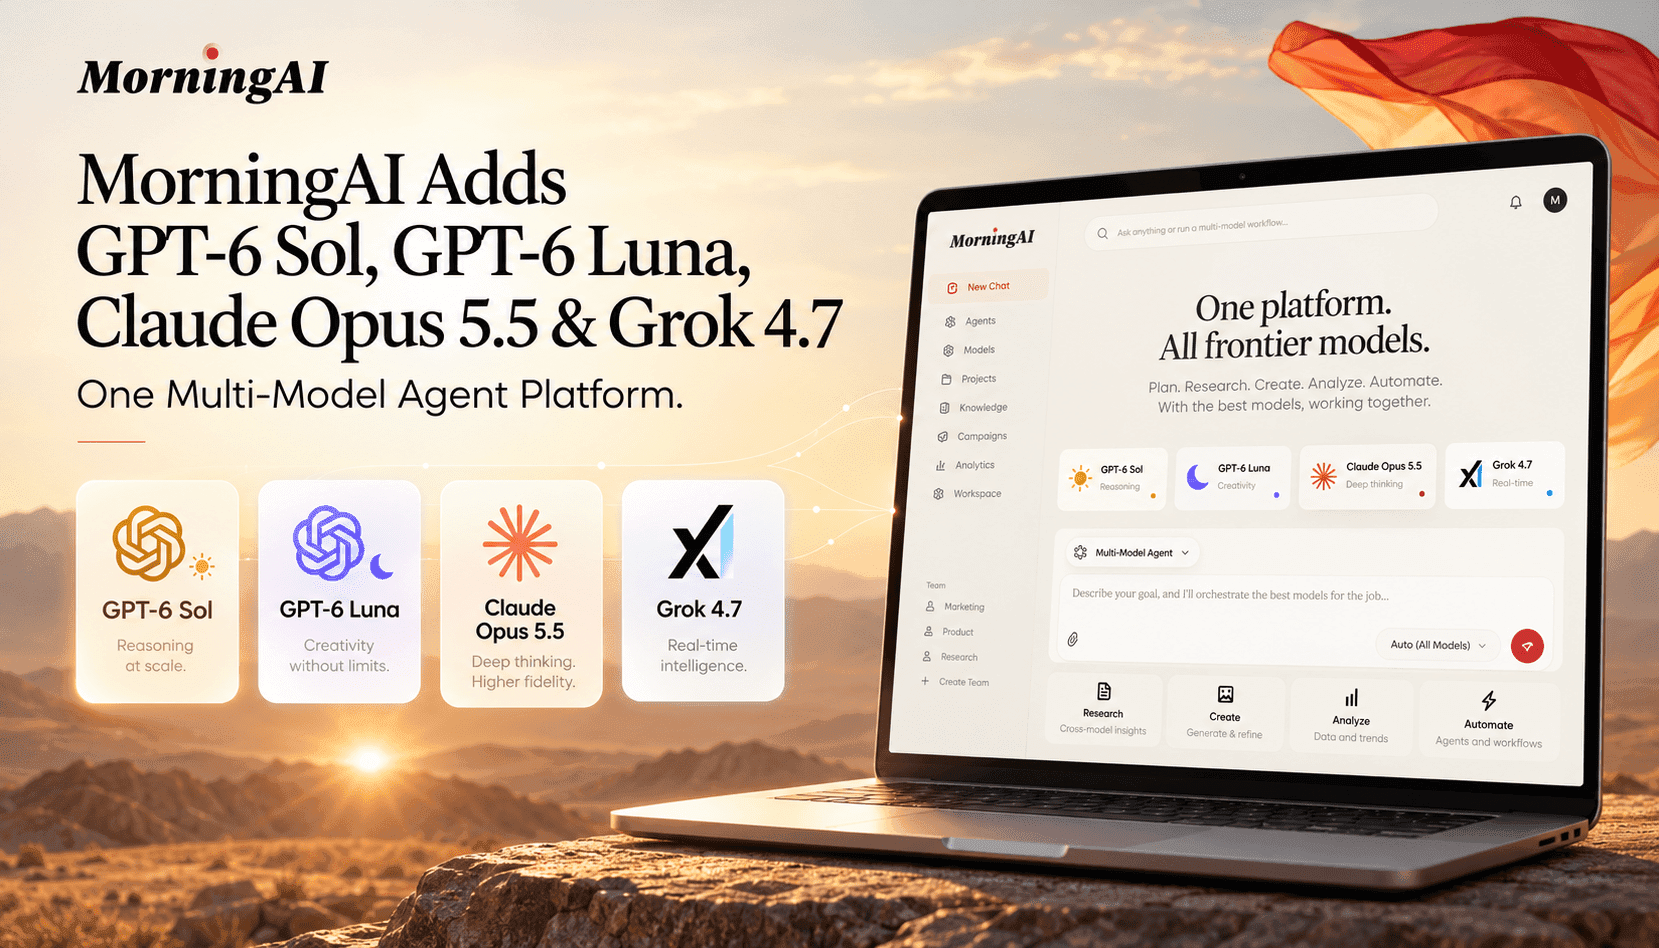
MorningAI ermöglicht Teams jetzt die Auswahl von GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 oder Grok 4.7 in einem einzigen Agenten und das Veröffentlichen von Sanity CMS-Inhalten vom Entwurf bis zur geplanten Veröffentlichung mit Freigaben. Das Update vereint Modellauswahl, Content-Operations und Aufgabenverfolgung in einem Workflow.
Die neueste Version von MorningAI integriert vier Flaggschiff-Modelle – GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 und Grok 4.7 – in einen einzigen Agenten-Composer, während Optionen der vorherigen Generation weiterhin verfügbar bleiben. Das ist wichtig, weil die meisten Teams kein Modell für alle Fälle brauchen; sie benötigen eine verlässliche Möglichkeit, den passenden Motor pro Aufgabe zuzuweisen, ohne Kontextverlust oder Workflow-Reibung. Die Plattform merkt sich Ihre Auswahl, sodass Sie Entscheidungen für wiederkehrende Aufgaben standardisieren und gleichzeitig bei Bedarf schnell wechseln können, wenn Geschwindigkeit, Budget oder Tiefe sich ändern.
Die zweite Säule ist die durchgängige Sanity CMS-Verwaltung. Agenten können Entwürfe erstellen, überarbeiten, Bilder hinzufügen oder austauschen, planen und veröffentlichen – alles eingebettet in Freigabeprozesse. Statt Inhalte zwischen verschiedenen Tools zu verschieben, bleiben Autoren und Operatoren in einem einzigen Thread, um von der Ideenfindung bis zum geplanten Beitrag zu gelangen. Dabei geht es weniger um Neuheiten, sondern um verlässlichen Durchsatz: weniger Übergaben, klarere Status und einfachere Prüfungen, wenn die Führung wissen möchte, was veröffentlicht wurde, warum und mit welchem Modell die Arbeit unterstützt wurde.
Für Operatoren bedeutet das vor allem Kontrolle. Sie können die Modellauswahl an die Absicht anpassen (Abwägung zwischen Genauigkeit und Geschwindigkeit), Überprüfungsschritte in Freigaben festlegen und das Timing im Kalender steuern. Der neue Aufgabenbereich fügt sich in diesen Rhythmus ein, sodass Teams koordinieren können, wer was übernimmt, ohne den Agenten zu verlassen. Die verbleibende Arbeit betrifft Governance: Definieren Sie, welche Aufgaben für welches Modell geeignet sind, legen Sie Kostenobergrenzen fest und machen Sie Nachprüfungen nach der Veröffentlichung zur Routine. Richtig umgesetzt verwandelt das Update zufällige Chat-Experimente in belastbare, teamweite Content-Operationen.
Was sich geändert hat: Ein Agent, vier Spitzenmodelle
MorningAI zeigt jetzt GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 und Grok 4.7 direkt im Agenten-Composer an, während Modelle der vorherigen Generation in einer separaten Liste erhalten bleiben. Nutzer wählen pro Aufgabe, ohne Arbeitsbereiche neu konfigurieren zu müssen, und MorningAI merkt sich die Auswahl, bis sie geändert wird. Das spart Einrichtungszeit und reduziert versehentliche Kontextverluste.
Praktisch können Teams Sol oder Opus für komplexe Planung und Analyse nutzen, Luna für schnelle Entwürfe und Grok, wenn Latenz oder alternative Denkweisen helfen. Die zentrale Auswahl erleichtert es auch, Modellrichtlinien zu standardisieren und Ausgaben über Modellfamilien hinweg zu vergleichen, ohne separate Tools oder parallele Chat-Threads zu erzwingen.
Warum es wichtig ist: Modell passend zur Aufgabe wählen, nicht umgekehrt
Das Update entspricht der Arbeitsweise leistungsstarker Teams: Sie reservieren tiefgehendes Denken für Premium-Modelle und alltägliche Aufgaben für schnellere, günstigere Modelle. Die Einbettung dieser Entscheidung im Agenten-Composer bedeutet weniger ad-hoc-Regeln und konsistentere Umsetzung. Außerdem erhöht es die Evaluationsqualität – A/B-Vergleiche der Ausgaben verschiedener Modelle zum gleichen Briefing, um Baselines pro Aufgabentyp zu setzen.
Erwarten Sie messbare Verbesserungen bei Durchlaufzeiten und Kostenkontrolle, wenn Sie Standardwerte institutionalisiert einsetzen. Zum Beispiel Luna für erste Entwürfe unter 600 Wörtern, Sol/Opus für mehrstufige Recherche und inhaltsstarke Beiträge, Grok für explorative Ideenfindung. Vergleichen Sie im Laufe der Zeit Qualität und Bearbeitungsunterschiede, um das Routing-Handbuch zu verfeinern und ineffiziente Standards auszumustern.
CMS End-to-End: Entwurf, Überprüfung, Planung, Veröffentlichung in Sanity
Agenten können Sanity-Dokumente jetzt vom Konzept bis zur geplanten Veröffentlichung mit integrierten Freigaben bearbeiten. Praktisch kann ein Marketer einen Entwurf anfordern, Ton und Struktur anpassen, Bilder generieren oder austauschen und eine Veröffentlichung planen – ohne den Gesprächsverlauf zu verlassen. Der gleiche Editor öffnet sich für alle Dokumenttypen, die Ihr Sanity-Projekt definiert, und geht über Blogbeiträge hinaus zu Kundenstories oder benutzerdefinierten Inhaltstypen.
Governance macht den Unterschied. Nutzen Sie Freigabeschritte, um Marken-, Rechts- und Barrierefreiheitsprüfungen durchzusetzen; bewahren Sie Prüfbarkeit durch Erfassung von Änderungen, Zeitstempeln und verwendetem Modell. Die Kalenderansicht ermöglicht Teams, geplante Beiträge neben anderen Aufgaben zu visualisieren, was Kollisionen reduziert und klärt, was diese oder nächste Woche veröffentlicht wird.
Implementierungsleitfaden: Einstellungen, Rollen und Rollout
Beginnen Sie mit einer Routing-Matrix: Definieren Sie, welche Inhaltstypen welches Standardmodell verwenden und warum. Legen Sie Kostenobergrenzen pro Arbeitsbereich fest und erzwingen Sie eine zweistufige Freigabe für SEO- oder regulierungssensible Beiträge. Bestätigen Sie in Sanity erforderliche Felder für Titel, Beschreibung, Alt-Text und schema-spezifische Validierungen, damit Agenten keine unvollständigen Inhalte planen können.
Operationalisieren Sie die Messung. Verfolgen Sie die Zeit vom Entwurf bis zur Freigabe, Bearbeitungsanzahlen pro Modell und Verzögerungen von Planung bis Veröffentlichung. Nutzen Sie Aufgaben, um Verantwortliche für Entwurf, SEO-Review und finale Freigabe zuzuweisen. Führen Sie einen zweiwöchigen Pilotversuch mit drei Beitragstypen (Ankündigung, Anleitung, Story) durch, vergleichen Sie Ausgaben über Modelle hinweg und kodifizieren Sie dann Standards und Ausnahmen in Team-Playbooks.
Risiken und Kontrollen: Marke, Drift und Kostendisziplin
Multi-Modell-Freiheit kann die Stimme fragmentieren und Kosten in die Höhe treiben, wenn sie unkontrolliert bleibt. Mildern Sie das mit Tonvorlagen, Stilprüfern und einer verpflichtenden menschlichen Überarbeitung für hochwertige Inhalte. Überwachen Sie Modellupdates, die das Verhalten verändern; planen Sie vierteljährliche Bewertungen, um sicherzustellen, dass die Routing-Matrix noch gültig ist und Modelle der Vorgängergeneration nicht stillschweigend die Ergebnisse verschlechtern.
Kontrollieren Sie die Reichweite im CMS: Beschränken Sie Veröffentlichungsrechte, halten Sie Umgebungsparität (Staging vs. Produktion) ein und ermöglichen Sie Rollback-Muster. Für Kosten setzen Sie Budgetgrenzen pro Modell und Alarmierungen bei Spitzenwerten. Legen Sie schließlich eine Rückfalloption fest: Wenn Planung oder Bildgenerierung fehlschlagen, sollen Aufgaben automatisch einem menschlichen Verantwortlichen mit Kontext zugewiesen werden.