

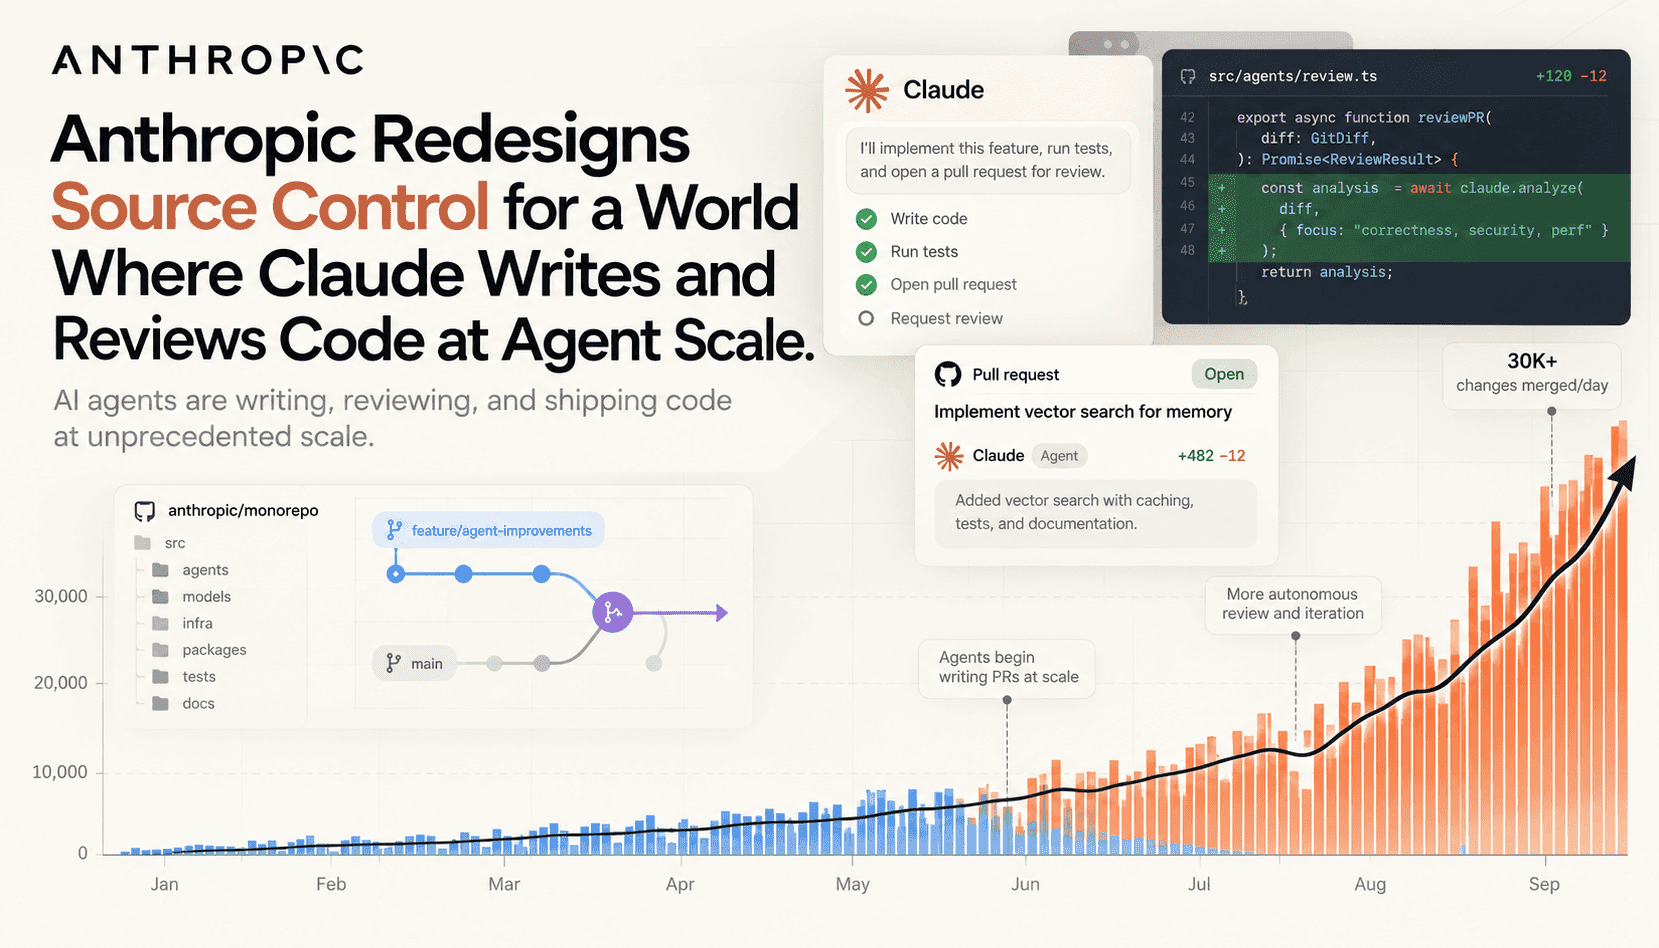
La migración de Anthropic de git a un sistema propio —Scion— fue una respuesta estructural a un punto de inflexión operativo: los agentes autónomos, en particular Claude, empezaron a producir y fusionar decenas de miles de cambios al día, poniendo en jaque los supuestos de herramientas diseñadas para flujos de trabajo humanos. La empresa descubrió que los principios descentralizados —clones completos, intercambio basado en packfiles y referencias locales— se convertían en un lastre cuando la mayoría de los clientes eran agentes conectados que solo necesitaban partes de un repositorio. Scion replantea el problema como uno de metadatos de alto rendimiento gestionados por el servidor y distribución selectiva de archivos. Ese cambio de perspectiva tiene consecuencias para el diseño de pipelines, la supervisión del estado y la auditoría de cambios.
En esencia, Scion sustituye las operaciones sobre el grafo completo de git por conjuntos de cambios en el servidor e índices derivados de esos conjuntos. En lugar de enviar packfiles inmutables a cada cliente, Scion ofrece blobs direccionados por contenido, solicitudes de árboles específicas y API de servidor para consultar blame, ascendencia y diferencias. La copia de trabajo es opcional: los procesos de CI y las tareas de investigación pueden consultar los metadatos en el servidor o materializar únicamente las rutas que necesitan leer. Esto reduce drásticamente el uso de red, CPU y almacenamiento, y permite crear commits de forma rápida y sin bloqueos, algo esencial cuando el número de fusiones diarias aumenta en un orden de magnitud.
En la práctica, este cambio obliga a replantear las herramientas: CI, revisión de código, IAM y observabilidad deben partir de un sistema de control de versiones centrado en el servidor. Las descargas y compilaciones pasan a ser patrones de lectura basados en caché, atendidos por servidores en varios niveles, en vez de clones masivos desde réplicas. Los datos derivados (índices de blame, historiales de rutas y listas de saltos) deben calcularse y almacenarse de forma incremental; decidir si se calculan de manera anticipada o bajo demanda afecta directamente a la latencia, el almacenamiento y los costes operativos. Los equipos tendrán que rediseñar la inicialización de tareas, la experiencia de desarrollo local y la planificación de capacidad, dando prioridad a las cachés de objetos, las descargas reanudables y el aislamiento regional.
Para quienes lideran equipos de ingeniería, las preguntas prácticas son inmediatas: ¿cómo confiar en los cambios generados por agentes a escala?, ¿cómo instrumentar y hacer cumplir las políticas?, ¿cómo evitar crear un único cuello de botella de coordinación? La experiencia de Anthropic demuestra que pueden resolverse combinando la aplicación de políticas en el servidor, interfaces de revisión programáticas, pipelines de validación adversarial y un uso prudente de las referencias. Las concesiones técnicas —menos autonomía local, más cómputo centralizado y nuevas tareas de mantenimiento de datos derivados— se compensan con enormes mejoras en velocidad y reproducibilidad, además de la capacidad de operar a escala de agentes.