

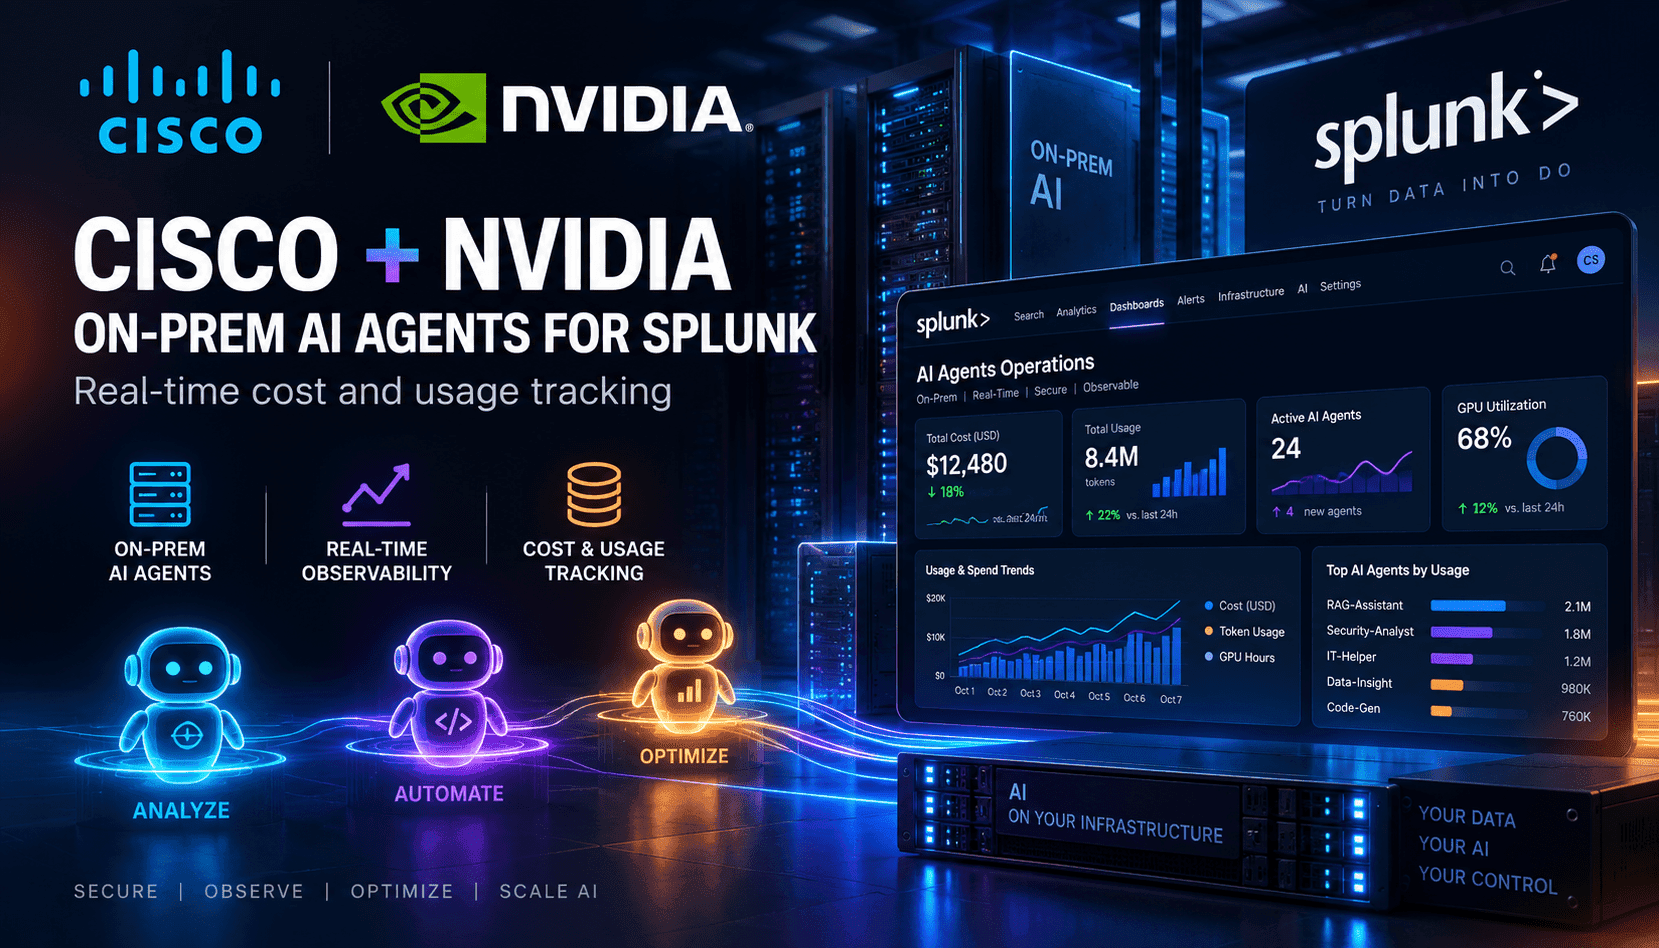
Las empresas que centralizan la telemetría en Splunk han enfrentado durante mucho tiempo un dilema: mantener los datos on‑premise para soberanía y seguridad, o trasladarlos a la nube para acceder a agentes modernos de IA. El nuevo AI POD de Cisco para Splunk, construido sobre computación acelerada por NVIDIA y un entorno Kubernetes, elimina esa brecha. Permite a los equipos ejecutar el Asistente de IA de Splunk y un emergente Agent Launchpad justo al lado de sus registros y métricas, mientras alojan internamente una mezcla de modelos abiertos y propietarios. La pila prevalidada reduce el riesgo de integración y el tiempo para obtener valor, brindando a los equipos de operaciones y seguridad un sustrato de agentes que pueden reforzar con los mismos controles que ya usan para su infraestructura de observabilidad.
El cambio operativo más destacado es la visibilidad de costos y comportamiento. La capacidad de Tokenómica de Splunk Agent Observability rastrea el gasto de tokens por agente, usuario y flujo de trabajo — incluyendo agentes de codificación como Claude Code, Codex o Cursor — para que los líderes puedan vincular la adopción al valor, no a anécdotas. Pronostica el consumo con modelado de series temporales, alerta sobre bucles descontrolados y atribuye costos a las unidades de negocio. Como la misma plataforma inspecciona prompts, respuestas y llamadas a herramientas, los equipos pueden aplicar controles en tiempo de ejecución para bloquear acciones inseguras y reducir al mínimo las alucinaciones. En la práctica, esto significa que puedes establecer presupuestos, prevenir el uso excesivo en tiempo real y demostrar el ROI con economía unitaria en lugar de sorpresas a fin de mes.
Estratégicamente, esta arquitectura acelera la transición de pilotos a una red de agentes gobernada. Al acercar la ejecución del modelo a los datos, las empresas evitan rutas ETL frágiles y reducen la exposición a la salida de datos. La elección del modelo sigue siendo flexible: los equipos pueden ejecutar opciones de pesos abiertos como la familia Nemotron de NVIDIA junto con modelos específicos de dominio como el Deep Time Series Model de Cisco para pronósticos. La contraprestación es la madurez operativa: Kubernetes, programación de GPU, evaluación de modelos y gestión de riesgos en prompts deben tratarse como disciplinas prioritarias. Para los compradores, la pregunta cambia de “¿Podemos usar IA aquí?” a “¿Qué agentes justifican su costo, en qué hardware y bajo qué controles?” Las organizaciones que respondan con precisión escalarán más rápido con menos reescrituras.