

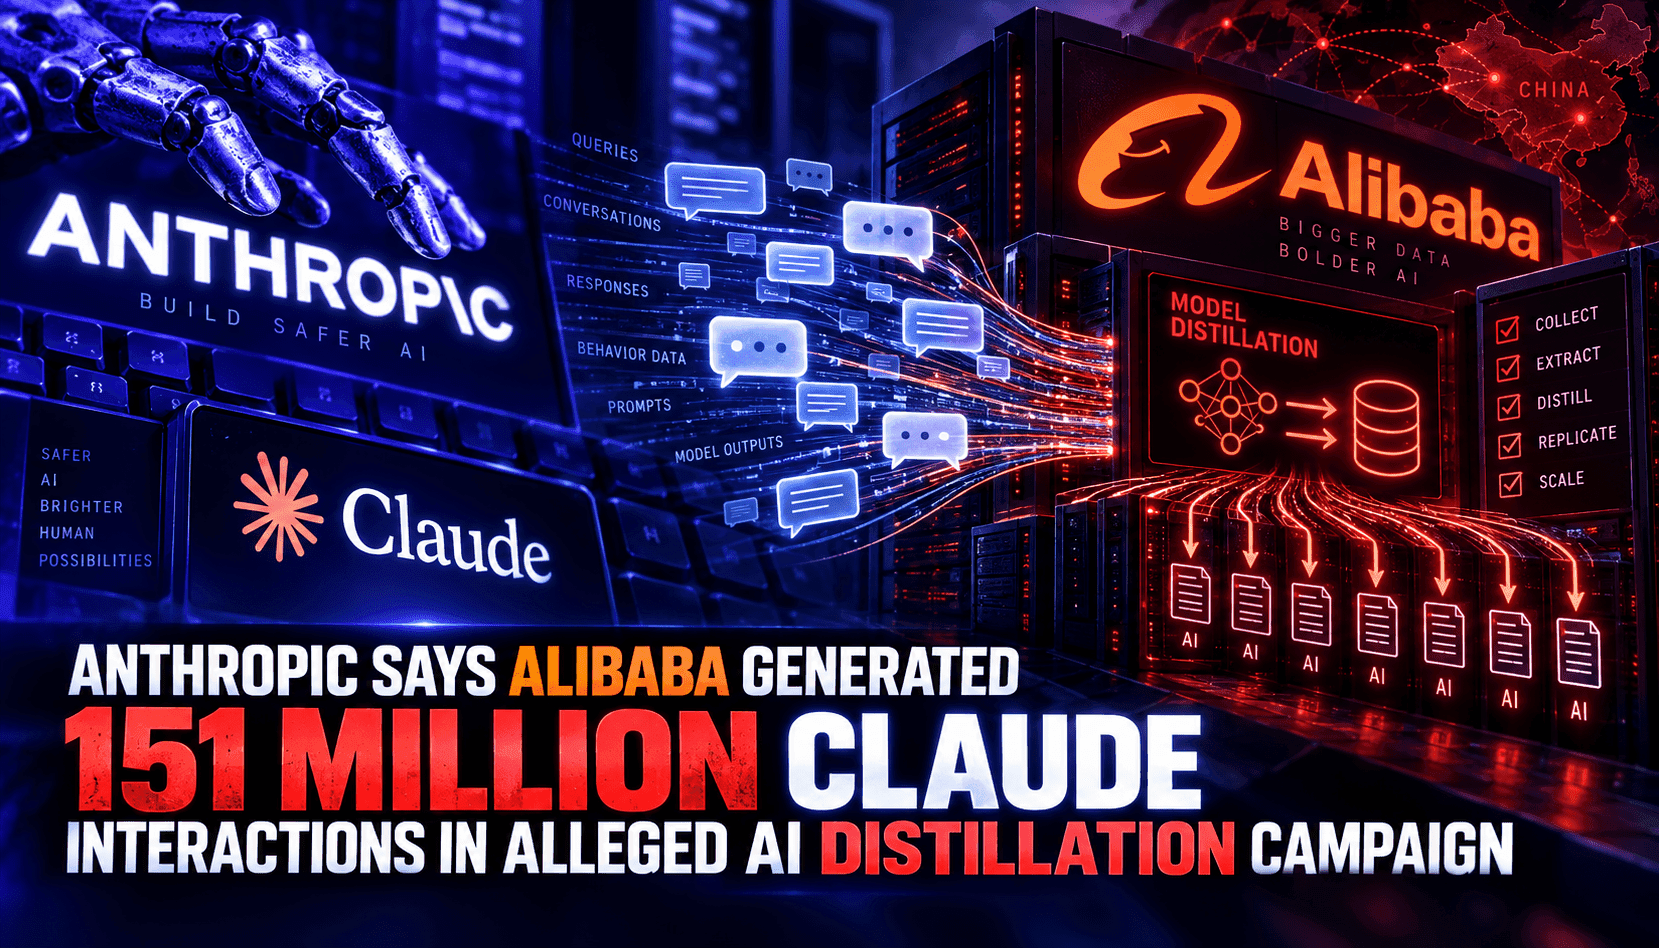
Anthropic affirme que des entités liées à Alibaba ont réalisé environ 151 millions d’interactions avec Claude pour alimenter un flux de travail de distillation à grande échelle — une montée en puissance du scraping sporadique vers une extraction industrialisée. Si cela est exact, ce volume implique une infrastructure d’orchestration : rotation de proxies ou pools d’IP résidentiels, moteurs de mutation de prompts pour éviter la détection par signature, et boucles d’évaluation automatisées pour récolter des sorties à haute valeur. Cela suggère également des couches de mise en cache et une planification adaptative pour exploiter les paliers tarifaires et les fenêtres de latence. Cette affirmation requalifie l’usage abusif des API non pas comme un abus isolé mais comme une chaîne d’approvisionnement : agents coordonnés, ressources cloud et processus de contrôle qualité visant à reproduire le comportement du modèle avec une fidélité acceptable.
La logique économique est simple. Si un attaquant peut convertir des millions d’appels API en un modèle étudiant compétent, il remplace potentiellement des mois de fine-tuning supervisé et de red-teaming. L’arbitrage se situe entre les dépenses API et les heures GPU, l’acquisition de données et les coûts d’alignement évités. Mais à 151 millions d’appels, la télémétrie côté fournisseur devient statistiquement puissante : le timing entre requêtes, la dérive d’entropie des prompts, la diversité des résultats et la corrélation région/IP peuvent révéler des schémas d’automatisation. C’est là que la sécurité des API doit ressembler davantage à la prévention de la fraude aux paiements — combinant empreinte des appareils, regroupement comportemental et limites dynamiques à score de risque plutôt que des plafonds statiques que les orchestrateurs à haut volume peuvent contourner.
Pour les entreprises dépendant de modèles tiers, l’incident souligne des risques de second ordre. Les modèles distillés peuvent hériter des particularités et des lacunes de sécurité du fournisseur, puis être déployés sans garde-fous comparables, augmentant l’exposition à la marque et aux régulations en aval. Parallèlement, les fournisseurs renforceront les conditions, ajouteront des frictions (preuves d’humain, clés éphémères, sous-réseaux privés) et augmenteront la variance dans les domaines sensibles pour réduire la fidélité enseignant-étudiant. Attendez-vous à un marquage plus robuste, des prompts canaris qui identifient les récolteurs, et un accès par paliers exigeant des contrôles de provenance plus stricts pour l’automatisation à haut volume. Les acheteurs doivent se préparer à des exigences de surveillance renforcées, au streaming d’événements de télémétrie d’usage et à d’éventuelles modifications tarifaires à mesure que les fonctions de défense deviendront des contrôles obligatoires plutôt que des options.
Techniquement, se défendre contre une distillation à l’échelle industrielle nécessitera des plans de contrôle multi-couches. À la périphérie : détection d’anomalies au niveau de la passerelle, empreinte TLS et preuve de travail ou attestation en cas de pics suspects. Au cœur : orchestration basée sur le risque liant les scores de risque par locataire aux stratégies de réponse (ralentissement, dégradation, ajout de stochasticité ou défi). Au niveau du modèle : filigranes au niveau des instructions, canaris de réponse et détecteurs entraînés adversarialement pour repérer les prompts de récolte décalés. Enfin, en gouvernance : pistes d’audit, guides d’incidents et renseignement sur les menaces inter-fournisseurs pour empêcher les orchestrateurs sophistiqués de changer de cible sans rencontrer des défenses harmonisées.