

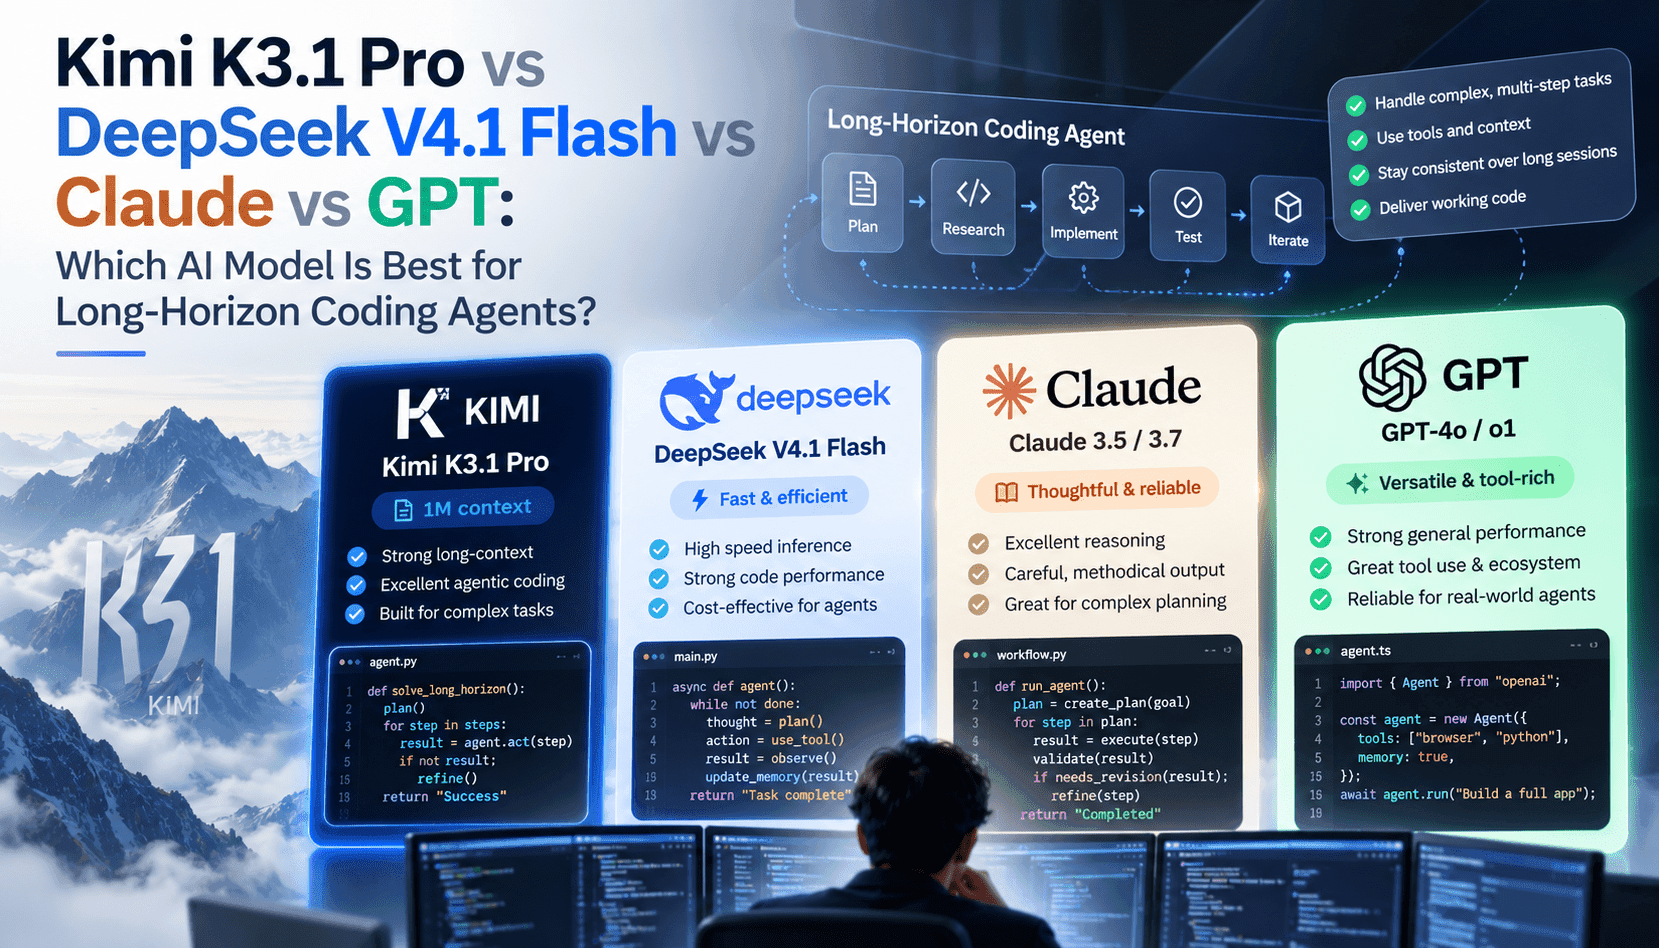
Les agents de programmation conçus pour des tâches de longue durée ne s’évaluent pas selon les mêmes critères que les outils de complétion de code en un seul tour. Ils doivent raisonner de façon cohérente au fil de nombreux appels d’outils, conserver efficacement leur état entre les sessions, gérer les mises à jour différentielles et offrir un coût prévisible par tâche de développement. La fenêtre de contexte d’un million de tokens et les fonctions de mode réflexion de Kimi K3.1 Pro ciblent précisément ce type d’usage ; la variante Flash de DeepSeek privilégie la latence et le débit en streaming, Claude met l’accent sur la sécurité et la maîtrise du raisonnement, tandis que les modèles de la gamme GPT s’appuient sur un vaste écosystème et proposent souvent une boîte à outils conversationnelle de premier ordre. Pour les équipes d’ingénierie, la question n’est pas de savoir quel modèle est objectivement le « meilleur », mais lequel correspond à la taille de leur dépôt, à la cadence de leur CI/CD, à leur budget et à leur tolérance au risque.
Les compromis se dessinent lorsqu’on met les caractéristiques des modèles en regard des workflows des agents. Un contexte d’un million de tokens est utile quand un agent doit raisonner à partir d’un historique couvrant plusieurs modules, de longues spécifications de conception et de résultats cumulés d’appels d’outils — par exemple pour des refontes réparties sur plusieurs demandes de fusion ou des migrations entre dépôts. Mais cette capacité n’a de valeur que si l’agent compresse le contexte de façon sélective, s’appuie sur la génération augmentée par récupération et exploite la mise en cache des sessions pour ne pas transmettre de tokens inutiles. Une inférence plus rapide (K3.1 Pro Highspeed ou DeepSeek Flash) réduit le temps d’exécution et l’attente des développeurs ; toutefois, le coût par token, la taille des lots et les frais d’E/S déterminent si ces modèles plus rapides permettent réellement de réduire les dépenses en production.
Les modèles à poids ouverts changent les calculs de déploiement : les équipes peuvent exécuter les agents sur du matériel privé, contrôler la télémétrie et éviter la dépendance à un fournisseur. En contrepartie, elles héritent de contraintes opérationnelles : latence de service, partitionnement des longs contextes et mise à jour des filtres de sécurité. Les modèles propriétaires de pointe permettent encore de gagner du temps : un meilleur raisonnement prêt à l’emploi, des écosystèmes d’outils intégrés et des garde-fous gérés réduisent le travail d’ingénierie. Le bon choix dépend de la priorité de l’organisation : protéger les données et limiter la latence sur site, ou réduire les efforts d’intégration et s’appuyer sur les engagements de niveau de service des fournisseurs pour les mises à jour de sécurité et les améliorations des modèles.
Au-delà des capacités brutes, évaluez le comportement des modèles au sein d’agents utilisant plusieurs outils : prennent-ils en charge des spécifications déterministes pour les appels d’outils, des modes de réflexion structurés, la transmission en continu des résultats des outils et des approbations soumises à autorisation ? Le mode réflexion et les commandes de session de Kimi visent à réduire les hallucinations au fil de workflows prolongés ; les performances de DeepSeek Flash limitent les expirations dans les boucles CI serrées ; les heuristiques de sécurité de Claude en font un choix intéressant pour les entreprises soumises à des exigences strictes de conformité ; et les modèles de la gamme GPT bénéficient de nombreux connecteurs et de frameworks d’orchestration tiers. Comparez les difficultés d’intégration, la traçabilité et la capacité de récupération de chaque modèle lorsqu’un outil tombe en panne en cours de planification.