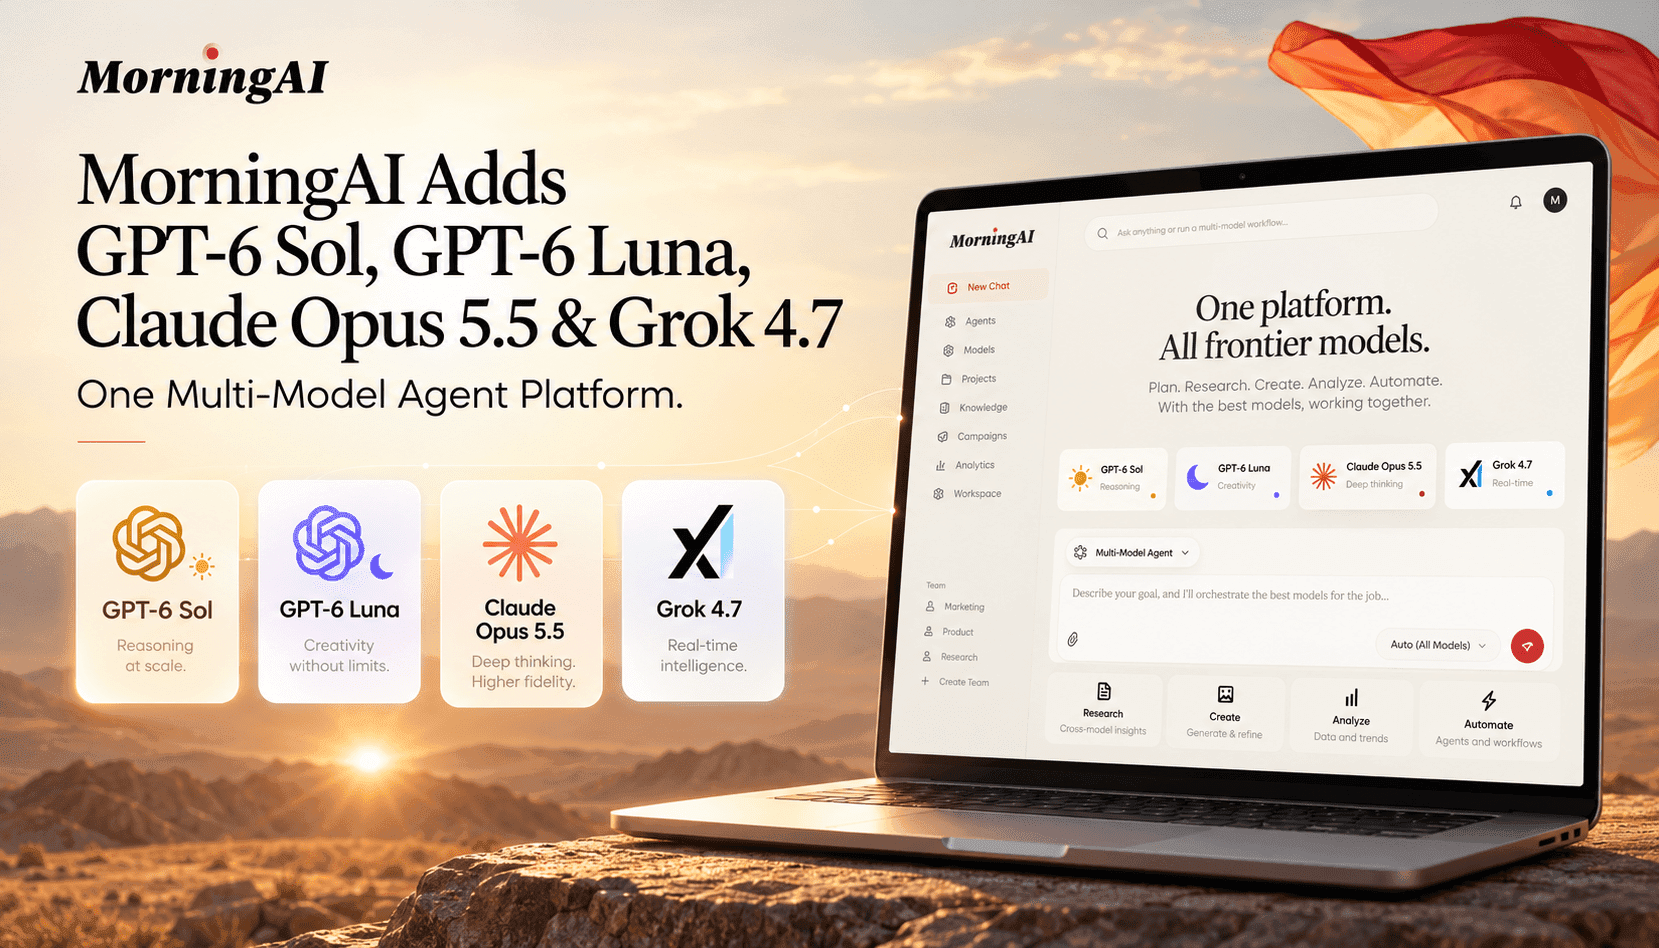
MorningAI permet désormais aux équipes de choisir GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 ou Grok 4.7 dans un seul Agent, et de publier du contenu Sanity CMS de l’ébauche à la publication programmée avec approbations. Cette mise à jour regroupe le choix des modèles, les opérations de contenu et le suivi des tâches en un seul flux de travail.
La dernière version de MorningAI intègre quatre modèles phares—GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 et Grok 4.7—dans un seul compositeur d’Agent, tout en conservant les options des générations précédentes à portée de main. Cela importe car la plupart des équipes n’ont pas besoin d’un modèle universel ; elles ont besoin d’un moyen fiable d’assigner le moteur adéquat à chaque tâche sans perte de contexte ni friction dans le flux de travail. La plateforme mémorise votre sélection, vous permettant de standardiser les choix pour les travaux récurrents tout en changeant à la volée selon la vitesse, le budget ou la profondeur nécessaires.
Le second pilier est la gestion complète du CMS Sanity. Les Agents peuvent rédiger, réviser, ajouter ou remplacer des images, programmer et publier—le tout avec des étapes d’approbation intégrées. Plutôt que de transférer le contenu entre différents outils, rédacteurs et opérateurs restent dans un seul fil pour passer de l’idéation à la publication programmée. Ce n’est pas une nouveauté, mais une garantie de débit fiable : moins de transferts, un statut plus clair et des audits facilités lorsque la direction demande ce qui a été publié, pourquoi, et avec quel modèle en support.
Pour les opérateurs, le grand avantage est le contrôle. Vous pouvez aligner le choix du modèle sur l’intention (raisonnement vs rapidité), codifier les étapes de révision dans les approbations, et gérer le calendrier. La nouvelle zone Tâches s’intègre à ce rythme pour que les équipes coordonnent les responsabilités sans quitter l’Agent. Le travail restant est la gouvernance : définir quels travaux correspondent à quel modèle, ajuster les plafonds de coûts, et rendre les vérifications post-publication systématiques. Bien fait, cette mise à jour transforme les expérimentations dispersées en chat en opérations de contenu durables à l’échelle de l’équipe.
Ce qui a changé : Un Agent, Quatre Modèles de Pointe
MorningAI affiche désormais GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 et Grok 4.7 directement dans le compositeur d’Agent, avec les modèles de génération précédente conservés dans une liste séparée. Les utilisateurs choisissent par tâche sans reconfigurer les espaces de travail, et MorningAI mémorise ce choix jusqu’à modification. Cela réduit le temps de configuration et diminue les réinitialisations accidentelles de contexte.
Concrètement, les équipes peuvent désigner Sol ou Opus pour la planification complexe et l’analyse, utiliser Luna pour les brouillons rapides, et recourir à Grok lorsque la latence ou des styles de raisonnement alternatifs sont utiles. Centraliser la sélection facilite aussi la standardisation des politiques de modèles et la comparaison des résultats entre familles sans imposer d’outils séparés ou de fils de discussion parallèles.
CMS de bout en bout : Brouillon, Révision, Programmation, Publication dans Sanity
Les Agents peuvent désormais prendre les documents Sanity de l’idée à la publication programmée avec des approbations intégrées dans le flux. En pratique, un marketeur peut demander un brouillon, ajuster le ton et la structure, générer ou remplacer des images, et programmer une publication—sans quitter la conversation. Le même éditeur s’ouvre pour tout type de document défini dans votre projet Sanity, allant au-delà des articles de blog vers des témoignages clients ou des types de contenu personnalisés.
La gouvernance fait la différence. Utilisez les étapes d’approbation pour appliquer les contrôles de marque, juridiques et d’accessibilité ; conservez la traçabilité en enregistrant les modifications, horodatages et modèle utilisé. La vue Calendrier permet aux équipes de visualiser les publications en file d’attente avec les autres travaux programmés, réduisant les conflits et clarifiant ce qui sera publié cette semaine versus la suivante.
Guide de mise en œuvre : Paramètres, Rôles et Déploiement
Commencez par une matrice de routage : définissez quels types de contenu utilisent quel modèle par défaut et pourquoi. Verrouillez les plafonds de coûts par espace de travail, et imposez une approbation en deux étapes pour les publications sensibles SEO ou réglementaires. Dans Sanity, confirmez les champs obligatoires pour le titre, la description, le texte alternatif et les validations spécifiques au schéma afin que les agents ne puissent pas programmer de contenu incomplet.
Opérationnalisez la mesure. Suivez le temps entre brouillon et approbation, le nombre d’éditions par modèle, et les écarts entre programmation et publication. Utilisez Tâches pour assigner les responsables du brouillon, de la revue SEO et de la validation finale. Lancez un pilote de deux semaines sur trois types de publications (annonce, tutoriel, récit), comparez les résultats entre modèles, puis codifiez les paramètres par défaut et exceptions dans les guides d’équipe.
Risques et Contrôles : Marque, Dérive et Discipline des Coûts
La liberté multi-modèles peut fragmenter la voix et faire exploser les coûts si elle n’est pas maîtrisée. Atténuez cela avec des modèles de ton, des vérificateurs de style, et une édition humaine obligatoire pour les actifs de premier plan. Surveillez les mises à jour des modèles qui modifient le comportement ; planifiez des évaluations trimestrielles pour vérifier que la matrice de routage tient toujours et que les modèles de génération précédente n’ont pas dégradé silencieusement les résultats.
Contrôlez la portée des impacts dans le CMS : restreignez les droits de publication, maintenez la parité entre environnements (préproduction vs production), et activez les procédures de retour en arrière. Pour les coûts, fixez des budgets par modèle et des alertes en cas de pics. Enfin, établissez un plan de secours : si la programmation ou la génération d’images échoue, les tâches doivent s’auto-assigner à un responsable humain avec le contexte associé.