

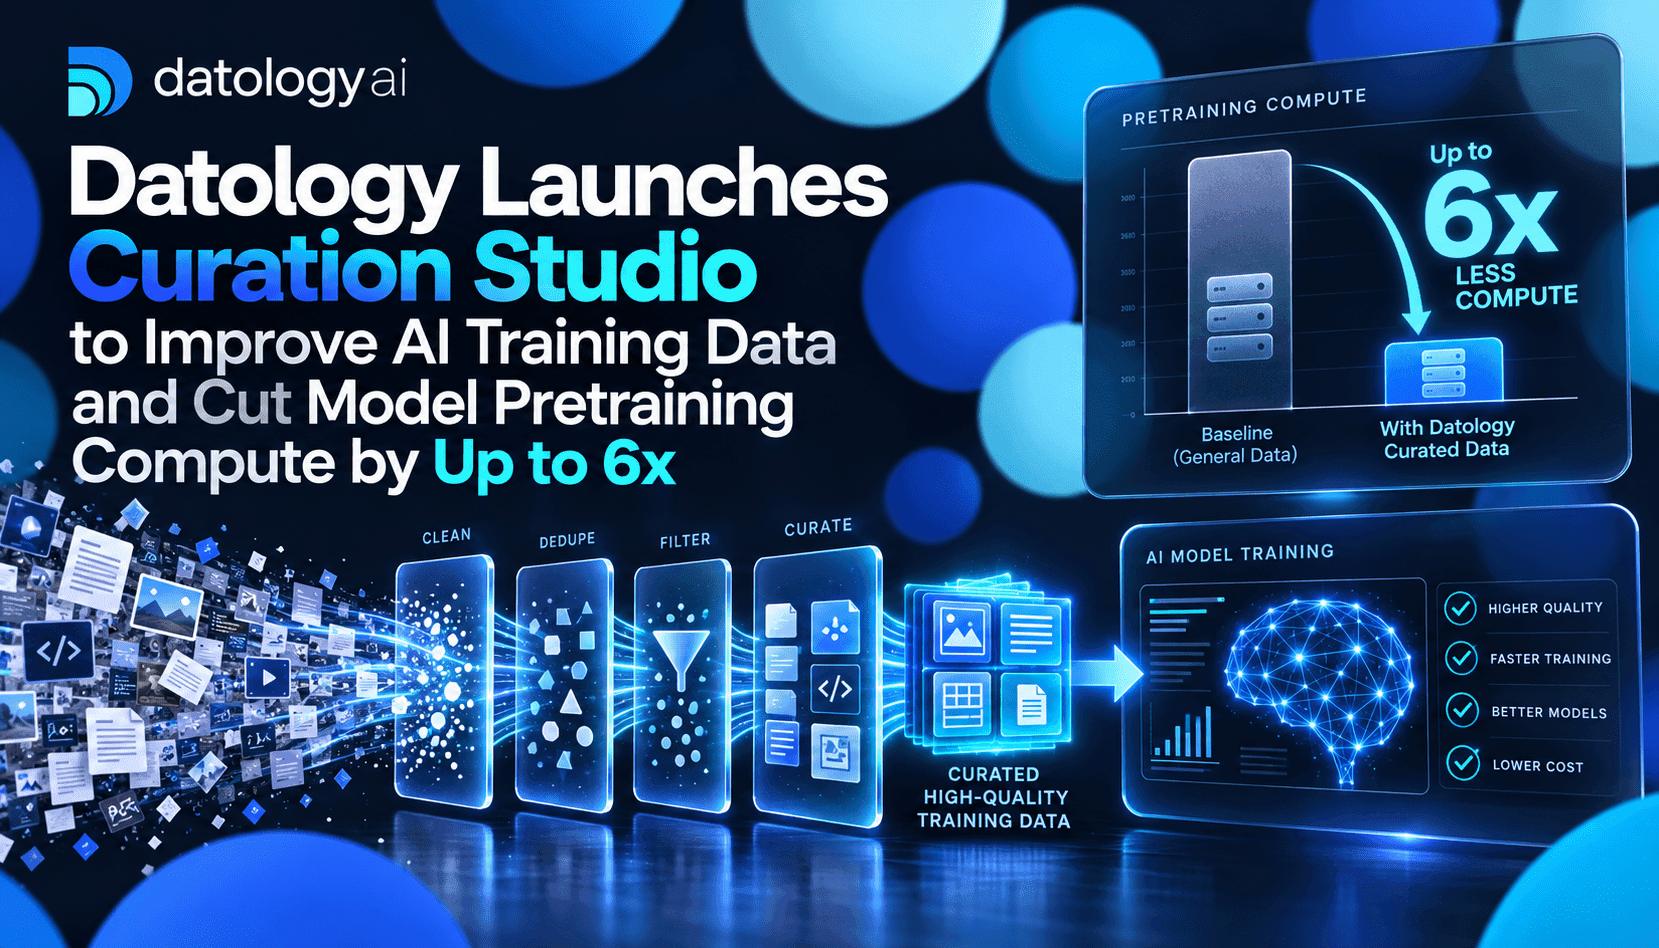
Datologyの新しいCuration Studioは、生のコンテンツとモデル学習の間をつなぐ運用レイヤーとして位置づけられています。単にトークン数を増やしてデータを取り込むのではなく、「Clean(クリーンアップ)」「Calibrate(調整)」「Create(生成)」「Compose(構成)」の4段階のパイプラインを適用し、重視するタスクにとって価値の高い情報を抽出します。このアプローチが重要なのは、事前学習の計算量をむやみに増やすより、学習データをキュレーションするほうが、モデルの実効性能をはるかに効率よく高められることをDatologyの実験が示しているためです。エンジニアリングチームやプロダクトチームにとっては、注力先と予算の配分を見直し、生のGPU稼働時間から、データのライフサイクル設計や合成データの拡張戦略へと軸足を移すことにつながります。
技術の基本的な考え方は目新しいものではありませんが、その実行規模が大きな特徴です。厳密な汚染除去とヒューリスティックなクリーニング、文書ごとのスコアリングと重み付けの調整、高品質なソース例に基づく合成データの生成、そして学習段階に応じてサブセットを組み合わせる設定可能な構成エンジンで成り立っています。Datologyによれば、キュレーション済みデータセットを使うことで、より少ないトークンで学習した小規模モデルが、はるかに多くの計算資源を使って学習した大規模モデルに匹敵、あるいはそれを上回る実験結果が得られたとのことです。実務における直接的な示唆は明快です。事前学習のFLOPsを、より賢いキュレーションのワークフローに振り向ければ、推論コストの低い小型のサービングモデルを実現できる可能性があります。
最先端のキュレーションを企業規模で運用するには、相応のエンジニアリングが求められます。Datologyは、ペタバイト規模のパイプライン、独自のオペレーターグラフ、大量の中間データキャッシュを活用し、数百テラバイトからペタバイト規模の処理を、コストや実行時間を膨張させずに行っていると説明しています。こうした取り組みが、研究室での実験と、顧客のVPC内でチームが運用できる製品との違いを生みます。独自モデルの構築を検討する企業にとって、この製品モデルが重要なのは、データの管理権と来歴を自社で維持し、機密性の高い知的財産を外部サービスに送ることなく、高度なキュレーション技術を活用できるためです。
ビジネス上の価値は、事前学習の計算量あたりのモデル性能と、タスクあたりの推論コストという、測定可能な2つの指標に集約されます。Datologyが示す例では、トークン数を抑えて事前学習したキュレーション済みの12Bモデルが、より多くの計算資源を使った30Bモデルを上回りました。これは、キュレーションによって実運用に適したモデルの規模と学習予算の両方を抑えられることを示しています。意思決定者が得るべき教訓は具体的です。データツールとパイプラインには早い段階から投資し、トークン数だけでなく、計算量で正規化したベースラインと比較して性能を測る実験を設計しましょう。