

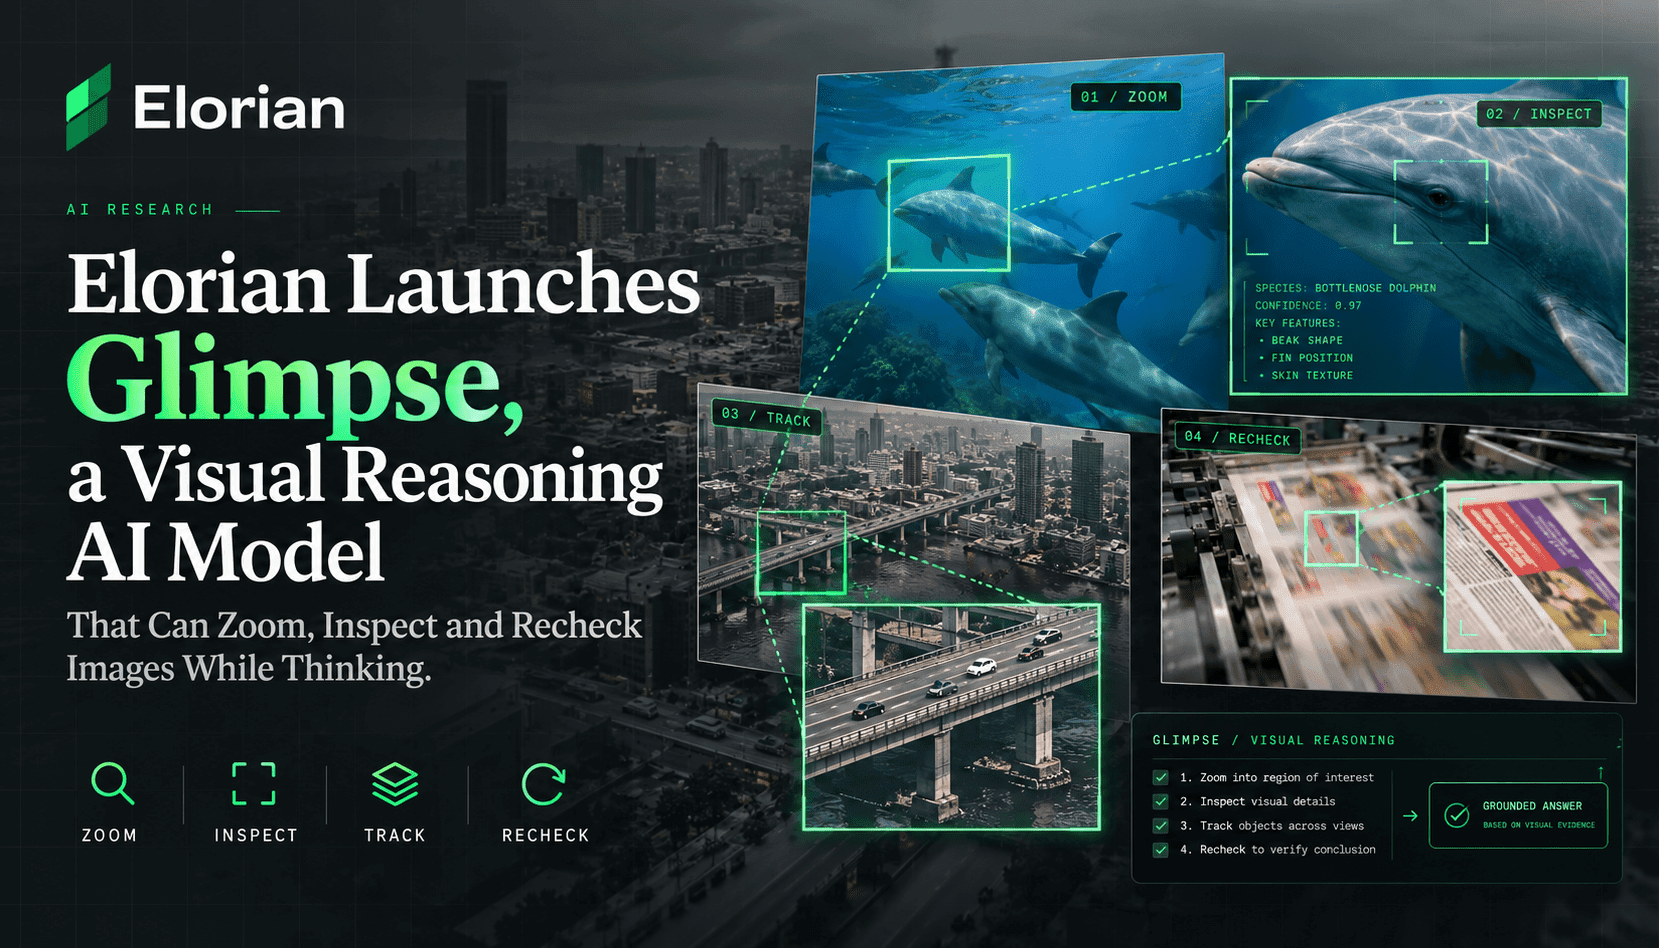
ElorianのGlimpseは、マルチモーダルシステムが視覚入力を扱う方法に、意図的な転換をもたらします。画像や動画を単一の潜在トークン列に圧縮し、その固定された要約をもとに推論するのではなく、Glimpseは推論の過程で何度も見直せる、操作可能な「視覚的スクラッチスペース」を保持します。具体的には、領域を切り出したり、フレームをより細かくサンプリングしたり、時間経過に伴う物体のピクセルを追跡したり、短いコードを実行して中間的な視覚データを生成したりできます。その結果、脆弱な一度きりの認識への依存が減り、曖昧な場面や動きのあるシーンにも強くなります。
システム設計の観点で重要なのは、計算量とトークン予算を、根拠に基づく精度とどう両立させるかです。Glimpseは、単一パスの手法なら記憶を頼りに推測してしまう場面で、証拠を再確認するために推論の計算量を意図的に増やします。Elorianによると、この詳細な見直しにより、対象の同一性を保つタスク、時間的な推論、正確な個数の把握で性能が向上し、特定のベンチマークでは、はるかに大規模な最先端モデルに匹敵、あるいは上回ることもあるといいます。チームにとってGlimpseが特に有望なのは、処理量よりも視覚的な忠実度、追跡可能性、段階的な検証を重視する用途です。
Glimpseの導入には、プロダクト面と研究面のトレードオフがあります。視覚的な証拠に基づいて推論できるモデルを得られる一方で、サンプリングしたフレームやスクラッチスペース上の生成物を管理するなど、オーケストレーションが複雑になり、セッションあたりのトークン費用も増える可能性があります。Elorianが公開しているトークン単価は複数の最先端LLMより大幅に低いものの、同社の説明によれば、モデルが丁寧に推論するほど使用トークン数は増えます。つまりGlimpseは、特定のタスクで証拠の追跡性を高め、認識ミスを減らす可能性がありますが、移行を正当化するには、エンドツーエンドのレイテンシ、判断1回あたりのコスト、統合の複雑さをチームで測定する必要があります。
導入を検討する側にとって、実務上の要点は明快です。視覚的な証拠を見直すことが問題ではなく、むしろ強みになるワークフローでGlimpseを活用しましょう。誤検出や対象の取り違えが大きな損失につながる、ロボットの動作検証、研究室のグラフ解釈、製造品質検査、情報量の多い動画のキャプション作成などに適しています。一方、大量かつ低リスクのタグ付けや、レイテンシが最優先される用途では、トークン効率がさらに向上するまでは、従来型のシングルパス・マルチモーダルモデルのほうが適している場合があります。