

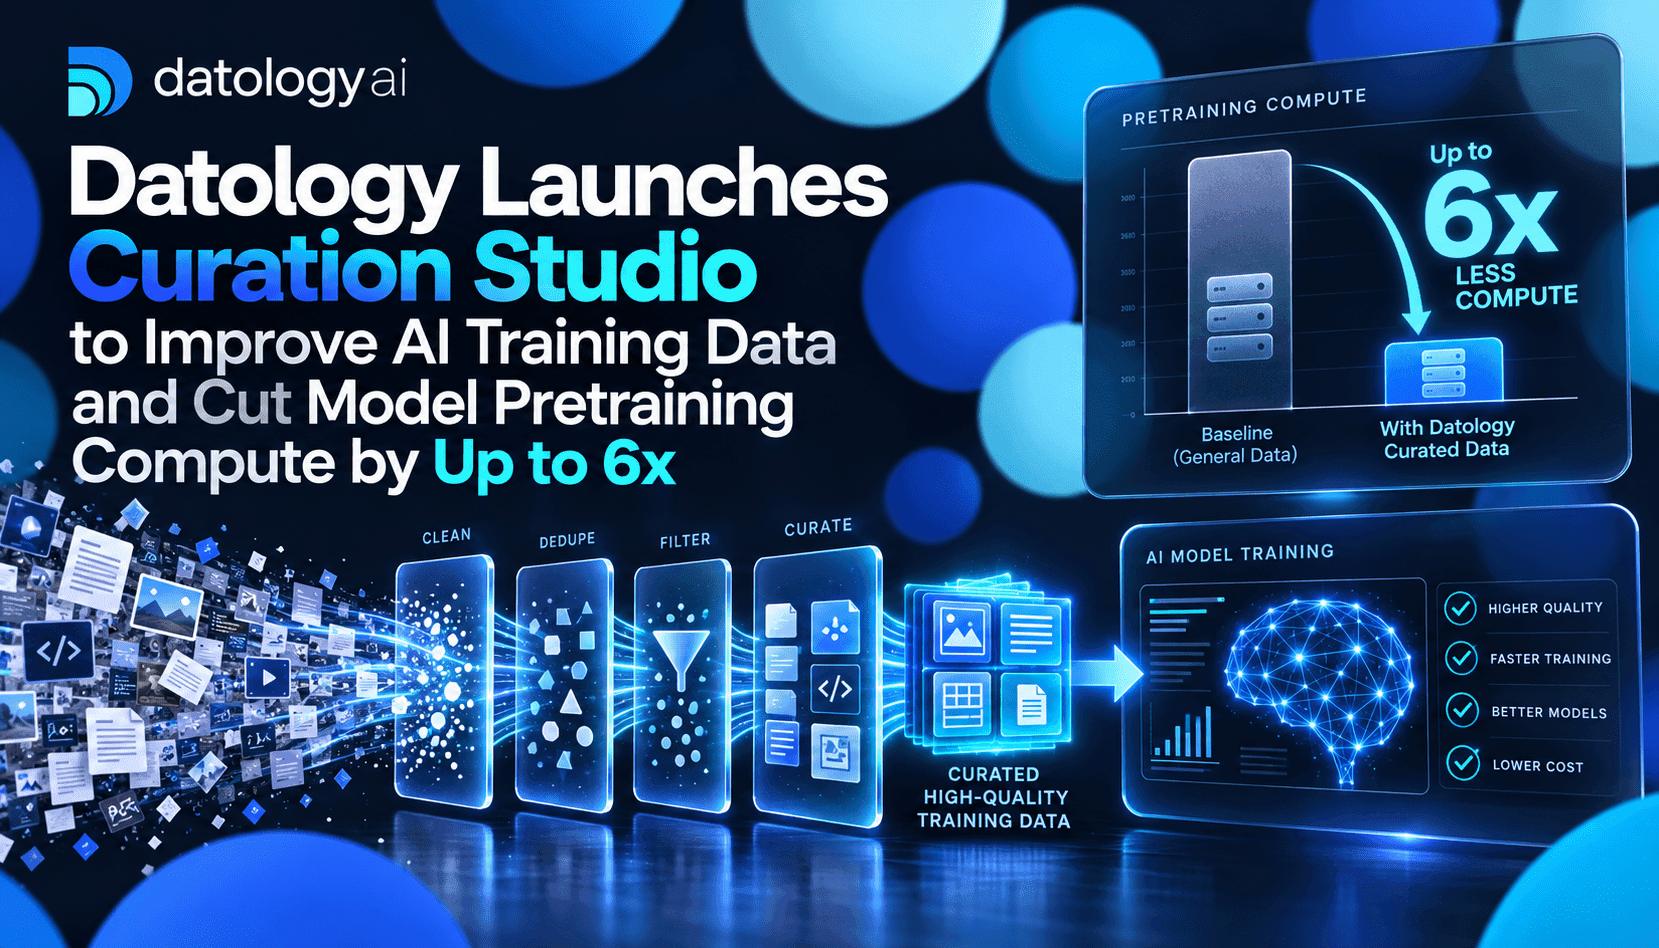
Datology의 새로운 Curation Studio는 원시 콘텐츠와 모델 학습 사이를 잇는 운영 계층으로 자리매김하고 있습니다. 토큰 수를 무작정 늘리는 대신, 이 제품은 ‘정제, 보정, 생성, 구성’의 4단계 파이프라인을 적용해 중요한 태스크에 가장 가치 있는 신호를 찾아냅니다. Datology의 실험에 따르면 사전 학습 컴퓨팅 자원을 무작정 늘리는 것보다 학습 데이터를 선별하는 편이 모델의 실질적인 성능을 훨씬 효율적으로 끌어올릴 수 있습니다. 엔지니어링 및 제품 팀 입장에서는 관심과 예산의 우선순위가 달라진다는 뜻입니다. GPU 사용 시간에만 집중하기보다 데이터 라이프사이클 엔지니어링과 합성 데이터 증강 전략에 투자해야 합니다.
기술의 핵심 원리는 낯설지 않지만 실행 규모가 다릅니다. 엄격한 데이터 오염 제거와 휴리스틱 기반 정제, 문서별 점수 산정 및 가중치 조정, 고품질 원본 사례에 근거한 합성 데이터 생성, 그리고 학습 단계별로 하위 집합을 혼합하는 설정 가능한 구성 엔진이 여기에 포함됩니다. Datology는 큐레이션된 데이터셋으로 학습한 소형 모델이 더 적은 토큰을 사용하고도 훨씬 많은 컴퓨팅 자원으로 학습한 대형 기준 모델과 비슷하거나 더 나은 성능을 보인 실험 결과를 제시합니다. 실무자에게 주는 시사점은 분명합니다. 더 똑똑한 큐레이션 워크플로와 추론 비용이 저렴한 소형 서빙 모델을 선택해 사전 학습 연산량(FLOPs)을 줄일 수 있습니다.
기업 규모로 프런티어급 큐레이션을 운영하려면 상당한 엔지니어링이 필요합니다. Datology에 따르면 이 시스템은 페타바이트 규모의 파이프라인, 맞춤형 오퍼레이터 그래프, 광범위한 중간 결과 캐싱을 활용해 수백 테라바이트에서 페타바이트에 이르는 데이터를 비용이나 실행 시간의 급증 없이 처리합니다. 이런 역량이 실험실 연구와 고객 VPC 안에서 제품 팀이 실제로 운영할 수 있는 솔루션을 가릅니다. 자체 모델 구축을 검토하는 기업이라면 이 제품 모델이 특히 중요합니다. 데이터 통제권과 출처 정보를 유지하고 원시 지식재산을 외부 서비스에 보내지 않으면서도 고도화된 큐레이션 기술을 활용할 수 있기 때문입니다.
비즈니스 가치는 두 가지 측정 가능한 결과에 달려 있습니다. 사전 학습 컴퓨팅 자원 대비 모델 성능과 태스크당 추론 비용입니다. 큐레이션된 12B 모델이 더 적은 토큰으로 사전 학습을 받고도 훨씬 많은 컴퓨팅 자원을 쓴 대형 30B 기준 모델을 앞섰다는 Datology의 사례는 큐레이션을 통해 실제 운영에 필요한 모델의 크기와 학습 예산을 모두 줄일 수 있음을 보여줍니다. 의사결정권자가 주목할 점은 분명합니다. 데이터 도구와 파이프라인에 일찍 투자하고, 토큰 수만 보지 말고 컴퓨팅 자원을 정규화한 기준과 비교해 성능을 측정하는 실험을 설계해야 합니다.