

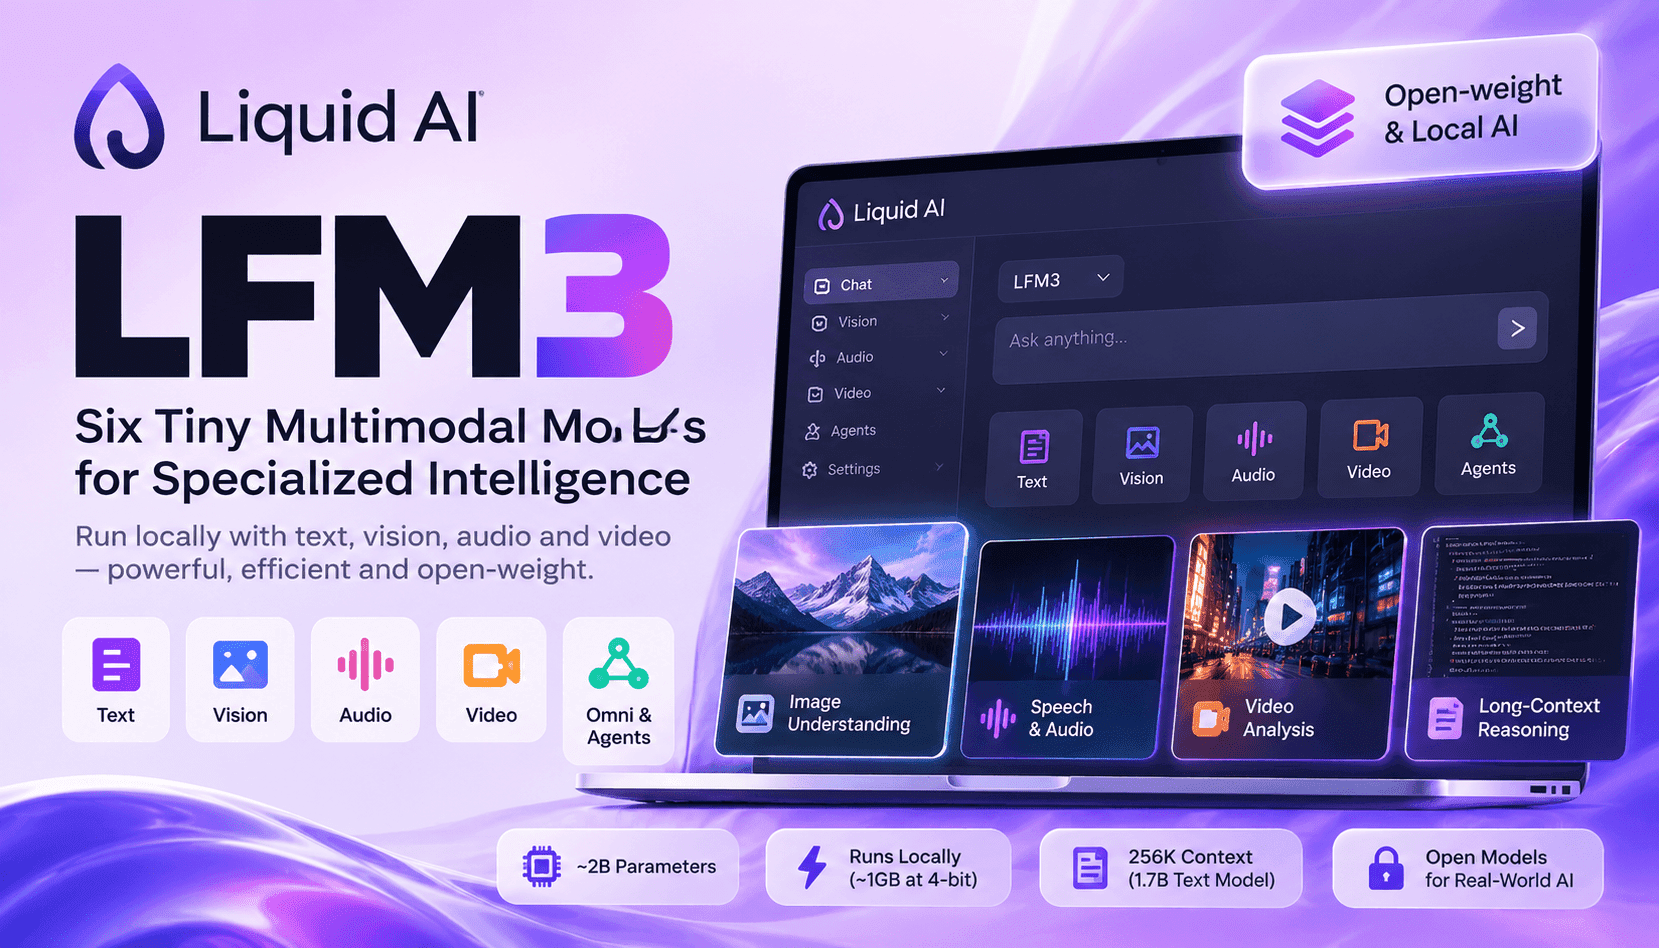
Liquid AI의 LFM3 출시는 실용성을 중시하는 방향으로의 전환을 보여줍니다. 더 큰 범용 모델을 좇는 대신, 하나의 17억 매개변수 백본에서 파생된 6종의 전문 모델 제품군을 만들었습니다. 그 결과 텍스트·비전·오디오·옴니·의사결정 모델을 아우르는, 긴 컨텍스트 처리와 로컬 파인튜닝, 온디바이스 처리량에 초점을 맞춘 최적화된 멀티모달 모델이 탄생했습니다. 실무자에게 중요한 점은 이 구성 전체가 실제 배포 환경의 제약, 즉 제한적인 RAM·플래시 용량, 단일 GPU 학습, 지연 시간에 민감한 대화형 워크로드를 염두에 두고 설계됐다는 것입니다.
기술적으로 LFM3는 게이트형 단축 컨볼루션, 슬라이딩 윈도 어텐션, 선택적 글로벌 어텐션을 결합한 트라이-하이브리드 아키텍처를 채택했습니다. 이 설계는 매개변수당 성능을 높이는 동시에 긴 컨텍스트 처리 비용을 감당할 만한 수준으로 유지합니다. 대표 텍스트 모델인 LFM3-1.7B는 256K 토큰 컨텍스트 윈도를 지원하며, 4비트 형식으로 양자화하면 약 1GB까지 줄일 수 있습니다. 초장문 컨텍스트와 작은 양자화 용량을 함께 제공하므로, 지속적으로 작동하는 백그라운드 에이전트, 대용량 문서 추론, 비공개 환경 내 도구 사용이 가능해집니다. 데이터를 클라우드 API로 보낼 수 없거나 비용 부담이 큰 환경에서 특히 유용합니다.
Liquid AI는 아키텍처 개선에 그치지 않고, 연산량을 줄이는 동시에 비디오와 음성 처리 성능을 높이는 새로운 비전·오디오 인코더도 제공합니다. 비전 모델은 비디오 처리 시 프레임 쌍을 시간 단위로 묶어 시퀀스 길이를 절반으로 줄이고, 오디오 모델은 스트리밍 음성, 다국어 ASR/TTS, 도구 호출 워크플로를 지원합니다. 이들을 함께 활용하면 듣고, 보고, 행동하는 하이브리드 에이전트를 첫 토큰 출력까지의 지연을 낮춰 구현할 수 있습니다. 이는 차량용 대화 어시스턴트, 임베디드 로봇, 멀티모달 데이터를 처리하는 비공개 엔터프라이즈 에이전트에 매우 중요한 특성입니다.
LFM3 도입을 검토하는 팀이 실제로 따져야 할 것은 클라우드 API를 어디서, 어떻게 대체할 수 있느냐는 점입니다. LFM3는 최고 수준의 정확도보다 개인정보 보호, 처리량, 예측 가능한 지연 시간이 중요한 상황에 맞춰져 있습니다. 민감한 데이터를 다루는 엔터프라이즈 어시스턴트, 규제 산업의 온프레미스 자동화, AI PC와 연결이 제한된 엣지 장비의 임베디드 인식 시스템 등이 대표적입니다. 이 리뷰에서는 배포 패턴, 단일 GPU 파인튜닝, 클라우드 모델과의 성능상 절충점, 마이그레이션 과정에서 관리해야 할 운영 위험을 살펴봅니다.